短い答え
PDFの黒塗りを開き、書類を落とし、消すべき語を入力し、意図したものを選び、「取り除く」を押してください。文字はページを描く命令から消され、同じ語がしおり・注釈・フォーム欄・書類のプロパティからも取り除かれ、できあがったファイルは渡される前に目の前でもう一度開かれ、検索されます。
以下はすべて、なぜその最後の一文が大事なのか、そして今使っている道具が同じことを言えるのかどうかを見分ける話です。
ここで言う取り違え
PDFリーダーで氏名の上に黒い四角を描いてみてください。見えるのは、黒い四角の載った氏名です。そしてほとんどのリーダーが保存するのは、その氏名の入った書類と、それとは別に、位置と大きさと色を持つ四角です。
そうやって描かれた四角は注釈です。ページの中ではなく隣に置かれたオブジェクトです。その下の文字はそのままです。その範囲を選んでコピーを押した人も、どんなテキスト抽出器を通した人も、注釈の描き方が違うプログラムで開いた人も、氏名を取り戻せます。画面上でそれを本当の黒塗りと見分けるものは何もなく、まさにそのために、弁護士を抱えている組織でもこれが起き続けています。
それが裁判資料も、情報機関の分析も、契約書も、そして2025年12月には米国司法省文書の大量公開で黒く塗られた氏名も世に出しました。公開から数時間で読めてしまいました。形はいつも同じです。四角は注釈で、注釈は一度も文字だったことがありません。
本当の黒塗りは代わりに何をするのか
PDFの1ページは命令の並びです。このフォントを設定し、ペンをここへ動かし、これらのグリフを描け、というものです。ページ上の語はちょうど1か所だけ、その描画命令の引数として存在します。
BT /F1 12 Tf 72 700 Td (佐藤様) Tj ET氏名を黒塗りするというのは、その文字をその命令から消してページを書き戻すことです。そのあとに取り戻せるものは残りません。ファイルがうまく隠しているからではなく、文字がファイルにないからです。下に何かがある四角はそこになく、下には何もありません。
ひとつだけ戻さなければならないものがあります。そうしないと結果が目に見えておかしくなります。文字はペンをページ上で進めながら描かれるので、5文字消せば行の残りが5文字ぶん左へ寄ってしまいます。表の列はそろわなくなり、合計は違う見出しの下へ滑り込みます。これをきちんとやる道具は、取り除いた文字がペンをどれだけ進めたはずかを測り、その距離を字送りの命令として戻します。それは何も描かずにペンだけを動かします。
黒い箱があるとすれば、それはあとから、すでに空になっている場所に描かれます。書類を読む人への礼儀であり、何かが取り除かれたという合図であって、黒塗りそのものではありません。違いを一文で言えばこうです。本当の黒塗りでは箱は飾りで、偽の黒塗りでは箱こそが黒塗りです。
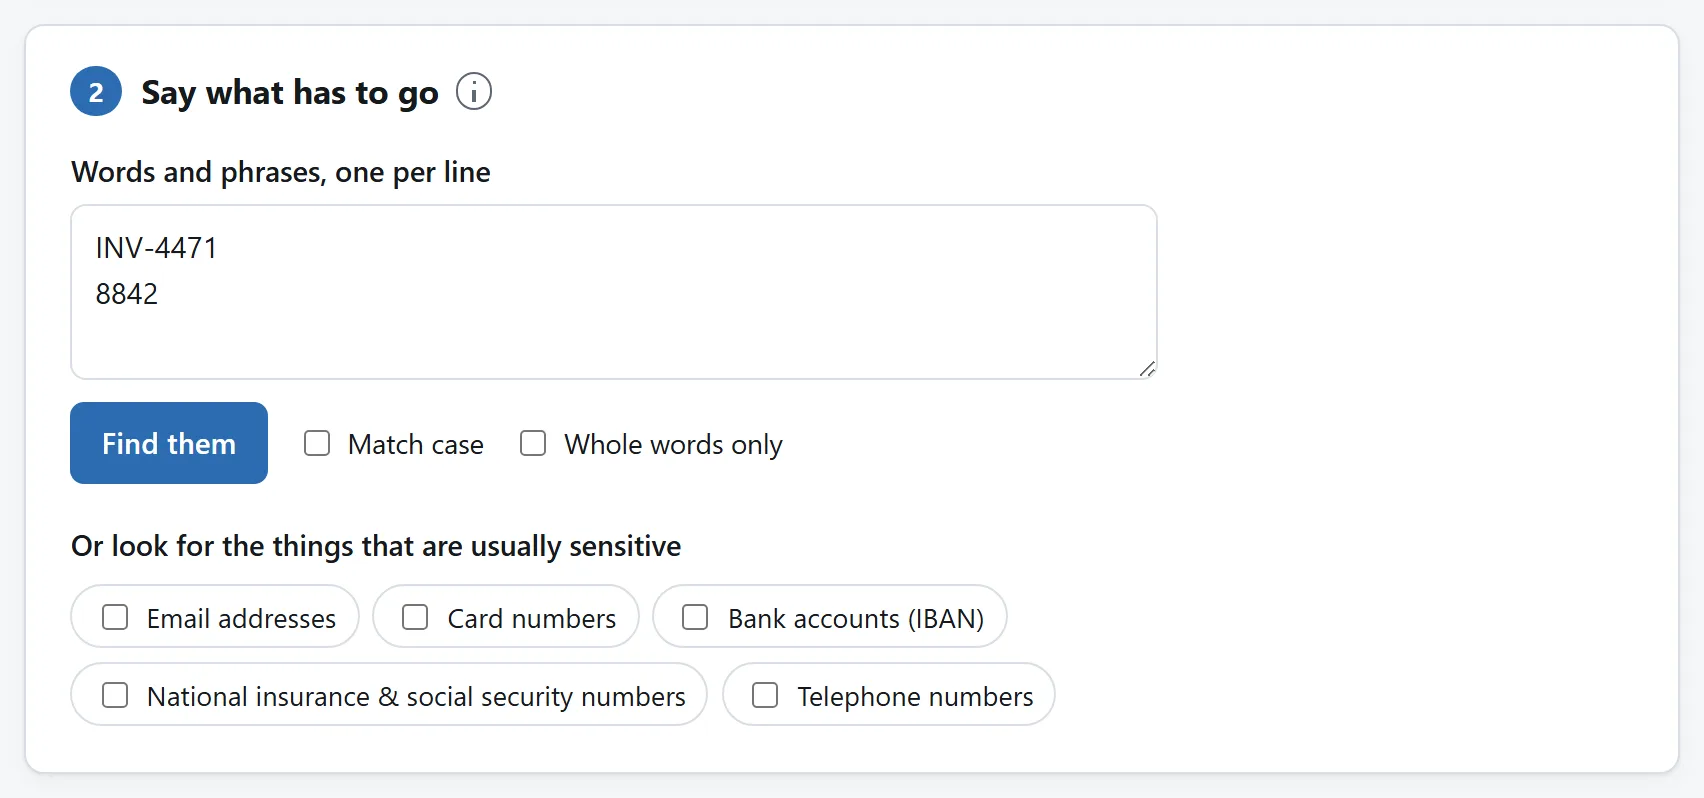
語が隠れているのにページではない4か所
前半をきちんとやった人がつまずくのがここです。PDFは同時に複数の場所に文字を抱えていて、リーダーはそのすべてを表示し、検索し、コピーします。ページから氏名を取り除いてこのどれかに残したなら、取り除いたことになりません。
- 書類のプロパティ。題名、作成者、そしてこれが書き出された元のファイル名です。ページから氏名を取り除いたのに、プロパティにはまだ
佐藤_和解案_3.docxと書かれている書類は、黒塗りされていません。同じ情報の2つめの写しがXMPパケットにあるのがふつうで、そちらも消えなければなりません。 - しおり。リーダーの脇に出る目次は、ページ番号の付いた見出しの一覧で、見出しはページ上の何にも支配されていない1行の文字です。
- フォーム欄と注釈。誰かがフォームに入力したものは2度保存されます。1度はその欄の値として、もう1度はリーダーが描く見た目としてです。どちらも消えなければなりません。付箋は本文と、書いた人の名前を抱えています。
- 置換文字。PDFは、あるグリフの並びが実は別のものを「綴っている」と宣言できます。合字や行末でハイフンで割れた語が、それが表す語としてコピーされるようにするためです。つまり書類は見せるものとCtrl+Cで渡すものを別にできますし、描かれたものだけを取り除いた黒塗りは、段落を選んだ誰にとってもその一文をそのまま残してしまいます。
添付ファイルが5つめです。PDFはほかのファイルを丸ごと抱え込めますし、ページに何をしようとそれには届きません。
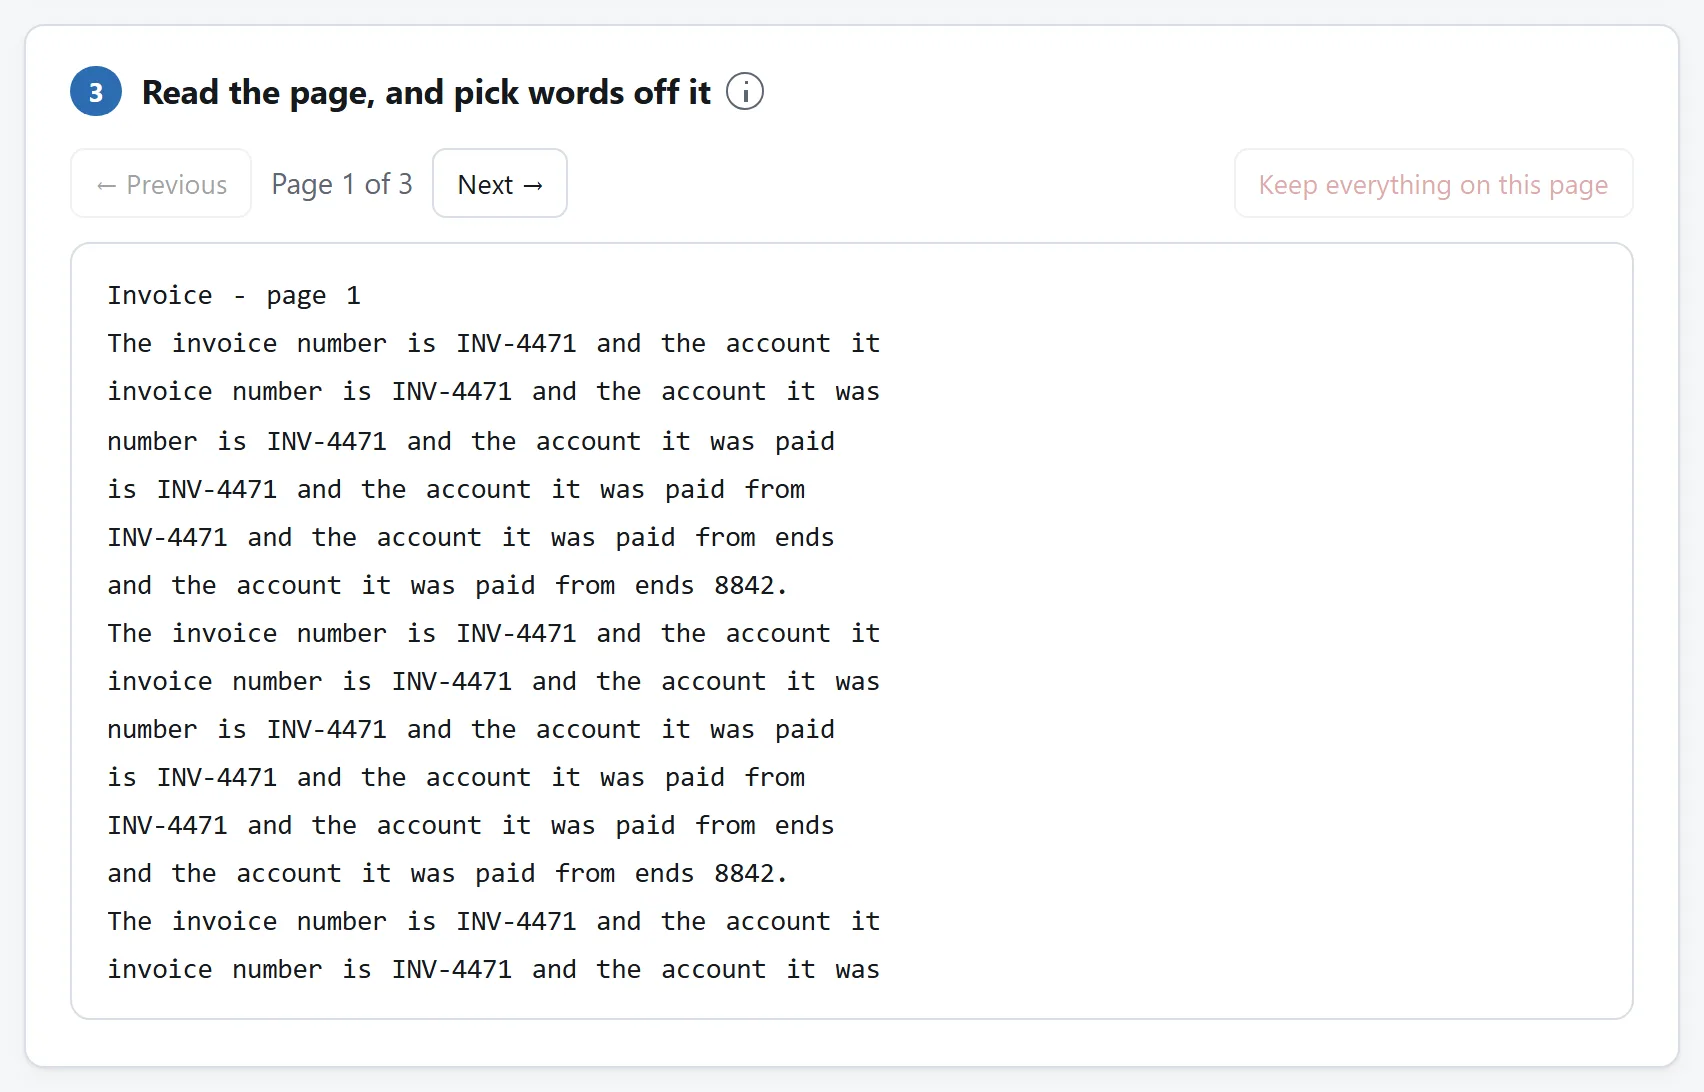
ファイルを30秒で確かめる方法
送ろうとしているものには、どの道具が作ったものであれ、これをやってください。これまでに表沙汰になった取り違えを、どれも捕まえていたはずの確認です。
- できあがったファイルを開いてCtrl+Fを押します(MacならCmd+F)。取り除いた語を検索してください。本当の黒塗りなら何も返りません。リーダーが黒い四角へ飛んだなら、語はまだそこにあって、四角がその上に載っているだけです。
- 黒く塗られた範囲を選んでコピーします。四角の上をドラッグし、Ctrl+Cを押して、どこかのテキスト欄へ貼ってください。何かが届いたなら、同じ取り違えを反対側から見つけたことになります。
- 書類全体を選んで、それもコピーします。Ctrl+AのあとにCtrl+C、どれかのテキストエディタへ貼って、出てきたものを読んでください。3つのうちで飛び抜けて役に立ちます。テキスト抽出器の見るとおりの書類を見せてくれるからで、そこには入っていると知らなかった文字も含まれます。スキャンしたページではよくあります。
- プロパティを見ます。たいていのリーダーではファイル → プロパティです。しおりの欄も見てください。どちらも、ページ上では完璧だった黒塗りのあとにも氏名が生き残る場所です。
PDFの黒塗りは、そのうち1つめと3つめを代わりに行い、件数を見せます。何かを取り除いたという道具の主張は証拠になりませんが、できあがったファイルを検索した結果は証拠になるからです。
スキャンした書類は別の問題です
スキャンはページを撮った写真です。その上の語は文字ではなく画素で、文字の層をどれだけいじってもそこには届きません。文字の層がそもそもないか、あってもそれは画像そのものではなく画像を説明するものだからです。
いまどきのスキャナーやPDFの道具はたいてい、ページを検索できるように、光学文字認識が書いた見えない文字の層を画像の上に足します。その層は本物の文字で、取り除けます。取り除く価値もあります。検索も、コピーも、書類を読む自動の仕組みも、見つけていたのはそれだからです。画像は何も変わらず、ページを見ている人にとって語はそのままはっきり読めます。
ですからスキャンに対する正直な手順はこうなります。まず文字の層から語を取り除き、そのあと画像を別に扱う、つまり画素を上書きするということです。それを行うのが画像の黒塗りで、その隣のガイドが、文字に対してぼかしやモザイクではなぜ足りないのかを書いています。
印刷して取り込み直せばいいのでは
それは通用しますし、代わりにほかのすべてを失います。黒塗りしたページを印刷して取り込み直せば、確かに漏れる文字の層のない書類ができます。そして同時に、誰も検索できず、どのスクリーンリーダーも読めず、大きさが5倍から50倍になり、画質はオフィスのスキャナーの気分次第という書類もできます。それはページが見えていたとおりに印刷されたという前提にも乗っています。注釈は画面には出して紙には出さないと指定でき、あなたの黒い箱がそれだったなら、プリンターから出てきた紙には氏名が載っています。
「画像に統合する」にも同じ理屈が当てはまります。道具によってはそれを黒塗りとして提示します。それはすべてのページをそのページ自身の写真に変えます。語が消されずに覆われていたのなら、その覆いは確かに永久になります。ただし書類のほかのすべても一緒に消えますし、送るファイルは誰も扱えないものになります。
これがいちばんアップロードに向かない仕事である理由
黒塗りのサービスには、黒塗り前のファイルを渡さなければなりません。それが取引の全部です。私的な版がまず丸ごと届き、向こうのディスクに残るのもその版です。プライバシーポリシーに何と書いてあろうと、この順序は動きません。気をつけていたその書類こそ、あなたが手渡したものです。
人が何を黒塗りするのかを考えると、これは聞こえよりも悪い話です。証人の陳述書、診断書、大家に渡す銀行の明細、ある取引先の名前が入ったまま別の取引先へ行く契約書、自宅の住所の載った申立書。それらこそがその書類ですし、だからこそそれを扱う道具の向こう側にサーバーがあってはいけないのです。
このサイトの黒塗りで起きることはすべて手元のブラウザの中で起きます。ファイルは手元の端末で読まれ、書き換えられ、書き出され、確かめられますし、検索した語もこのタブから出ていきません。回線を切っても動き続けますが、それが、どこへも何も送られていないというもっとも簡単な証拠です。アップロードが実際に何を伴うのかはファイルを上げても安全かを見てください。