Como deixar um PDF menor, e por que alguns não encolhem
Um PDF que não cabe no limite do e-mail é quase sempre um PDF cheio de imagens. Aqui está como descobrir se o seu é assim, o que comprimi-lo custa, e por que qualquer ferramenta que promete uma porcentagem fixa não olhou para o seu arquivo.
# Como deixar um PDF menor, e por que alguns não encolhem
Um PDF que não cabe no limite do e-mail é quase sempre um PDF cheio de imagens. Aqui está como descobrir se o seu é assim, o que comprimi-lo custa, e por que qualquer ferramenta que promete uma porcentagem fixa não olhou para o seu arquivo.
[Abrir Compressor de PDF](https://abox.tools/pt/comprimir-pdf/): Encolha um documento sem mandá-lo para lugar nenhum.
Última atualização 26 de agosto de 2026
## A resposta curta
Abra o [Compressor de PDF](https://abox.tools/pt/comprimir-pdf/), jogue o documento dentro e olhe o que ele diz antes de mudar qualquer coisa. Ele lê o arquivo e mostra onde o tamanho realmente está: imagens, fontes, texto e desenho, e tudo aquilo a que nada no documento se refere mais. Essa tela sozinha costuma responder à pergunta.
Se a maior parte do tamanho é imagem, espere uma economia grande. Se são fontes e texto, não espere, e ferramenta nenhuma vai conseguir. Qual dos dois você tem é a história inteira, e vale dez segundos de olhada.
## Onde o tamanho de um PDF realmente está
Um PDF é um contêiner para várias coisas diferentes, e elas não comprimem igual.
- **Imagens.** Fotografias e digitalizações. Quase sempre o grosso de um PDF grande, e a única parte com folga de verdade.
- **Fontes embutidas.** Uma fonte inteira pode ter centenas de kilobytes, e um subconjunto só com os caracteres de fato usados é bem menos. De um jeito ou de outro, elas já foram comprimidas por quem produziu o arquivo.
- **Texto e desenho vetorial.** Instruções em vez de pixels: desenhe esta linha, ponha esta palavra aqui. Já é compacto, e já vem comprimido.
- **Objetos que nada mais aponta.** PDFs acumulam isso. Editar um documento muitas vezes acrescenta a mudança em vez de reescrever o arquivo, então uma versão antiga de uma página pode ficar lá dentro por tempo indeterminado. Reempacotar o arquivo joga esses objetos fora.
Ou seja, os dois documentos que as pessoas levam a um compressor de PDF têm perspectivas completamente diferentes. Um documento digitalizado é essencialmente uma pilha de fotografias, e costuma sair de 60% a 90% menor. Já um contrato, uma tese ou um relatório exportado são texto, desenho e fontes, tudo isso já comprimido pelo programa que escreveu o arquivo, e ali a economia costuma ser de alguns por cento, vinda do reempacotamento e do descarte do que não é referenciado.
Qualquer ferramenta que promete “até 90% menor” sem olhar o seu arquivo está citando o melhor caso do primeiro tipo para o segundo.
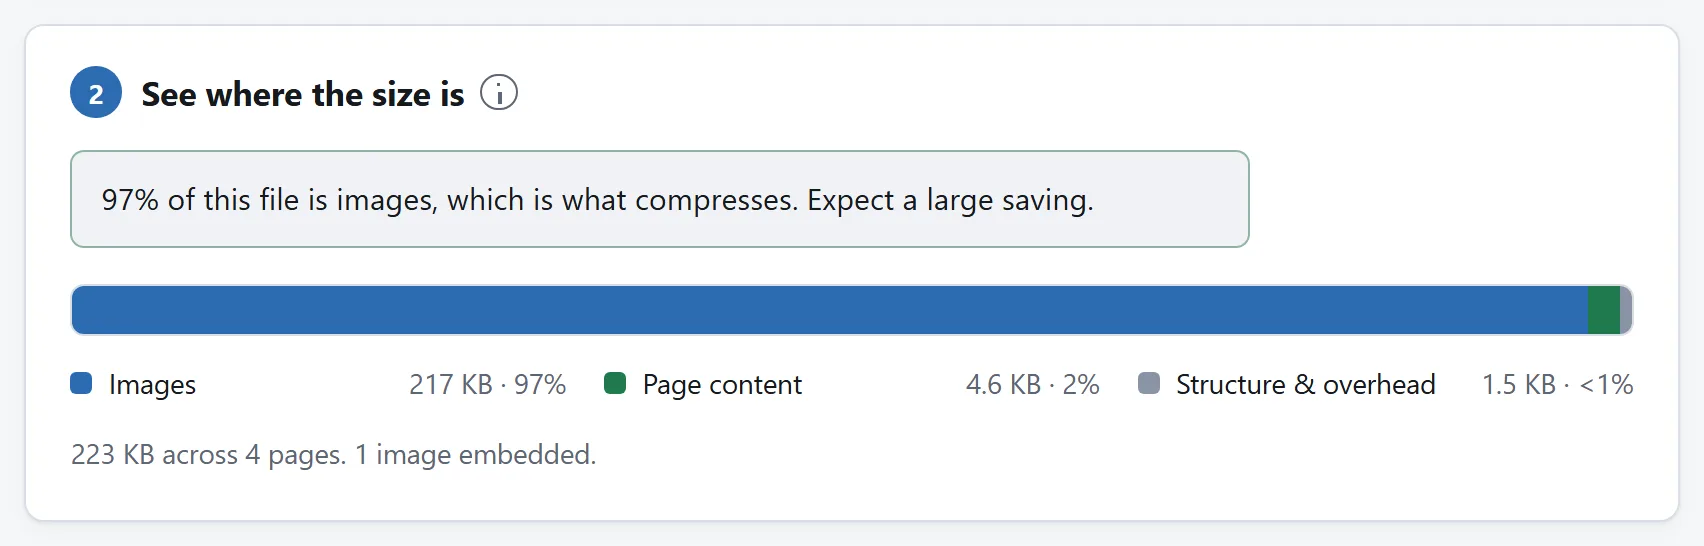
Onde o tamanho está de verdade, antes de mexer em nada. Quase todo PDF grande é grande pelo motivo que essa barra mostra.
## O que o DPI tem a ver com isso
Um PDF não guarda apenas uma imagem; ele registra de que tamanho essa imagem é desenhada na página. Isso rende algo mais útil que a contagem de pixels: a resolução efetiva.
Uma digitalização de 4000 pixels de largura espalhada ao longo de vinte centímetros de papel está carregando 500 pixels por polegada. Uma tela mostra cerca de 100. Uma boa impressora de escritório trabalha a 300 e não consegue usar muito mais. Tudo acima disso é detalhe que nada no futuro do documento jamais vai exibir, e costuma ser a maior parte do arquivo.
É por isso que um compressor de PDF sensato pede um DPI em vez de uma porcentagem de qualidade. Ele joga fora primeiro os pixels acima do seu número, porque esses não custam nada que alguém possa ver, e só então começa a gastar qualidade de verdade.
Guia grosseiro: **150 DPI** para um documento que será lido na tela, **de 200 a 300** para algo que será impresso, e **de 72 a 100** para um rascunho que ninguém vai guardar. Medir contra o tamanho em que a imagem é desenhada também é o motivo de uma logomarca colocada pequena não ser tratada igual a uma digitalização de página inteira, porque a logomarca já está perto da resolução efetiva dela e não há nada a tirar.
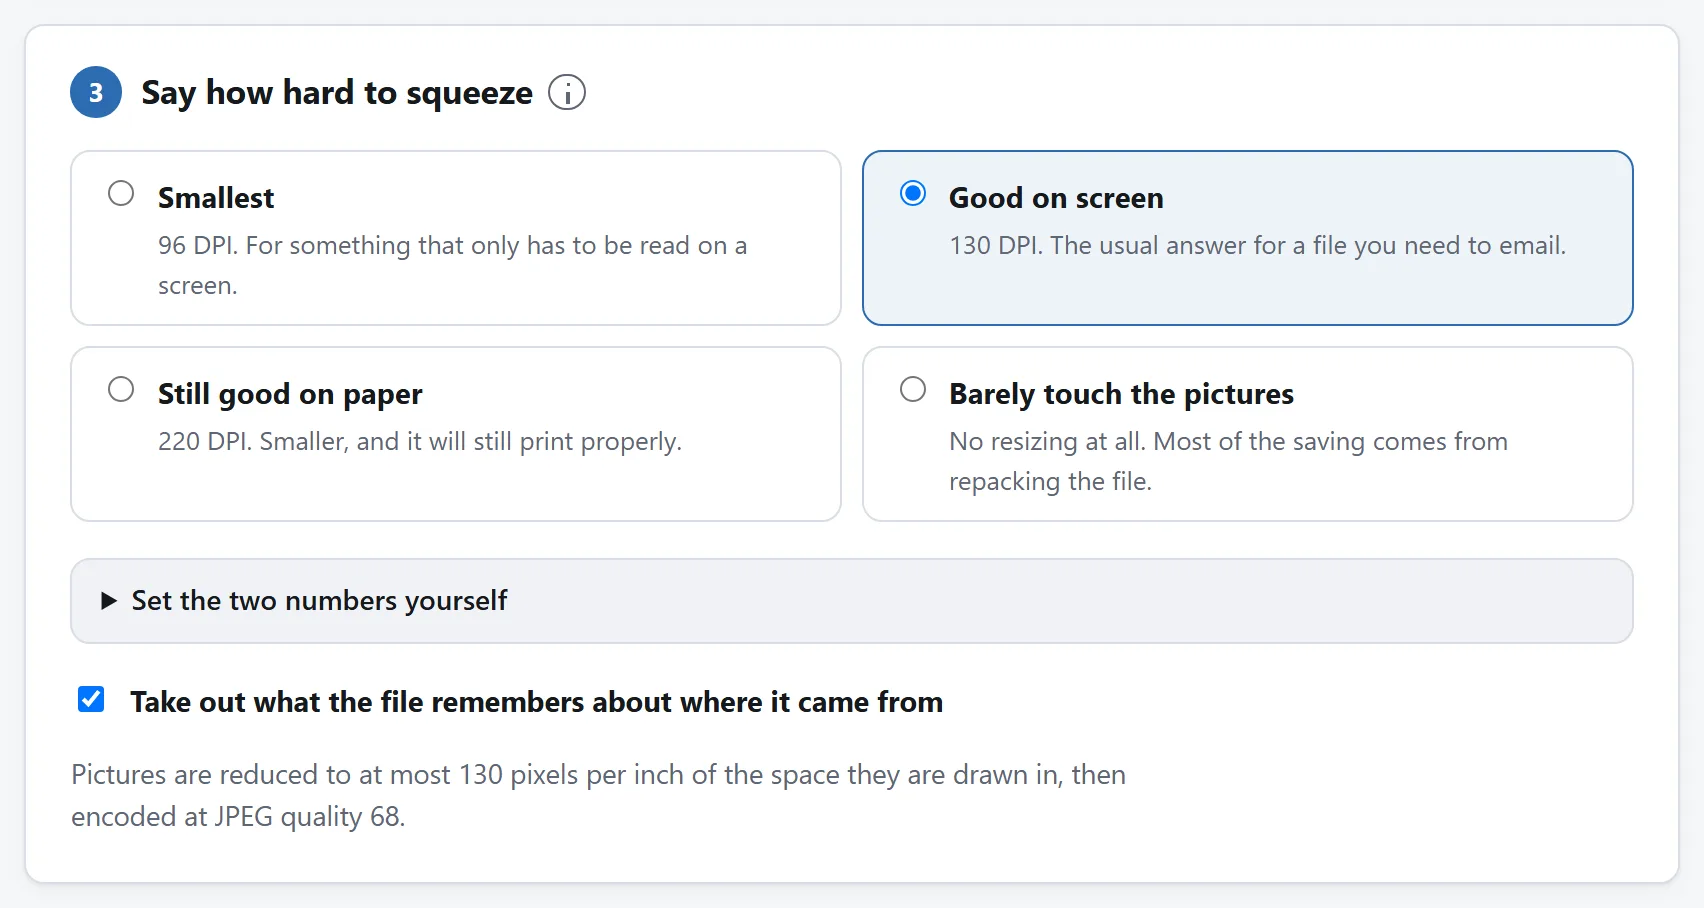
Os dois botões que importam são a resolução e a qualidade. O que cada um faz com uma página de texto e com uma de fotos é o assunto desta seção.
## No que comprimir deve e no que não deve encostar
As imagens são recodificadas, então essas perdem um pouco. Nada mais deveria ser tocado, e vale conferir se a ferramenta que você usa respeita isso:
- **Texto continua texto.** Selecionável, pesquisável, copiável. Um compressor que achata as páginas em imagens vai produzir um arquivo bem pequeno e destruir o documento: você não consegue pesquisar, leitores de tela não conseguem ler, e não há como desfazer.
- **As fontes continuam inteiras.** Substituir fontes muda como o documento aparece no computador de outra pessoa, que é exatamente a coisa que o PDF existe para evitar.
- **Desenho vetorial é copiado exatamente.** Já é pequeno, e rasterizá-lo o deixaria maior e pior ao mesmo tempo.
- **Formulários, links, marcadores, estrutura de acessibilidade e anexos passam adiante.** Essas são coisas fáceis de perder numa reescrita e raramente notadas até alguém precisar de uma.
Uma regra relacionada que um compressor deveria seguir e muitos não seguem: se recodificar uma imagem não sai de fato menor que o original, devolva os bytes originais. Piorar uma imagem sem economia nenhuma é o caso de perda pura, e acontece mais do que se imagina em imagens que já estavam bem comprimidas.
## As imagens que não dá para comprimir
Algumas imagens dentro de um PDF são puladas, e uma boa ferramenta nomeia quais em vez de deixá-las fora da conta em silêncio:
- **Imagens JPEG 2000, JBIG2 e codificadas em fax (CCITT).** Navegador nenhum traz decodificador para nenhuma delas, então passam intocadas. As duas últimas são de dois níveis, só preto e branco, e em geral já estão perto do menor tamanho possível.
- **Imagens CMYK.** Deixadas de lado de propósito. Recodificá-las corre o risco de deslocar as cores que uma impressora produziria, o que é uma coisa surpreendente de se fazer com um documento que alguém vai imprimir.
## Coisas para tentar antes de comprimir
Às vezes o arquivo é grande por um motivo para o qual comprimir é a resposta errada.
**Ele foi digitalizado sem precisar?** Um documento impresso e depois digitalizado é uma pilha de fotografias de texto. Se o original ainda existe em algum lugar como documento, exportar aquilo para PDF vai produzir um arquivo com uma fração do tamanho, e ainda pesquisável.
**Ele foi exportado em ajustes de impressão?** Editores de texto e programas de design costumam ter como padrão uma exportação em qualidade de impressão. Reexportar para tela a partir do arquivo de origem normalmente ganha de comprimir a exportação.
**Ele precisa ser um arquivo só?** O limite do e-mail é por mensagem. Separar um documento de 200 páginas em capítulos às vezes é o conserto honesto.
## Arquivos criptografados, e por que um compressor deve recusá-los
Um PDF protegido por senha é recusado pela ferramenta daqui, e isso é de propósito, não uma função faltando. Vale inclusive quando a senha é vazia, que é como muitos scanners e copiadoras salvam.
Tirar a proteção de um documento é um trabalho diferente de comprimi-lo. Uma ferramenta que fizesse isso em silêncio estaria fazendo algo que você não pediu, num arquivo que alguém trancou de propósito, e devolvendo uma cópia que já não tem a propriedade que aquela pessoa quis dar a você. Se é isso que você quer, tire a proteção antes, de propósito.
## Conferindo o resultado
Abra o arquivo. Olhe as imagens no zoom cheio, confira se o texto continua selecionável e confirme a contagem de páginas.
A ferramenta daqui faz a última dessas coisas por você antes de oferecer o arquivo: ela reabre o documento que acabou de escrever e conta as páginas, no seu próprio computador. Ela também escreve PDF 1.5, que todo leitor lançado desde 2003 entende, então “abre no meu computador” é uma aproximação razoável de “abre no deles”.
## Por que isso não precisa de servidor
Comprimir um PDF soa como trabalho de servidor, e durante a maior parte da vida da web foi mesmo. O que a coisa envolve de fato é interpretar a estrutura do arquivo, achar os fluxos de imagem, decodificá-los e recodificá-los com os codecs que o navegador já traz, e escrever o documento de volta. Tudo isso roda num navegador hoje.
Aqui isso importa mais do que na maioria dos arquivos, por causa do que as pessoas comprimem: contratos, laudos médicos, extratos bancários, documentos de identidade, declarações de imposto de renda. A ferramenta daqui não tem função de rede nenhuma, e a `Content-Security-Policy` da página lista todos os endereços que ela pode acessar, nenhum dos quais é deste site. Carregue, desligue a internet e comprima alguma coisa assim mesmo.
O [É seguro enviar arquivos para conversores online?](https://abox.tools/pt/guias/e-seguro-enviar-arquivos/) traz mais três verificações como essa.
A resposta curta
Abra o Compressor de PDF, jogue o documento dentro e olhe o que ele diz antes de mudar qualquer coisa. Ele lê o arquivo e mostra onde o tamanho realmente está: imagens, fontes, texto e desenho, e tudo aquilo a que nada no documento se refere mais. Essa tela sozinha costuma responder à pergunta.
Se a maior parte do tamanho é imagem, espere uma economia grande. Se são fontes e texto, não espere, e ferramenta nenhuma vai conseguir. Qual dos dois você tem é a história inteira, e vale dez segundos de olhada.
Onde o tamanho de um PDF realmente está
Um PDF é um contêiner para várias coisas diferentes, e elas não comprimem igual.
Imagens. Fotografias e digitalizações. Quase sempre o grosso de um PDF grande, e a única parte com folga de verdade.
Fontes embutidas. Uma fonte inteira pode ter centenas de kilobytes, e um subconjunto só com os caracteres de fato usados é bem menos. De um jeito ou de outro, elas já foram comprimidas por quem produziu o arquivo.
Texto e desenho vetorial. Instruções em vez de pixels: desenhe esta linha, ponha esta palavra aqui. Já é compacto, e já vem comprimido.
Objetos que nada mais aponta. PDFs acumulam isso. Editar um documento muitas vezes acrescenta a mudança em vez de reescrever o arquivo, então uma versão antiga de uma página pode ficar lá dentro por tempo indeterminado. Reempacotar o arquivo joga esses objetos fora.
Ou seja, os dois documentos que as pessoas levam a um compressor de PDF têm perspectivas completamente diferentes. Um documento digitalizado é essencialmente uma pilha de fotografias, e costuma sair de 60% a 90% menor. Já um contrato, uma tese ou um relatório exportado são texto, desenho e fontes, tudo isso já comprimido pelo programa que escreveu o arquivo, e ali a economia costuma ser de alguns por cento, vinda do reempacotamento e do descarte do que não é referenciado.
Qualquer ferramenta que promete “até 90% menor” sem olhar o seu arquivo está citando o melhor caso do primeiro tipo para o segundo.
Onde o tamanho está de verdade, antes de mexer em nada. Quase todo PDF grande é grande pelo motivo que essa barra mostra.
O que o DPI tem a ver com isso
Um PDF não guarda apenas uma imagem; ele registra de que tamanho essa imagem é desenhada na página. Isso rende algo mais útil que a contagem de pixels: a resolução efetiva.
Uma digitalização de 4000 pixels de largura espalhada ao longo de vinte centímetros de papel está carregando 500 pixels por polegada. Uma tela mostra cerca de 100. Uma boa impressora de escritório trabalha a 300 e não consegue usar muito mais. Tudo acima disso é detalhe que nada no futuro do documento jamais vai exibir, e costuma ser a maior parte do arquivo.
É por isso que um compressor de PDF sensato pede um DPI em vez de uma porcentagem de qualidade. Ele joga fora primeiro os pixels acima do seu número, porque esses não custam nada que alguém possa ver, e só então começa a gastar qualidade de verdade.
Guia grosseiro: 150 DPI para um documento que será lido na tela, de 200 a 300 para algo que será impresso, e de 72 a 100 para um rascunho que ninguém vai guardar. Medir contra o tamanho em que a imagem é desenhada também é o motivo de uma logomarca colocada pequena não ser tratada igual a uma digitalização de página inteira, porque a logomarca já está perto da resolução efetiva dela e não há nada a tirar.
Os dois botões que importam são a resolução e a qualidade. O que cada um faz com uma página de texto e com uma de fotos é o assunto desta seção.
No que comprimir deve e no que não deve encostar
As imagens são recodificadas, então essas perdem um pouco. Nada mais deveria ser tocado, e vale conferir se a ferramenta que você usa respeita isso:
Texto continua texto. Selecionável, pesquisável, copiável. Um compressor que achata as páginas em imagens vai produzir um arquivo bem pequeno e destruir o documento: você não consegue pesquisar, leitores de tela não conseguem ler, e não há como desfazer.
As fontes continuam inteiras. Substituir fontes muda como o documento aparece no computador de outra pessoa, que é exatamente a coisa que o PDF existe para evitar.
Desenho vetorial é copiado exatamente. Já é pequeno, e rasterizá-lo o deixaria maior e pior ao mesmo tempo.
Formulários, links, marcadores, estrutura de acessibilidade e anexos passam adiante. Essas são coisas fáceis de perder numa reescrita e raramente notadas até alguém precisar de uma.
Uma regra relacionada que um compressor deveria seguir e muitos não seguem: se recodificar uma imagem não sai de fato menor que o original, devolva os bytes originais. Piorar uma imagem sem economia nenhuma é o caso de perda pura, e acontece mais do que se imagina em imagens que já estavam bem comprimidas.
As imagens que não dá para comprimir
Algumas imagens dentro de um PDF são puladas, e uma boa ferramenta nomeia quais em vez de deixá-las fora da conta em silêncio:
Imagens JPEG 2000, JBIG2 e codificadas em fax (CCITT). Navegador nenhum traz decodificador para nenhuma delas, então passam intocadas. As duas últimas são de dois níveis, só preto e branco, e em geral já estão perto do menor tamanho possível.
Imagens CMYK. Deixadas de lado de propósito. Recodificá-las corre o risco de deslocar as cores que uma impressora produziria, o que é uma coisa surpreendente de se fazer com um documento que alguém vai imprimir.
Coisas para tentar antes de comprimir
Às vezes o arquivo é grande por um motivo para o qual comprimir é a resposta errada.
Ele foi digitalizado sem precisar? Um documento impresso e depois digitalizado é uma pilha de fotografias de texto. Se o original ainda existe em algum lugar como documento, exportar aquilo para PDF vai produzir um arquivo com uma fração do tamanho, e ainda pesquisável.
Ele foi exportado em ajustes de impressão? Editores de texto e programas de design costumam ter como padrão uma exportação em qualidade de impressão. Reexportar para tela a partir do arquivo de origem normalmente ganha de comprimir a exportação.
Ele precisa ser um arquivo só? O limite do e-mail é por mensagem. Separar um documento de 200 páginas em capítulos às vezes é o conserto honesto.
Arquivos criptografados, e por que um compressor deve recusá-los
Um PDF protegido por senha é recusado pela ferramenta daqui, e isso é de propósito, não uma função faltando. Vale inclusive quando a senha é vazia, que é como muitos scanners e copiadoras salvam.
Tirar a proteção de um documento é um trabalho diferente de comprimi-lo. Uma ferramenta que fizesse isso em silêncio estaria fazendo algo que você não pediu, num arquivo que alguém trancou de propósito, e devolvendo uma cópia que já não tem a propriedade que aquela pessoa quis dar a você. Se é isso que você quer, tire a proteção antes, de propósito.
Conferindo o resultado
Abra o arquivo. Olhe as imagens no zoom cheio, confira se o texto continua selecionável e confirme a contagem de páginas.
A ferramenta daqui faz a última dessas coisas por você antes de oferecer o arquivo: ela reabre o documento que acabou de escrever e conta as páginas, no seu próprio computador. Ela também escreve PDF 1.5, que todo leitor lançado desde 2003 entende, então “abre no meu computador” é uma aproximação razoável de “abre no deles”.
Por que isso não precisa de servidor
Comprimir um PDF soa como trabalho de servidor, e durante a maior parte da vida da web foi mesmo. O que a coisa envolve de fato é interpretar a estrutura do arquivo, achar os fluxos de imagem, decodificá-los e recodificá-los com os codecs que o navegador já traz, e escrever o documento de volta. Tudo isso roda num navegador hoje.
Aqui isso importa mais do que na maioria dos arquivos, por causa do que as pessoas comprimem: contratos, laudos médicos, extratos bancários, documentos de identidade, declarações de imposto de renda. A ferramenta daqui não tem função de rede nenhuma, e a Content-Security-Policy da página lista todos os endereços que ela pode acessar, nenhum dos quais é deste site. Carregue, desligue a internet e comprima alguma coisa assim mesmo.

