Comment alléger un PDF, et pourquoi certains ne maigrissent pas
Un PDF qui ne passe pas la limite d'un courriel est presque toujours un PDF plein d'images. Voici comment savoir si c'est le cas du vôtre, ce que le compresser coûte, et pourquoi tout outil qui promet un pourcentage fixe n'a pas regardé votre fichier.
# Comment alléger un PDF, et pourquoi certains ne maigrissent pas
Un PDF qui ne passe pas la limite d'un courriel est presque toujours un PDF plein d'images. Voici comment savoir si c'est le cas du vôtre, ce que le compresser coûte, et pourquoi tout outil qui promet un pourcentage fixe n'a pas regardé votre fichier.
[Ouvrir Compresseur de PDF](https://abox.tools/fr/compresser-un-pdf/): Alléger un document sans l'envoyer où que ce soit.
Dernière mise à jour 26 août 2026
## La réponse courte
Ouvrez le [compresseur de PDF](https://abox.tools/fr/compresser-un-pdf/), déposez-y le document, et regardez ce qu'il vous dit avant de changer quoi que ce soit. Il lit le fichier et montre où se trouve vraiment le poids : images, polices, texte et dessin, et tout ce à quoi plus rien dans le document ne renvoie. Cet écran répond en général à la question.
Si l'essentiel du poids est fait d'images, vous pouvez espérer une grosse économie. Si c'est des polices et du texte, non, et aucun outil ne le peut. Lequel des deux vous avez est toute l'histoire, et cela vaut dix secondes de regard.
## Où se trouve vraiment le poids d'un PDF
Un PDF est un conteneur pour plusieurs sortes de choses, et elles ne se compressent pas pareil.
- **Les images.** Photographies et scans. Presque toujours l'essentiel d'un gros PDF, et la seule partie où il y ait vraiment de la marge.
- **Les polices incorporées.** Une police complète peut faire des centaines de kilooctets ; un sous-ensemble des caractères réellement utilisés, bien moins. Dans les deux cas, elles ont été compressées par ce qui a produit le fichier.
- **Le texte et le dessin vectoriel.** Des instructions plutôt que des pixels : trace cette ligne, pose ce mot ici. Déjà compact, et déjà compressé.
- **Les objets vers lesquels plus rien ne pointe.** Les PDF en accumulent. Modifier un document ajoute souvent le changement à la suite plutôt que de réécrire le fichier : une ancienne version d'une page peut donc y rester indéfiniment. Réempaqueter le fichier les jette.
Les deux documents que les gens apportent à un compresseur de PDF ont donc des perspectives complètement différentes. Un document numérisé est pour l'essentiel une pile de photographies, et ressort couramment 60 à 90 % plus léger. Un contrat, une thèse ou un rapport exporté, c'est du texte, du dessin et des polices, tous déjà compressés par le logiciel qui les a écrits, et l'économie y est en général de quelques pour cent, obtenue en réempaquetant et en jetant ce qui n'est plus référencé.
Tout outil qui promet « jusqu'à 90 % plus léger » sans regarder votre fichier cite le meilleur cas du premier type à propos du second.
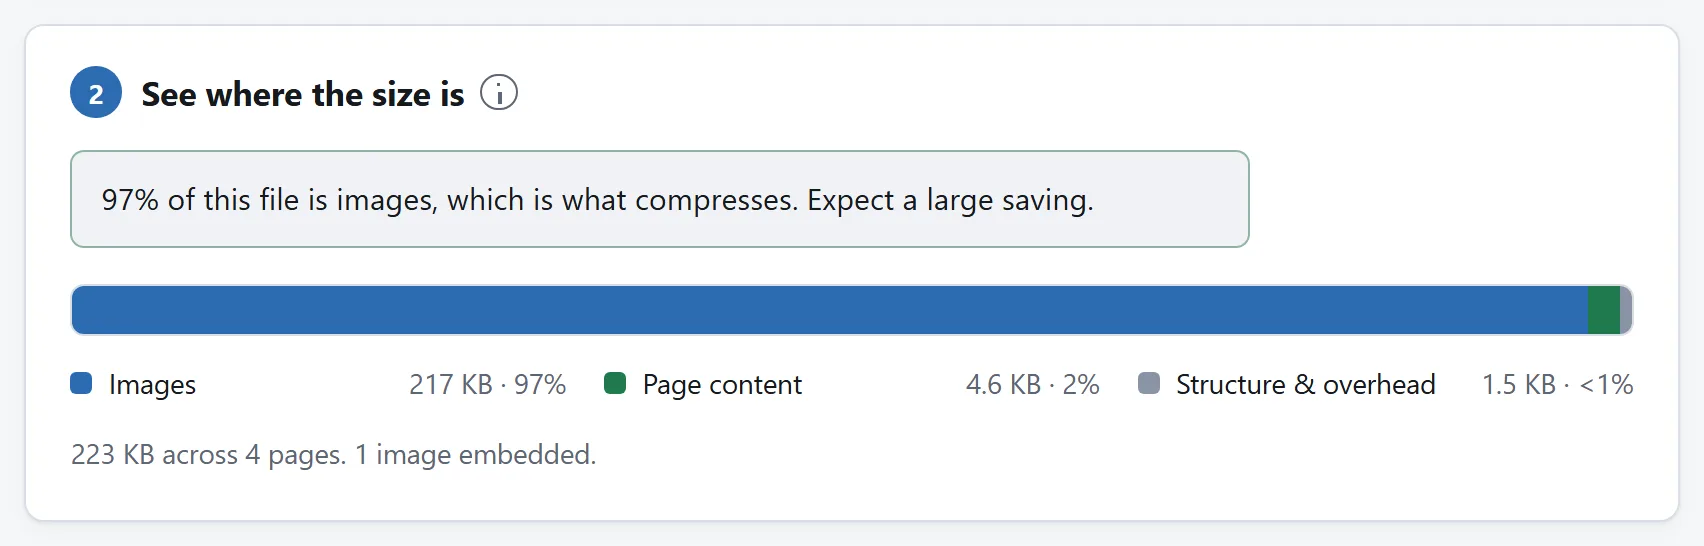
Où se trouve réellement la taille, avant que rien ne soit modifié. Presque tout PDF volumineux l'est pour la raison que montre cette barre.
## Ce que le DPI vient faire là-dedans
Un PDF ne contient pas seulement une image ; il enregistre la taille à laquelle cette image est dessinée sur la page. Cela vous donne quelque chose de plus utile que le nombre de pixels : la résolution effective.
Un scan de 4000 pixels de large étalé sur vingt centimètres de papier transporte 500 pixels par pouce. Un écran en montre environ 100. Une bonne imprimante de bureau travaille à 300 et ne sait guère faire plus. Tout ce qui dépasse est du détail que rien dans l'avenir du document n'affichera jamais, et c'est en général l'essentiel du fichier.
C'est pourquoi un compresseur de PDF sensé demande un DPI plutôt qu'un pourcentage de qualité. Il jette d'abord les pixels au-dessus de votre chiffre, parce qu'ils ne coûtent rien que quiconque puisse voir, et ce n'est qu'ensuite qu'il commence à dépenser de la vraie qualité.
Repère approximatif : **150 DPI** pour un document qui sera lu à l'écran, **200 à 300** pour ce qui sera imprimé, **72 à 100** pour un brouillon que personne ne gardera. Mesurer par rapport à la taille à laquelle l'image est dessinée est aussi ce qui fait qu'un logo posé en petit n'est pas traité comme un scan pleine page : le logo est déjà proche de sa résolution effective et il n'y a rien à y prendre.
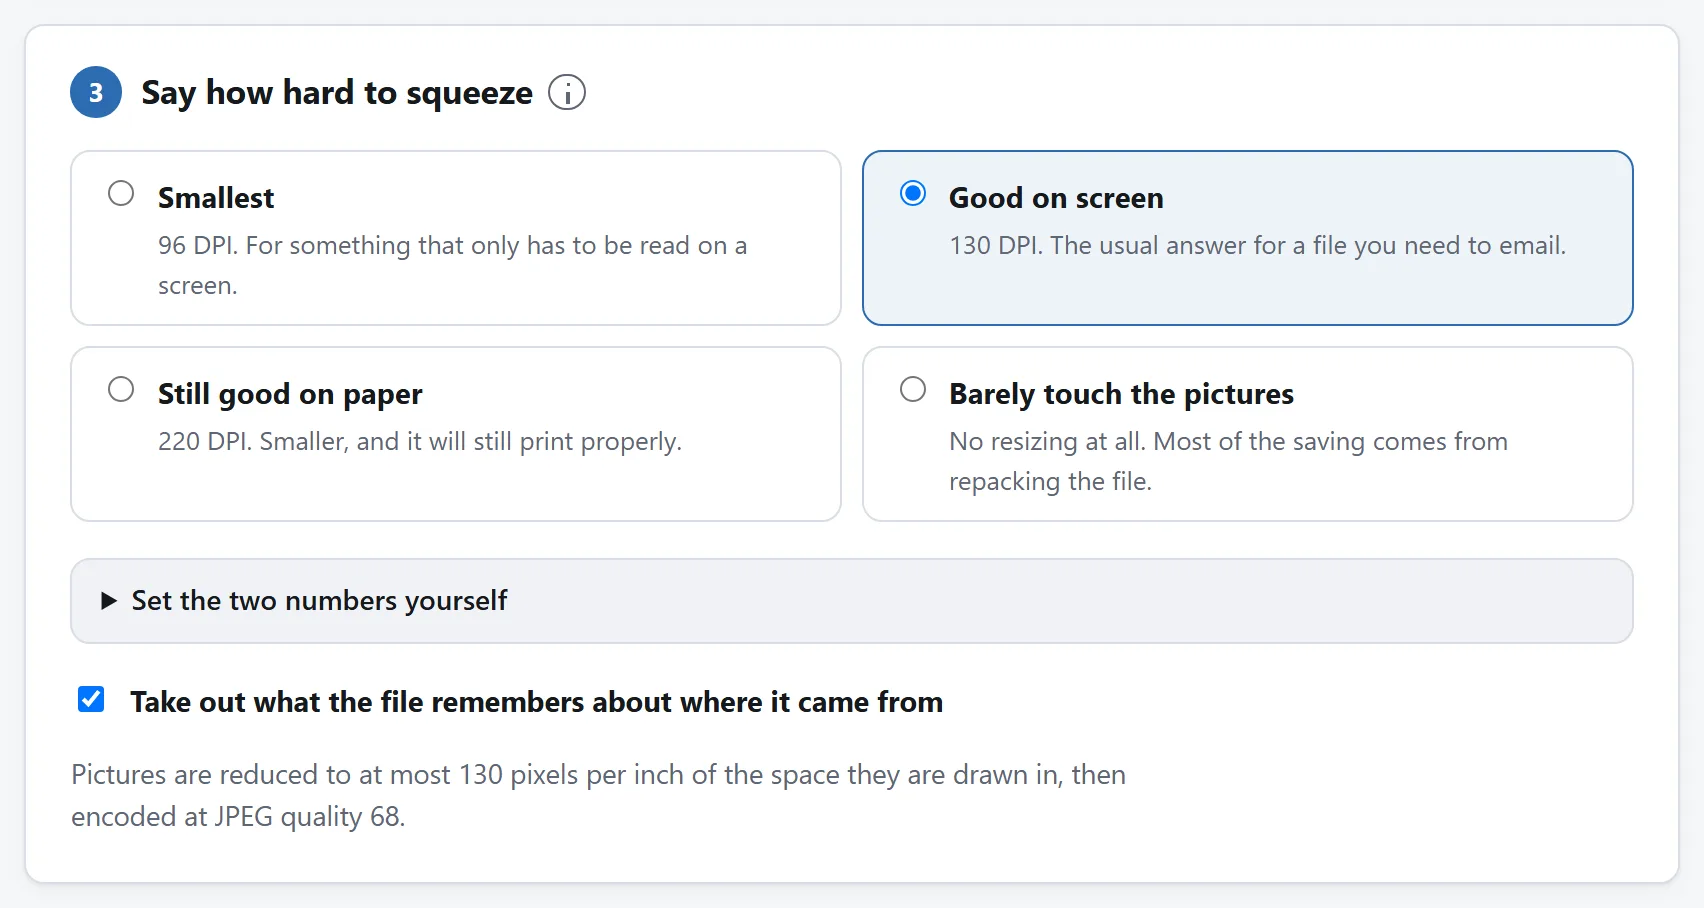
Les deux commandes qui comptent sont la résolution et la qualité. Ce que chacune fait à une page de texte et à une page de photos est le sujet de cette section.
## Ce que compresser doit et ne doit pas toucher
Les images sont réencodées : elles perdent donc un peu. Rien d'autre ne devrait être touché, et il vaut la peine de vérifier que l'outil que vous utilisez s'y tient :
- **Le texte reste du texte.** On peut toujours le sélectionner, le rechercher et le copier. Un compresseur qui aplatit les pages en images produira un fichier très léger et détruira le document : on ne peut plus y chercher un mot, les lecteurs d'écran ne peuvent plus le lire, et cela ne se défait jamais.
- **Les polices restent entières.** Remplacer des polices change l'aspect du document sur la machine de quelqu'un d'autre, ce qui est la seule chose que le PDF existe pour empêcher.
- **Le dessin vectoriel est recopié à l'identique.** Il est déjà léger, et le rastériser le rendrait à la fois plus lourd et moins bon.
- **Les formulaires, les liens, les signets, la structure d'accessibilité et les pièces jointes sont repris.** Ce sont des choses faciles à perdre dans une réécriture et qu'on remarque rarement avant que quelqu'un en ait besoin.
Une règle voisine qu'un compresseur devrait suivre et que beaucoup ne suivent pas : si le réencodage d'une image ne ressort pas réellement plus petit que l'original, il faut remettre les octets d'origine. Abîmer une image sans rien économiser est le cas de perte pure, et cela arrive plus souvent qu'on ne le croirait sur des images déjà bien compressées.
## Les images qui ne peuvent pas être compressées
Certaines images à l'intérieur d'un PDF sont passées, et un bon outil les nomme plutôt que de les laisser discrètement hors du calcul :
- **Les images JPEG 2000, JBIG2 et codées fax (CCITT).** Aucun navigateur ne livre de décodeur pour l'une d'elles : elles sont donc transmises intactes. Les deux dernières sont bitonales, en noir et blanc seulement, et sont en général déjà proches de leur plus petite taille.
- **Les images CMJN.** Laissées tranquilles délibérément. Les réencoder risquerait de déplacer les couleurs qu'une imprimerie produirait, ce qui est une drôle d'initiative à prendre sur un document que quelqu'un va imprimer.
## Choses à essayer avant de compresser
Parfois, le fichier est gros pour une raison à laquelle la compression est la mauvaise réponse.
**A-t-il été scanné alors que ce n'était pas nécessaire ?** Un document imprimé puis scanné est une pile de photographies de texte. Si l'original existe encore quelque part comme document, l'exporter en PDF produira un fichier d'une fraction du poids, où l'on pourra en prime chercher un mot.
**A-t-il été exporté aux réglages d'impression ?** Les traitements de texte et les logiciels de mise en page proposent souvent par défaut un export en qualité d'impression. Réexporter pour l'écran depuis le fichier source bat en général la compression de l'export.
**Faut-il vraiment que ce soit un seul fichier ?** Une limite de courriel est par message. Découper un document de 200 pages en chapitres est parfois le remède honnête.
## Les fichiers chiffrés, et pourquoi un compresseur devrait les refuser
Un PDF protégé par mot de passe est refusé par l'outil d'ici, et il s'agit d'un choix délibéré plutôt que d'une fonction manquante, y compris quand le mot de passe est vide, ce qui est la façon dont enregistrent beaucoup de scanners et de photocopieurs.
Retirer la protection d'un document est un autre métier que le compresser. Un outil qui le ferait en silence ferait quelque chose que vous n'avez pas demandé, à un fichier que quelqu'un avait délibérément verrouillé, et vous rendrait une copie qui n'aurait plus la propriété qu'on avait voulu lui donner. Retirez la protection vous-même d'abord, délibérément, si c'est ce que vous voulez.
## Vérifier le résultat
Ouvrez-le. Regardez les images en zoom maximal, vérifiez que le texte est toujours sélectionnable, et confirmez le nombre de pages.
L'outil d'ici fait le dernier point pour vous avant de proposer le fichier : il rouvre le document qu'il vient d'écrire et compte les pages, sur votre propre machine. Il écrit en outre du PDF 1.5, que comprend tout lecteur sorti depuis 2003 : « il s'ouvre sur ma machine » est donc un indice raisonnable de « il s'ouvre sur la leur ».
## Pourquoi cela n'a pas besoin d'un serveur
Compresser un PDF a l'air d'un travail de serveur, et pendant l'essentiel de la vie du web ç'en a été un. Ce que cela implique réellement, c'est analyser la structure du fichier, trouver les flux d'images, les décoder et les réencoder avec les codecs qu'un navigateur embarque déjà, et réécrire le document. Tout cela tourne dans un navigateur aujourd'hui.
Ce qui compte plus pour ce type de fichier que pour la plupart, à cause de ce que les gens compressent : contrats, courriers médicaux, relevés bancaires, pièces d'identité, déclarations d'impôts. L'outil d'ici n'a aucune fonction réseau, et la `Content-Security-Policy` de la page énumère toutes les adresses qu'elle peut contacter, dont aucune n'appartient à ce site. Chargez-le, débranchez, et compressez quelque chose quand même.
[Est-il sûr d'envoyer ses fichiers à un convertisseur en ligne ?](https://abox.tools/fr/guides/est-il-sur-d-envoyer-ses-fichiers/) propose trois autres vérifications de ce genre.
La réponse courte
Ouvrez le compresseur de PDF, déposez-y le document, et regardez ce qu'il vous dit avant de changer quoi que ce soit. Il lit le fichier et montre où se trouve vraiment le poids : images, polices, texte et dessin, et tout ce à quoi plus rien dans le document ne renvoie. Cet écran répond en général à la question.
Si l'essentiel du poids est fait d'images, vous pouvez espérer une grosse économie. Si c'est des polices et du texte, non, et aucun outil ne le peut. Lequel des deux vous avez est toute l'histoire, et cela vaut dix secondes de regard.
Où se trouve vraiment le poids d'un PDF
Un PDF est un conteneur pour plusieurs sortes de choses, et elles ne se compressent pas pareil.
Les images. Photographies et scans. Presque toujours l'essentiel d'un gros PDF, et la seule partie où il y ait vraiment de la marge.
Les polices incorporées. Une police complète peut faire des centaines de kilooctets ; un sous-ensemble des caractères réellement utilisés, bien moins. Dans les deux cas, elles ont été compressées par ce qui a produit le fichier.
Le texte et le dessin vectoriel. Des instructions plutôt que des pixels : trace cette ligne, pose ce mot ici. Déjà compact, et déjà compressé.
Les objets vers lesquels plus rien ne pointe. Les PDF en accumulent. Modifier un document ajoute souvent le changement à la suite plutôt que de réécrire le fichier : une ancienne version d'une page peut donc y rester indéfiniment. Réempaqueter le fichier les jette.
Les deux documents que les gens apportent à un compresseur de PDF ont donc des perspectives complètement différentes. Un document numérisé est pour l'essentiel une pile de photographies, et ressort couramment 60 à 90 % plus léger. Un contrat, une thèse ou un rapport exporté, c'est du texte, du dessin et des polices, tous déjà compressés par le logiciel qui les a écrits, et l'économie y est en général de quelques pour cent, obtenue en réempaquetant et en jetant ce qui n'est plus référencé.
Tout outil qui promet « jusqu'à 90 % plus léger » sans regarder votre fichier cite le meilleur cas du premier type à propos du second.
Où se trouve réellement la taille, avant que rien ne soit modifié. Presque tout PDF volumineux l'est pour la raison que montre cette barre.
Ce que le DPI vient faire là-dedans
Un PDF ne contient pas seulement une image ; il enregistre la taille à laquelle cette image est dessinée sur la page. Cela vous donne quelque chose de plus utile que le nombre de pixels : la résolution effective.
Un scan de 4000 pixels de large étalé sur vingt centimètres de papier transporte 500 pixels par pouce. Un écran en montre environ 100. Une bonne imprimante de bureau travaille à 300 et ne sait guère faire plus. Tout ce qui dépasse est du détail que rien dans l'avenir du document n'affichera jamais, et c'est en général l'essentiel du fichier.
C'est pourquoi un compresseur de PDF sensé demande un DPI plutôt qu'un pourcentage de qualité. Il jette d'abord les pixels au-dessus de votre chiffre, parce qu'ils ne coûtent rien que quiconque puisse voir, et ce n'est qu'ensuite qu'il commence à dépenser de la vraie qualité.
Repère approximatif : 150 DPI pour un document qui sera lu à l'écran, 200 à 300 pour ce qui sera imprimé, 72 à 100 pour un brouillon que personne ne gardera. Mesurer par rapport à la taille à laquelle l'image est dessinée est aussi ce qui fait qu'un logo posé en petit n'est pas traité comme un scan pleine page : le logo est déjà proche de sa résolution effective et il n'y a rien à y prendre.
Les deux commandes qui comptent sont la résolution et la qualité. Ce que chacune fait à une page de texte et à une page de photos est le sujet de cette section.
Ce que compresser doit et ne doit pas toucher
Les images sont réencodées : elles perdent donc un peu. Rien d'autre ne devrait être touché, et il vaut la peine de vérifier que l'outil que vous utilisez s'y tient :
Le texte reste du texte. On peut toujours le sélectionner, le rechercher et le copier. Un compresseur qui aplatit les pages en images produira un fichier très léger et détruira le document : on ne peut plus y chercher un mot, les lecteurs d'écran ne peuvent plus le lire, et cela ne se défait jamais.
Les polices restent entières. Remplacer des polices change l'aspect du document sur la machine de quelqu'un d'autre, ce qui est la seule chose que le PDF existe pour empêcher.
Le dessin vectoriel est recopié à l'identique. Il est déjà léger, et le rastériser le rendrait à la fois plus lourd et moins bon.
Les formulaires, les liens, les signets, la structure d'accessibilité et les pièces jointes sont repris. Ce sont des choses faciles à perdre dans une réécriture et qu'on remarque rarement avant que quelqu'un en ait besoin.
Une règle voisine qu'un compresseur devrait suivre et que beaucoup ne suivent pas : si le réencodage d'une image ne ressort pas réellement plus petit que l'original, il faut remettre les octets d'origine. Abîmer une image sans rien économiser est le cas de perte pure, et cela arrive plus souvent qu'on ne le croirait sur des images déjà bien compressées.
Les images qui ne peuvent pas être compressées
Certaines images à l'intérieur d'un PDF sont passées, et un bon outil les nomme plutôt que de les laisser discrètement hors du calcul :
Les images JPEG 2000, JBIG2 et codées fax (CCITT). Aucun navigateur ne livre de décodeur pour l'une d'elles : elles sont donc transmises intactes. Les deux dernières sont bitonales, en noir et blanc seulement, et sont en général déjà proches de leur plus petite taille.
Les images CMJN. Laissées tranquilles délibérément. Les réencoder risquerait de déplacer les couleurs qu'une imprimerie produirait, ce qui est une drôle d'initiative à prendre sur un document que quelqu'un va imprimer.
Choses à essayer avant de compresser
Parfois, le fichier est gros pour une raison à laquelle la compression est la mauvaise réponse.
A-t-il été scanné alors que ce n'était pas nécessaire ? Un document imprimé puis scanné est une pile de photographies de texte. Si l'original existe encore quelque part comme document, l'exporter en PDF produira un fichier d'une fraction du poids, où l'on pourra en prime chercher un mot.
A-t-il été exporté aux réglages d'impression ? Les traitements de texte et les logiciels de mise en page proposent souvent par défaut un export en qualité d'impression. Réexporter pour l'écran depuis le fichier source bat en général la compression de l'export.
Faut-il vraiment que ce soit un seul fichier ? Une limite de courriel est par message. Découper un document de 200 pages en chapitres est parfois le remède honnête.
Les fichiers chiffrés, et pourquoi un compresseur devrait les refuser
Un PDF protégé par mot de passe est refusé par l'outil d'ici, et il s'agit d'un choix délibéré plutôt que d'une fonction manquante, y compris quand le mot de passe est vide, ce qui est la façon dont enregistrent beaucoup de scanners et de photocopieurs.
Retirer la protection d'un document est un autre métier que le compresser. Un outil qui le ferait en silence ferait quelque chose que vous n'avez pas demandé, à un fichier que quelqu'un avait délibérément verrouillé, et vous rendrait une copie qui n'aurait plus la propriété qu'on avait voulu lui donner. Retirez la protection vous-même d'abord, délibérément, si c'est ce que vous voulez.
Vérifier le résultat
Ouvrez-le. Regardez les images en zoom maximal, vérifiez que le texte est toujours sélectionnable, et confirmez le nombre de pages.
L'outil d'ici fait le dernier point pour vous avant de proposer le fichier : il rouvre le document qu'il vient d'écrire et compte les pages, sur votre propre machine. Il écrit en outre du PDF 1.5, que comprend tout lecteur sorti depuis 2003 : « il s'ouvre sur ma machine » est donc un indice raisonnable de « il s'ouvre sur la leur ».
Pourquoi cela n'a pas besoin d'un serveur
Compresser un PDF a l'air d'un travail de serveur, et pendant l'essentiel de la vie du web ç'en a été un. Ce que cela implique réellement, c'est analyser la structure du fichier, trouver les flux d'images, les décoder et les réencoder avec les codecs qu'un navigateur embarque déjà, et réécrire le document. Tout cela tourne dans un navigateur aujourd'hui.
Ce qui compte plus pour ce type de fichier que pour la plupart, à cause de ce que les gens compressent : contrats, courriers médicaux, relevés bancaires, pièces d'identité, déclarations d'impôts. L'outil d'ici n'a aucune fonction réseau, et la Content-Security-Policy de la page énumère toutes les adresses qu'elle peut contacter, dont aucune n'appartient à ce site. Chargez-le, débranchez, et compressez quelque chose quand même.

