Die kurze Antwort
- Öffnen Sie den JSON-Formatierer, fügen Sie die erste Datei ein, stellen Sie die Einrückung auf zwei Leerzeichen und setzen Sie den Haken bei Die Schlüssel jedes Objekts sortieren. Kopieren Sie das Ergebnis.
- Öffnen Sie den Textvergleich und fügen Sie es in das linke Feld ein.
- Dasselbe mit der zweiten Datei, in das rechte Feld.
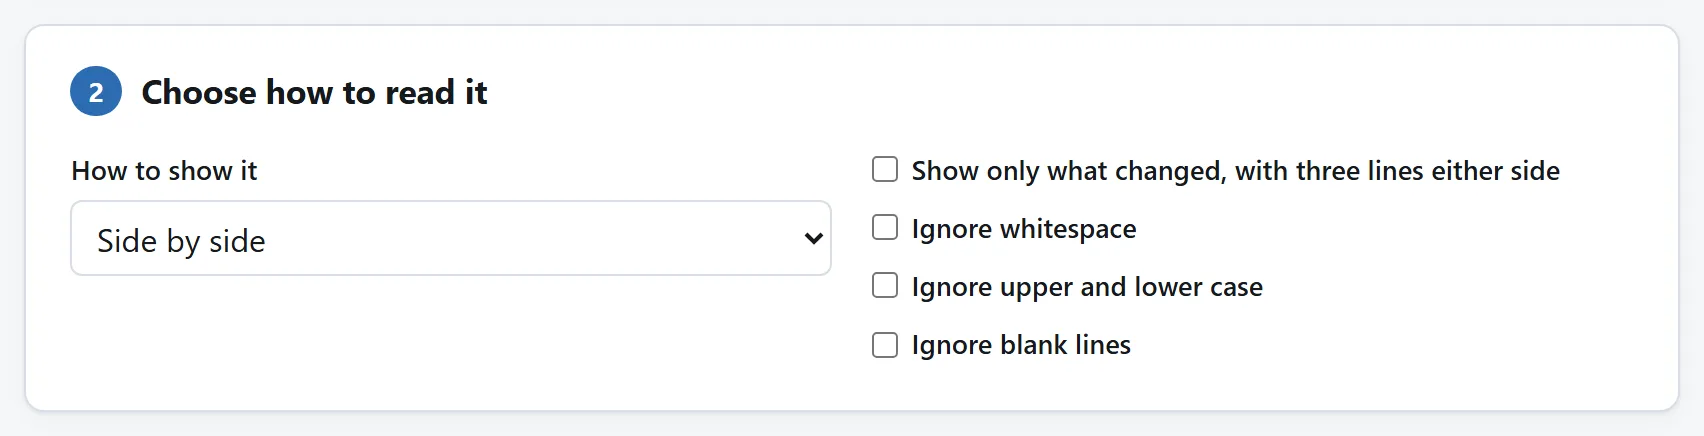
Was jetzt aufleuchtet, ist echt: ein Wert, der sich geändert hat, ein Schlüssel, der neu ist, ein Eintrag, der fehlt. Die Formatierungsunterschiede und die umsortierten Schlüssel, in denen ein gewöhnlicher Vergleich ertrunken wäre, sind fort, weil beide Seiten gleich geschrieben waren, bevor der Vergleich begann.
Keine der beiden Seiten hat irgendeine Netzfunktion, was zu wissen sich lohnt: Das JSON, das Menschen vergleichen, sind so oft Konfigurationsdateien, in denen noch Zugangsdaten stehen.
Warum ein roher JSON-Vergleich fast nur Rauschen ist
JSON ist Leerraum gleichgültig, und der Reihenfolge der Schlüssel gibt es keine Bedeutung. Dasselbe Dokument kann eine Zeile lang sein oder vierhundert, die Schlüssel in Tippreihenfolge tragen oder in der, die irgendeine Bibliothek ausgegeben hat, und Werkzeuge schreiben beides ungefragt um. Eine Seite minimiert, die andere ausgelegt; eine von Hand gespeichert, die andere von einem Serialisierer, der alphabetisch sortiert: Ein Zeilenvergleich sieht zwei fremde Dateien.
Die zwei schlimmsten Fälle machen den Punkt. Eine minimierte Datei ist eine Zeile, ein Vergleich dagegen also eine einzige riesige geänderte Zeile, wahr und nutzlos. Und zwei Dateien mit demselben Inhalt in anderer Reihenfolge vergleichen sich als alles-geändert, wo die ehrliche Antwort „nichts“ wäre.
Was die Normalform des Formatierers behebt
Beide Dateien durch denselben Formatierer mit denselben Einstellungen zu schicken ist genau, was ein Vergleich braucht: eine Schreibweise je Dokument.
- Gleiche Einrückung stellt jeden Schlüssel auf seine eigene Zeile. Der Vergleich arbeitet dann Zeile für Zeile, und seine Wortmarkierungen können auf den einen Wert zeigen, der sich in einer Zeile geändert hat.
- Sortierte Schlüssel bringen beide Seiten in dieselbe Ordnung, womit die Reihenfolge aufhört, ein Unterschied zu sein. Sortiert wird danach, wie Schlüssel sich lesen, nicht nach Codepunkten,
item2voritem10, und auf beiden Seiten identisch. - Sonst bewegt sich nichts. Dieser Formatierer behält Zahlen als die Ziffern, die Sie geschrieben haben, und behält doppelte Schlüssel, statt sie aufzulösen. Das In-Normalform-Bringen kann also selbst keinen Unterschied erfinden. Der Formatierer-Ratgeber erklärt, warum das seltener ist, als es sein sollte.
Ein ehrlicher Vorbehalt: Die sortierte Ausgabe ist das Dokument mit verschobenen Schlüsseln. Wenn ein nachgelagertes Werkzeug auf die Reihenfolge achtet, wenige tun es, aber es gibt sie, dann behandeln Sie die sortierten Kopien als das, was verglichen wird, nicht als Ersatz für die Originale.
Das Ergebnis lesen, und es mitnehmen
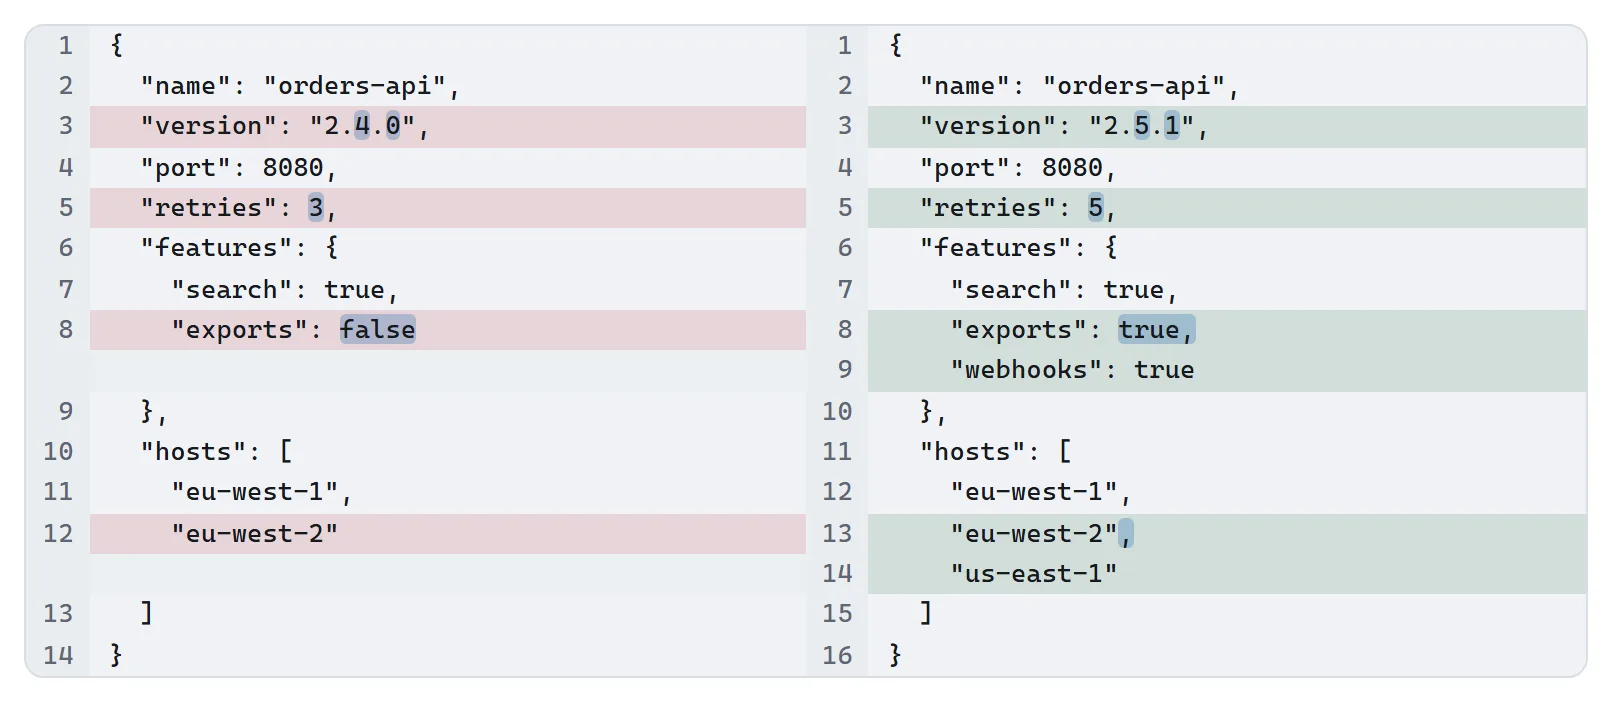
Der Vergleich markiert entfernte Zeilen links, hinzugekommene rechts und hebt innerhalb einer geänderten Zeile die Wörter hervor, die sich unterscheiden. Auf einer Normalform ist das typischerweise der eine Wert, der von false auf true gewandert ist. Die unveränderte Mitte klappt zu einer Zahl zusammen, sodass eine Konfiguration von zweitausend Zeilen mit drei Änderungen sich als drei kurze Passagen liest.
Der Download ist eine Unified-.patch-Datei, das Format, das Code-Reviews verstehen. Sie beschreibt die Normalformen, und das ist meist genau, was ein Review will: die Änderung, ohne das Umformatieren.
Dasselbe Rezept funktioniert für alles andere, das beide Seiten sprechen. YAML und XML kommen genauso in Normalform; und für zwei gleichförmige Dateien aus verschiedenen Quellen sind die Ignorier-Schalter des Vergleichs, Leerraum, Groß- und Kleinschreibung, Leerzeilen, eine leichtere Fassung derselben Idee.
Wenn Sie das jede Woche tun
Zweimal formatieren, zweimal einfügen: Die Schritte leben auf zwei Seiten, weil jede Seite eine Aufgabe macht und jede für sich beweisen kann, dass nichts von dem, was Sie einfügten, irgendwohin ging. Aber beide sind quelloffen: MIT-lizenziert, abhängigkeitsfreie ES-Module, der Parser des Formatierers behält Schlüsselreihenfolge und Ziffern, der Vergleich ist Myers' Algorithmus, jedes mit einem README, das es erklärt.
Wenn das zu Ihrem Alltag gehört, setzen Sie einen Coding-Agenten auf das Repository an und lassen Sie sich eine Seite mit zwei Feldern bauen, die beim Vergleichen gleich in Normalform bringt: parseJson, printJson und compareText sind drei Importe entfernt. Die Module sind zum Lesen geschrieben, und sie herauszuheben ist genau das, wofür die Lizenz da ist.