La réponse courte
- Ouvrez le Formateur JSON, collez le premier fichier, réglez l'indentation sur deux espaces et cochez Trier les clés de chaque objet. Copiez le résultat.
- Ouvrez le Comparateur de textes et collez-le dans la zone de gauche.
- Faites de même avec le second fichier, dans la zone de droite.
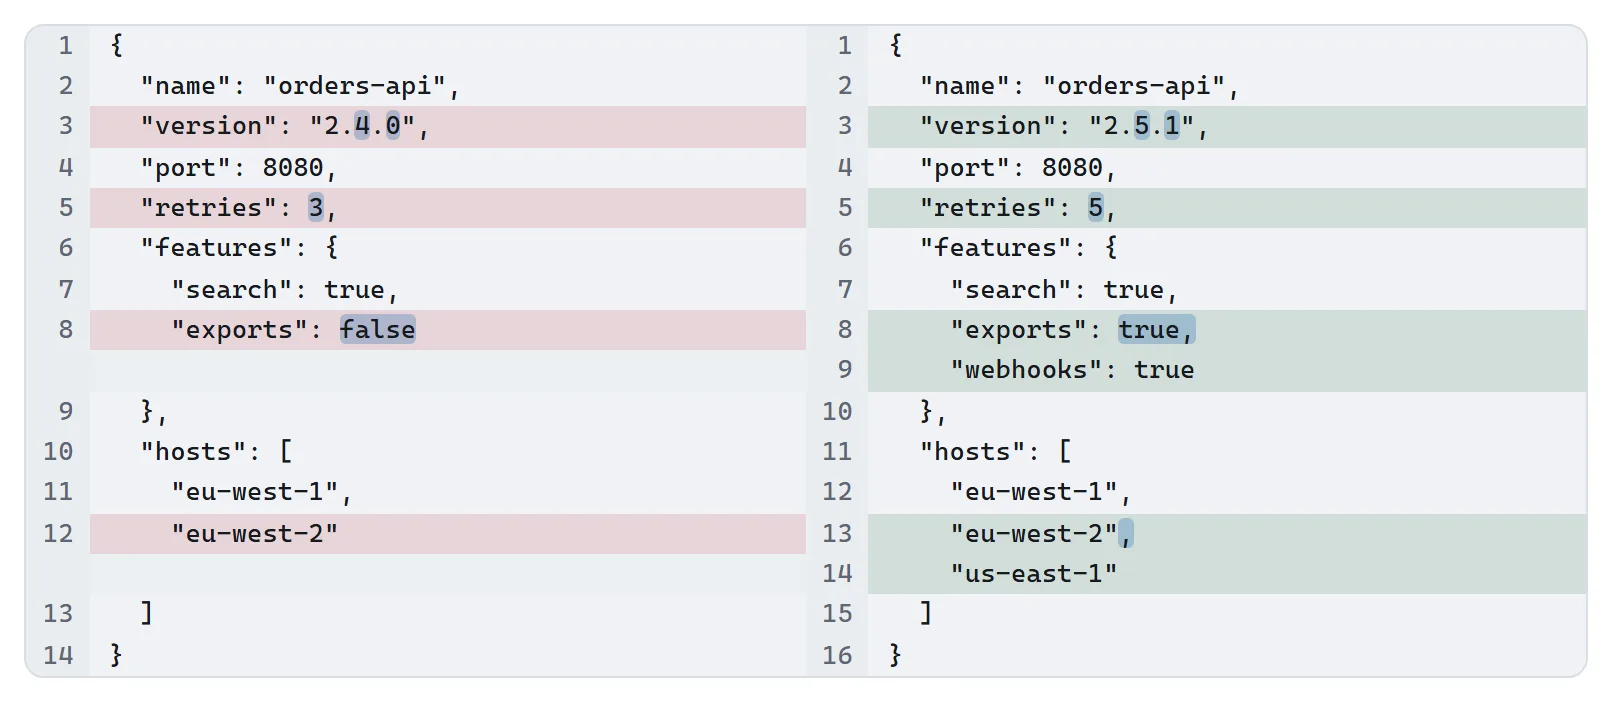
Le résultat est bien plus facile à lire : une valeur modifiée, une clé apparue, une entrée supprimée. Les différences de mise en forme et les clés réordonnées qui auraient noyé un diff ordinaire disparaissent, car les deux côtés ont été écrits de la même façon avant la comparaison.
Aucune des deux pages n'a la moindre fonction réseau — bon à savoir, puisque le JSON que l'on compare est si souvent un fichier de configuration avec ses identifiants encore dedans.
Modifications de configuration et régressions d'API
Pour comparer préproduction et production, gardez les originaux et formatez une copie de chacun avec deux espaces et les clés d'objet triées. Placez la préproduction à gauche et la production à droite, désactivez Ignorer la casse et Ignorer les espaces, puis examinez les points d'accès, indicateurs de fonctionnalités et limites. Les espaces dans une chaîne et la casse d'une clé peuvent compter. Téléchargez le patch après avoir confirmé quel environnement est de quel côté.
La même recette vérifie une réponse d'API avant et après une modification. Utilisez les mêmes entrées de requête et traitez séparément les horodatages ou identifiants générés. Les tableaux gardent leur ordre : une liste réordonnée reste différente, comme il convient à une séquence JSON ordonnée. Des nombres équivalents comme 1 et 1.0, ou des chaînes échappées différemment, peuvent aussi différer ici. C'est une comparaison de texte formaté, pas une validation de schéma ni un test d'équivalence de toutes les valeurs JSON. La norme JSON distingue les objets non ordonnés des tableaux ordonnés.
Pourquoi un diff JSON brut n'est presque que du bruit
JSON se moque des espaces, et il ne donne aucun sens à l'ordre des clés. Le même document peut tenir en une ligne ou en quatre cents, les clés dans l'ordre où on les a tapées ou dans celui qu'une bibliothèque a émis — et les outils réécrivent tout cela librement. Un côté minifié, l'autre déplié ; un côté enregistré à la main, l'autre par un sérialiseur qui trie par ordre alphabétique : un diff de lignes voit deux fichiers étrangers.
Les deux pires cas suffisent à la démonstration. Un fichier minifié est une ligne, donc un diff contre lui est une seule ligne changée, gigantesque — vrai et inutile. Et deux fichiers au même contenu dans un autre ordre se comparent comme tout-a-changé, quand la réponse honnête serait « rien ».
Ce que la forme canonique du formateur répare
Passer les deux fichiers par le même formateur avec les mêmes réglages est exactement ce qu'il faut à un diff : une écriture par document.
- La même indentation met chaque clé sur sa propre ligne, si bien que le diff travaille ligne à ligne et que son marquage des mots peut pointer la seule valeur qui a changé dans une ligne.
- Les clés triées mettent les deux côtés dans le même ordre, et l'ordre cesse d'être une différence. Le tri suit la façon dont les clés se lisent, pas les points de code —
item2avantitem10— et il s'applique à l'identique des deux côtés. - Rien d'autre ne bouge. Ce formateur garde les nombres tels que vous les avez écrits et garde les clés en double plutôt que de les trancher — la canonisation ne peut donc pas inventer elle-même une différence. Le guide du formateur explique pourquoi c'est plus rare que cela ne devrait l'être.
Une réserve honnête : la sortie triée est le document avec ses clés déplacées. Si un outil en aval tient à l'ordre des clés — peu le font, mais il en existe — traitez les copies triées comme la chose comparée, pas comme un remplacement des originaux.
Lire le résultat, et l'emporter
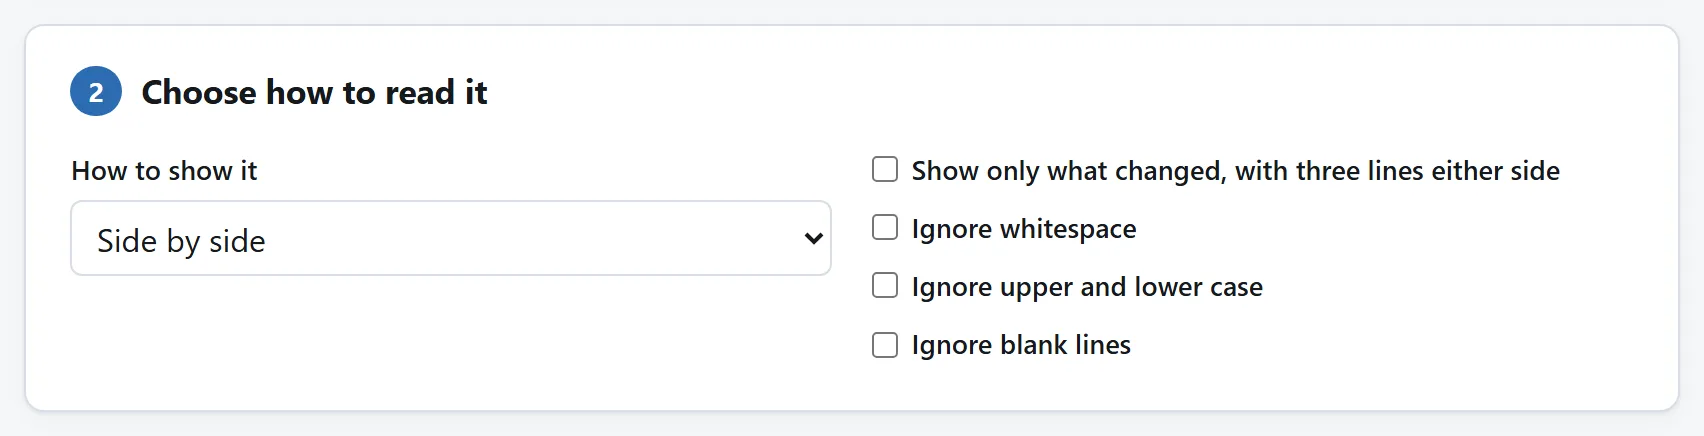
Le comparateur marque les lignes retirées à gauche, les ajoutées à droite, et surligne dans une ligne changée les mots qui diffèrent — sur une forme canonique, c'est typiquement la seule valeur passée de false à true. Le milieu inchangé se replie en un compte, si bien qu'une configuration de deux mille lignes avec trois retouches se lit comme trois courts passages.
Le téléchargement est un correctif unifié, un .patch — le format que la revue de code comprend. Il décrit les formes canoniques, ce qui est en général ce qu'une revue veut de toute façon : le changement, sans le reformatage.
Formater puis comparer peut aussi faciliter l'examen du YAML ou du XML, mais leurs règles d'espacement et de conversion diffèrent de celles du JSON. Gardez le langage d'origine si seule la présentation doit changer. Les options d'ignorance du diff affectent sa vue ; le patch compare les chaînes réellement fournies. Ici, ce sont vos copies formatées : ce patch ne s'applique donc pas aux originaux intacts.
Si vous faites cela chaque semaine
Formater deux fois, coller deux fois — les étapes vivent sur deux pages parce que chaque page fait un travail, et que chacune peut prouver seule que rien de ce que vous avez collé n'est allé nulle part. Mais les deux sont libres : licence MIT, des modules ES sans dépendances — le parseur du formateur garde l'ordre des clés et les chiffres, le diff est l'algorithme de Myers — chacun avec un README qui l'explique.
Si cela fait partie de vos journées, pointez un agent de code vers le dépôt et demandez-lui une page à deux zones qui canonise en comparant — parseJson, printJson et compareText sont à trois imports de là. Les modules ont été écrits pour être lus, et les emporter est exactement ce à quoi sert la licence.