Compara dos archivos JSON tal como vienen y casi todo lo que se enciende no es nada: sangría, saltos de línea, claves en otro orden. El arreglo no es un diff más listo — es pasar antes los dos archivos por el mismo formateador, para que solo queden las diferencias reales. Los dos pasos corren en tu navegador, que es donde deben estar los archivos de configuración con secretos dentro.
Abrir Comparador de textosDos textos dentro, cada diferencia marcada, línea a línea y palabra a palabra. Nada se pega en el servidor de nadie.
# Cómo comparar dos archivos JSON
Compara dos archivos JSON tal como vienen y casi todo lo que se enciende no es nada: sangría, saltos de línea, claves en otro orden. El arreglo no es un diff más listo — es pasar antes los dos archivos por el mismo formateador, para que solo queden las diferencias reales. Los dos pasos corren en tu navegador, que es donde deben estar los archivos de configuración con secretos dentro.
[Abrir Comparador de textos](https://abox.tools/es/comparar-textos/): Dos textos dentro, cada diferencia marcada, línea a línea y palabra a palabra. Nada se pega en el servidor de nadie.
Última actualización 26 de agosto de 2026
## La respuesta corta
1. Abre el [Formateador de JSON](https://abox.tools/es/formatear-json/), pega el primer archivo, pon la sangría en dos espacios y marca *Ordenar las claves de cada objeto*. Copia el resultado.
2. Abre el [Comparador de textos](https://abox.tools/es/comparar-textos/) y pégalo en la caja izquierda.
3. Haz lo mismo con el segundo archivo, en la caja derecha.
Lo que se enciende ahora es real: un valor que cambió, una clave que apareció, una entrada que se fue. Las diferencias de formato y las claves reordenadas que habrían ahogado un diff corriente ya no están, porque los dos lados estaban escritos igual antes de que la comparación empezara.
Ninguna de las dos páginas tiene función de red alguna, y conviene saberlo: el JSON que la gente compara es tantas veces un archivo de configuración con las credenciales todavía dentro.
## Por qué un diff de JSON en crudo es casi todo ruido
A JSON el espacio en blanco le da igual, y al orden de las claves no le da significado. El mismo documento puede ser una línea o cuatrocientas, con las claves en el orden en que se teclearon o en el que las soltó alguna biblioteca, y las herramientas reescriben ambas cosas sin preguntar. Un lado minificado y el otro desplegado; uno guardado a mano y el otro por un serializador que ordena alfabéticamente: un diff de líneas ve dos archivos sin parentesco.
Los dos peores casos bastan para verlo. Un archivo **minificado** es una línea, así que un diff contra él es una única línea cambiada y gigantesca: verdadero e inútil. Y dos archivos con **el mismo contenido en otro orden** se comparan como todo-cambió, cuando la respuesta honesta sería «nada».
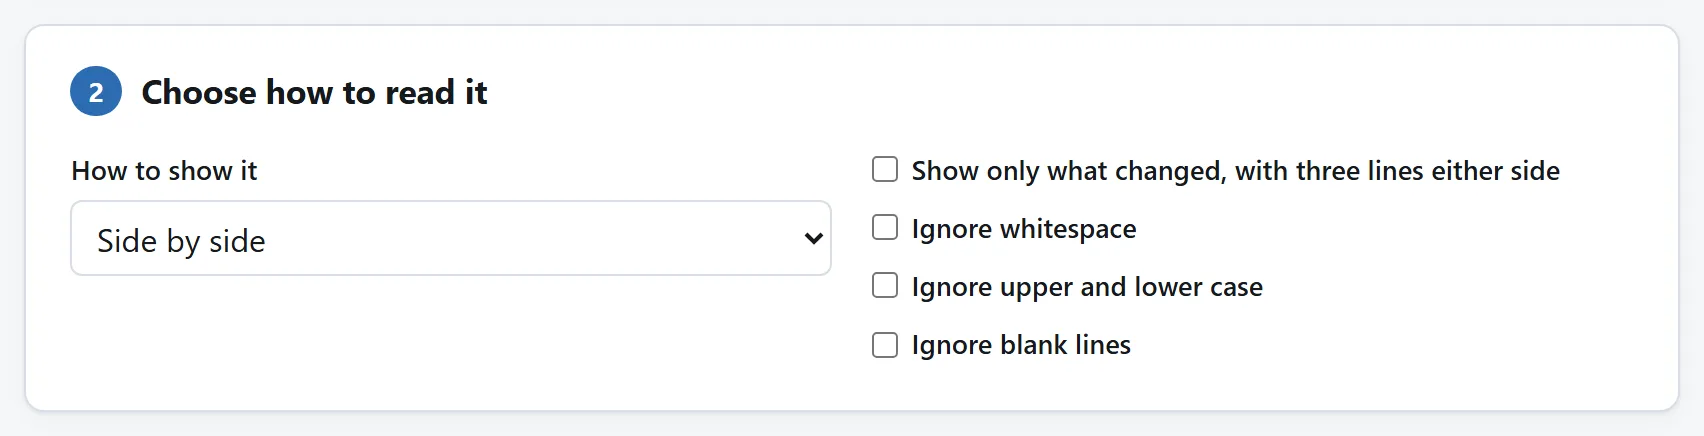
Son los que evitan que una comparación marque todas las líneas porque un archivo se guardó con otro fin de línea.
## Qué arregla la forma canónica del formateador
Pasar los dos archivos por el mismo formateador con los mismos ajustes es justo lo que un diff necesita: una escritura por documento.
- **La misma sangría** pone cada clave en su propia línea: el diff trabaja entonces línea a línea, y sus marcas de palabras pueden señalar el único valor que cambió dentro de una.
- **Las claves ordenadas** ponen los dos lados en el mismo orden, y el orden deja de contar como diferencia. Se ordena por cómo se leen las claves, no por puntos de código — `item2` antes que `item10` — y se aplica idéntico a ambos lados.
- **Nada más se mueve.** Este formateador conserva los números con los dígitos que escribiste y conserva las claves duplicadas en vez de resolverlas: canonizar no puede inventar por sí mismo una diferencia. La [guía del formateador](https://abox.tools/es/guias/formatear-json/) explica por qué eso es más raro de lo que debería.
Una salvedad honesta: la salida ordenada es el documento con las claves movidas. Si alguna herramienta posterior atiende al orden de las claves — pocas lo hacen, pero existen — trata las copias ordenadas como lo que se compara, no como sustituto de los originales.
## Leer el resultado, y llevárselo
El comparador marca a la izquierda las líneas quitadas, a la derecha las añadidas, y resalta dentro de una línea cambiada las palabras que difieren: sobre una forma canónica, eso suele ser el único valor que pasó de `false` a `true`. El medio sin cambios se pliega a un recuento, así que una configuración de dos mil líneas con tres retoques se lee como tres pasajes cortos.
La descarga es un parche unificado, un `.patch`: el formato que entiende la revisión de código. Describe las formas canónicas, que suele ser lo que una revisión quiere de todos modos: el cambio, sin el reformateo.
La misma receta sirve para todo lo demás que hablan las dos páginas. YAML y XML se canonizan igual; y para dos archivos de la misma forma venidos de fuentes distintas, los interruptores de ignorar del comparador — espacios, mayúsculas, líneas vacías — son una versión ligera de la misma idea.
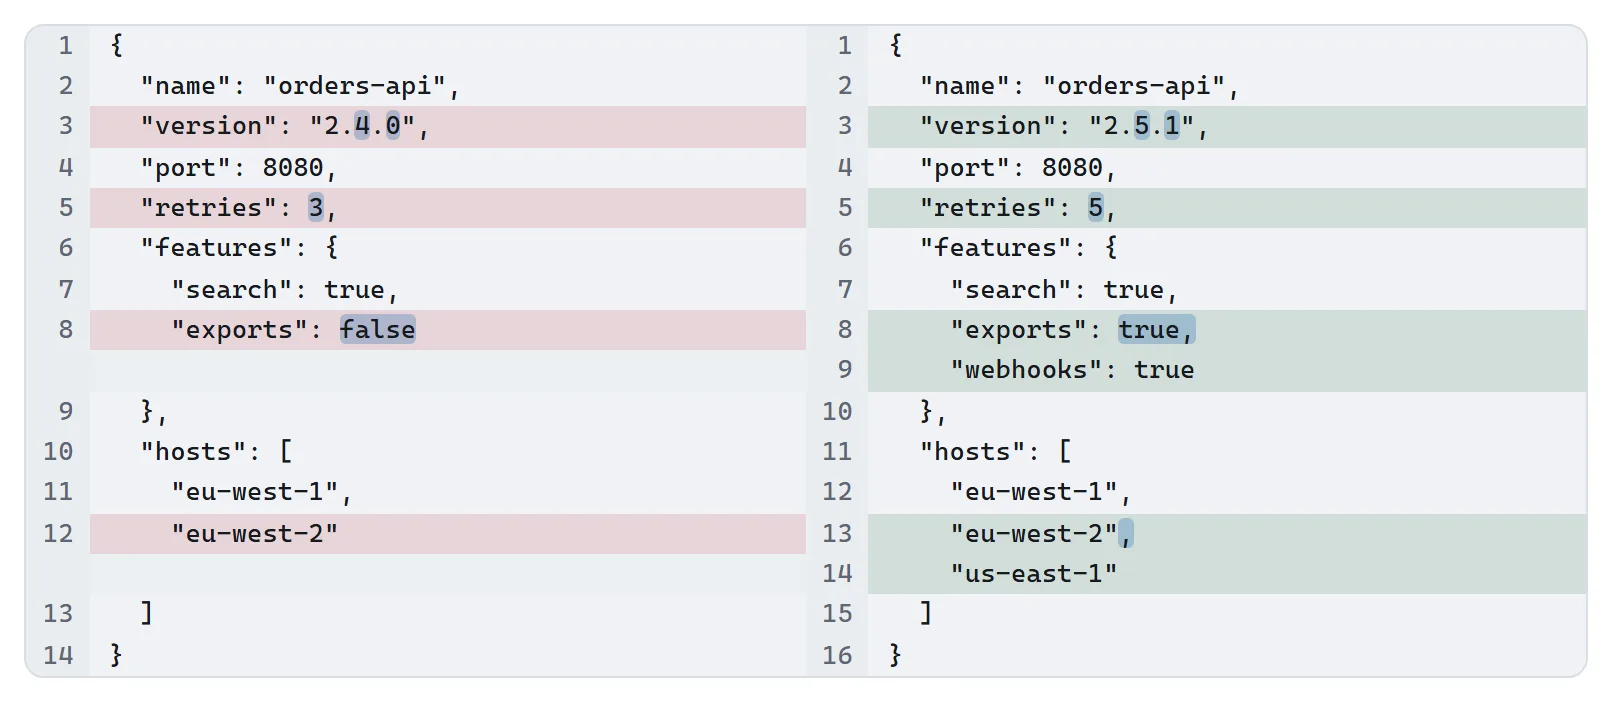
Cuatro diferencias reales y nada más. Leerlas es la mitad fácil; el trabajo lo hicieron los ajustes de arriba.
## Si haces esto cada semana
Formatear dos veces, pegar dos veces: los pasos viven en dos páginas porque cada página hace un trabajo, y cada una puede demostrar por sí sola que nada de lo que pegaste fue a ninguna parte. Pero las dos son código abierto: licencia MIT, módulos ES sin dependencias — el analizador del formateador conserva orden de claves y dígitos, el diff es el algoritmo de Myers — cada uno con un README que lo explica.
Si esto es parte de tu día, apunta un agente de código al [repositorio](https://github.com/A-Box-of-Tools/website) y pídele una página de dos cajas que canonice mientras compara: `parseJson`, `printJson` y `compareText` están a tres imports. Los módulos se escribieron para leerse, y llevárselos es exactamente para lo que está la licencia.
La respuesta corta
Abre el Formateador de JSON, pega el primer archivo, pon la sangría en dos espacios y marca Ordenar las claves de cada objeto. Copia el resultado.
Haz lo mismo con el segundo archivo, en la caja derecha.
Lo que se enciende ahora es real: un valor que cambió, una clave que apareció, una entrada que se fue. Las diferencias de formato y las claves reordenadas que habrían ahogado un diff corriente ya no están, porque los dos lados estaban escritos igual antes de que la comparación empezara.
Ninguna de las dos páginas tiene función de red alguna, y conviene saberlo: el JSON que la gente compara es tantas veces un archivo de configuración con las credenciales todavía dentro.
Por qué un diff de JSON en crudo es casi todo ruido
A JSON el espacio en blanco le da igual, y al orden de las claves no le da significado. El mismo documento puede ser una línea o cuatrocientas, con las claves en el orden en que se teclearon o en el que las soltó alguna biblioteca, y las herramientas reescriben ambas cosas sin preguntar. Un lado minificado y el otro desplegado; uno guardado a mano y el otro por un serializador que ordena alfabéticamente: un diff de líneas ve dos archivos sin parentesco.
Los dos peores casos bastan para verlo. Un archivo minificado es una línea, así que un diff contra él es una única línea cambiada y gigantesca: verdadero e inútil. Y dos archivos con el mismo contenido en otro orden se comparan como todo-cambió, cuando la respuesta honesta sería «nada».
Son los que evitan que una comparación marque todas las líneas porque un archivo se guardó con otro fin de línea.
Qué arregla la forma canónica del formateador
Pasar los dos archivos por el mismo formateador con los mismos ajustes es justo lo que un diff necesita: una escritura por documento.
La misma sangría pone cada clave en su propia línea: el diff trabaja entonces línea a línea, y sus marcas de palabras pueden señalar el único valor que cambió dentro de una.
Las claves ordenadas ponen los dos lados en el mismo orden, y el orden deja de contar como diferencia. Se ordena por cómo se leen las claves, no por puntos de código — item2 antes que item10 — y se aplica idéntico a ambos lados.
Nada más se mueve. Este formateador conserva los números con los dígitos que escribiste y conserva las claves duplicadas en vez de resolverlas: canonizar no puede inventar por sí mismo una diferencia. La guía del formateador explica por qué eso es más raro de lo que debería.
Una salvedad honesta: la salida ordenada es el documento con las claves movidas. Si alguna herramienta posterior atiende al orden de las claves — pocas lo hacen, pero existen — trata las copias ordenadas como lo que se compara, no como sustituto de los originales.
Leer el resultado, y llevárselo
El comparador marca a la izquierda las líneas quitadas, a la derecha las añadidas, y resalta dentro de una línea cambiada las palabras que difieren: sobre una forma canónica, eso suele ser el único valor que pasó de false a true. El medio sin cambios se pliega a un recuento, así que una configuración de dos mil líneas con tres retoques se lee como tres pasajes cortos.
La descarga es un parche unificado, un .patch: el formato que entiende la revisión de código. Describe las formas canónicas, que suele ser lo que una revisión quiere de todos modos: el cambio, sin el reformateo.
La misma receta sirve para todo lo demás que hablan las dos páginas. YAML y XML se canonizan igual; y para dos archivos de la misma forma venidos de fuentes distintas, los interruptores de ignorar del comparador — espacios, mayúsculas, líneas vacías — son una versión ligera de la misma idea.
Cuatro diferencias reales y nada más. Leerlas es la mitad fácil; el trabajo lo hicieron los ajustes de arriba.
Si haces esto cada semana
Formatear dos veces, pegar dos veces: los pasos viven en dos páginas porque cada página hace un trabajo, y cada una puede demostrar por sí sola que nada de lo que pegaste fue a ninguna parte. Pero las dos son código abierto: licencia MIT, módulos ES sin dependencias — el analizador del formateador conserva orden de claves y dígitos, el diff es el algoritmo de Myers — cada uno con un README que lo explica.
Si esto es parte de tu día, apunta un agente de código al repositorio y pídele una página de dos cajas que canonice mientras compara: parseJson, printJson y compareText están a tres imports. Los módulos se escribieron para leerse, y llevárselos es exactamente para lo que está la licencia.

