簡短的回答
開啟 JSON 格式化,把 JSON 貼進框裡,讀它。排版是你打字的時候就發生的,語言是從文字本身認出來的,縮排預設兩個空格,除非你另有吩咐。什麼都不會被上傳,因為它沒有地方可去:解析器不過是幾百行 JavaScript,跑在你已經開啟的這個分頁裡。
底下所有內容,都是你在把一個配置檔案貼進那些替代品之前值得知道的:一個格式化工具可以改什麼、大多數工具無論如何都改了什麼,以及在檔案根本讀不出來時,那條錯誤該怎麼讀。
格式化是什麼,不是什麼
JSON 幾乎沒有語法。一個物件、一個陣列、一個字串、一個數,再加上 true、false、null 這三個詞。在這些零件之間,空白什麼也不表示:下面這個檔案
{"name":"thing","tags":["local","offline"]}和下面這個檔案
{
  "name": "thing",
  "tags": [
    "local",
    "offline"
  ]
}是同一份文件。格式化就是從前一個走到後一個這件事,整個工作就這麼多。一個格式化工具對你的檔案做的其他任何事——重排、取整、丟掉——都是在沒人要求的情況下,改動了這份文件說的話。
其中三種改動常見到值得點名,因為它們是無聲的,而且正是一個用一下午寫出來的格式化工具預設會做的事。
格式化工具不該改的三樣東西
你的鍵的順序
這是最容易把人絆住的一條。用 JavaScript 寫 JSON 格式化最順手的做法,是先調 JSON.parse,再帶上縮排調 JSON.stringify,而這一對並不保留那些長得像整數的鍵的順序:
Object.keys(JSON.parse('{"10":"a","2":"b","x":"c"}'))
// ['2', '10', 'x']
這不是誰的程式碼有毛病。JavaScript 的物件在規範裡就規定了要把類整數的鍵排在前面、按數值升序排,而凡是經過 JSON.parse 的值都會變成 JavaScript 物件。這麼造出來的格式化工具,會把一份按 id、埠號、年份或者 HTTP 狀態碼作鍵的檔案重排一遍,而且一聲不吭。
這要不要緊,看檔案。JSON 的物件原則上是無序的,所以嚴格說沒壞什麼——但和你儲存庫裡那一版的 diff 會大得離譜,評審根本沒法看,而如果下游有什麼東西是按順序讀這個檔案的,行為就變了。
你的數的位數
JSON 沒說一個數能有多大,JavaScript 說了:每個數都是雙精度。所以一個把數解析成雙精度再列印回去的格式化工具,會丟掉一切雙精度裝不下的東西。
JSON.stringify(JSON.parse('{"id":123456789012345678901}'))
// {"id":123456789012345680000}

JSON.stringify(JSON.parse('{"size":1e999}'))
// {"size":null}
一個二十一位的 id——一個 Twitter id、一個 Snowflake id、一個銀行參考號——回來的時候成了另一個數;而一個大到雙精度裝不下的值,回來的時候成了 null。兩個檔案照樣解析得過,但沒有一個還是你出發時的那個檔案。
出路是根本不去解析數。格式化工具為了把文件排出來,只需要知道一個數從哪裡開始、到哪裡結束,它從來不需要那個值,所以穩妥的做法是把那些數字原樣照抄過去。這裡的工具就是這麼做的。
你重複的鍵
{"a": 1, "a": 2} 是合法的 JSON,而標準拒絕說明這兩個哪個算數。實際上各家解析器意見不一:多數留最後一個,有些留第一個,少數乾脆拒收這份文件。一個悄悄輸出其中之一的格式化工具,替你做了這個決定,還把「這裡本來有兩個」這個有用得多的事實藏了起來——而那幾乎總是檔案裡的一個錯誤,一個你會想看見的錯誤。
檔案讀不出來的時候
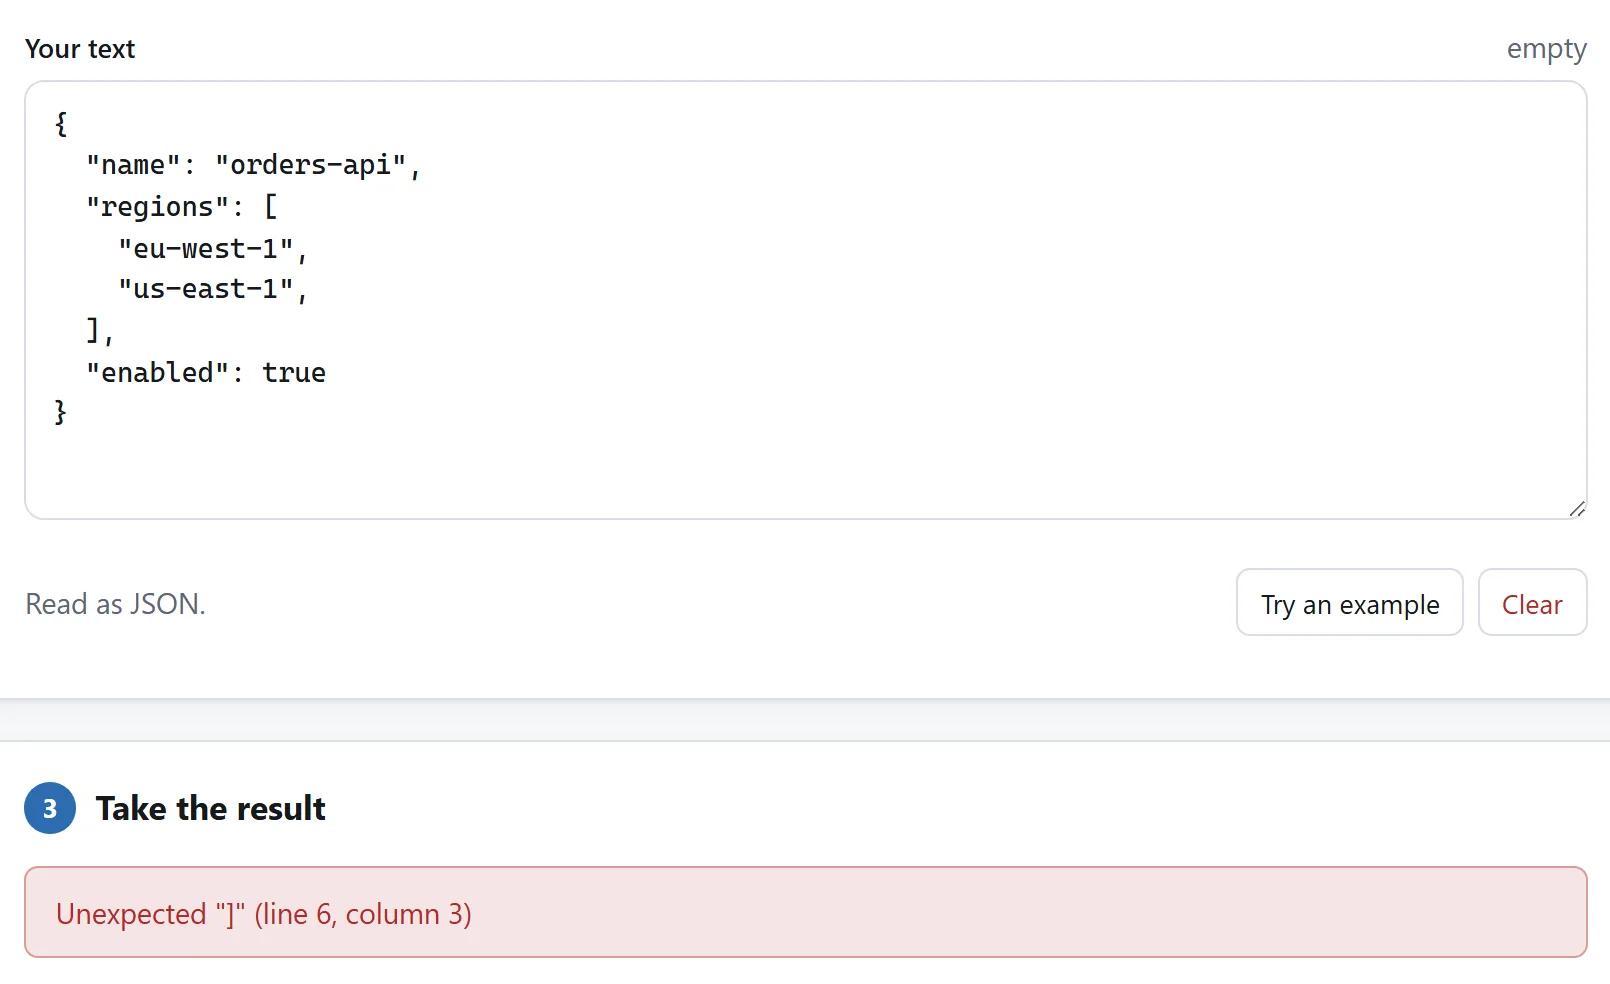
讀不出來的 JSON,絕大多數並不稀奇。它是大約六件事裡的某一件,而只要錯誤資訊用你找得到的方式說清了位置,它就已經告訴你是哪一件了。像 位置 4193 這樣的偏移量不算;行號和列號才算。
- 末尾多出來的逗號。
{"a": 1,}在 JavaScript 裡合法,在 JSON 裡不合法。單一原因裡最常見的一個,通常是刪掉列表最後一項之後留下的。 - 單引號。
{'a': 1}是 JavaScript 的物件字面量,不是 JSON。字串和鍵都用雙引號,而且鍵永遠要帶引號。 - 沒加引號的鍵。
{a: 1},同一個錯誤從另一頭犯起——通常是因為從程式碼裡、而不是從檔案裡貼出來的。 - 註釋。
// 像這樣也不是 JSON。那是 JSONC,VS Code 的設定和tsconfig.json用它,別處一概讀不了。要是一條註釋非留不可,慣例是拿一個鍵來放:"_comment": "..."。 - 字串裡真正的換行或製表符。它們必須寫成
\n和\t。手工把一條 shell 命令或者一份證書貼進某個值裡時,通常就是這裡出差錯。 - JSON 不允許的數。前導零(
01)、光禿禿的小數點(.5)、NaN、Infinity和+1,這些人們都寫,而它們沒有一個是 JSON。
還有一樣不是錯誤、卻長得像錯誤的東西:以位元組序標記開頭的檔案。它在多數編輯器裡看不見,它也不是空白,它讓文件的第一個字元變得出人意料。要是一份看上去毫無問題的檔案報錯在第 1 行第 1 列,那就是它。
壓縮,以及它通常省下的那一點點
把空白擠出去是同一個操作反過來做,而它到底買來了什麼,值得實實在在地看。空白是高度重複的東西,而你和讀者之間的每一臺伺服器、每一個瀏覽器,早就用 gzip 或者 Brotli 把回應壓過一遍了,而它們正好最擅長這種重複。
所以壓過的 JSON 作為檔案常常小三成,線上路上卻只小几個百分點。它真正值回票價的地方,是前面沒有壓縮的那些:資料庫某一列裡的值、日誌一行裡的一個欄位、塞進 QR Code 的內容,或者你正打算 Base64 之後放進請求頭的文件。
它的代價是可讀性,而要是這個檔案進了儲存庫,代價裡還要加上 diff——一個只有一行的檔案,只要裡面有任何東西變了,整行就全變了。壓縮要放在從編輯器出去的路上,不是進來的路上。
給鍵排序,以及什麼時候別排
給每個物件的鍵排序,在這裡是一個選項,而不是預設就做的事,因為那是對檔案的真實改動,而它值不值得,完全取決於你接下來要做什麼。
當你在比較兩份本該說同一件事的文件時它有用——兩個環境的配置、一次改動前後的 API 回應——而其中一份把鍵排成了另一個順序。先把兩份都排一遍,就把「哪裡都不一樣」的 diff 變成了「真正不同的那兩行」的 diff。
當順序本身在承擔某種意義時它有害。package.json 對什麼放在前面是有慣例的;手寫的配置常常把相關的設定擺在一起;而一份被工具排過序又提交上去的檔案,會產出一個巨大而毫無意義的提交。排一份副本,別排原件。
有個細節值得知道:這裡的排序按的是鍵讀起來的樣子,而不是它們的碼位,所以 item2 排在 item10 前面,而不是後面。按碼位排,正是把 item10 塞到一堆 1 開頭的裡頭去的那種排法:技術上沒錯,對讀的人毫無用處。
比較兩個 JSON 檔案
可靠的做法是先把兩份用同樣的方式格式化一遍。兩份說著同一件事的文件,只要一份壓過、另一份沒壓,就能每一行都不一樣,而沒有哪個 diff 能看穿這一層。
所以:格式化第一份,格式化第二份,然後比較這兩個結果。這三步在這裡都在同一個頁面上——比較標籤和格式化共用同一個框,正是為了這個。要是這兩份還把鍵排成了不同的順序,那就在格式化的時候把兩邊都排一遍,比較就會收縮成你本來要找的那點差別。
沒人寫在頁面上的那部分
搜一個 JSON 格式化工具,你會找到幾十個帶輸入框的網站。往那個框裡一貼,就是一次上傳。你剪貼簿裡裝的是什麼都一樣——一份帶著客戶地址的 API 回應、一個帶著連線串的配置檔案、一枚你正在除錯的令牌——它已經被送到一臺不歸你管的機器上,現在它是人家的日誌、人家的錯誤報告、人家的備份。
這不是在假設誰心懷惡意。一個完全出於好意的網站,照樣留訪問日誌,照樣跑統計,照樣有一家託管商。最安全的資料是從來沒離開過的資料,而對一件純粹是字串操作的工作來說,它壓根沒有離開的理由。
兩條檢查,而且它們對任何做出這種宣告的網站都管用,不只是這一個:
- 開啟 DevTools,盯著 Network 標籤,格式化點東西。要是你的文字正在被送出去,就一定有一條請求馱著它。同一時刻不可能有別的解釋。
- 斷開網路再試一次。在你瀏覽器裡運作的工具毫無影響。把你的文字送去別處的工具會立刻、徹底地停擺。
這兩條還有更長的版本,外加另外兩條檢查,都在把檔案傳上去安全嗎那一頁。
那 YAML、XML 和其餘的呢
同一個頁面也讀 XML、HTML、CSS 和 YAML,並且能在 JSON 和其中的第一種與最後一種之間互轉。有兩件事值得從上面帶過來,因為它們不過是同一個道理換了身衣服:
- 把 YAML 轉成 JSON 會丟掉註釋,因為 JSON 沒有地方放註釋。錨點和別名——YAML 用來說「同一個節點出現兩次」的辦法——也沒法表達,所以這裡選擇直接拒絕,而不是替你猜。
-
no是一個字串。在 YAML 1.1 裡,yes、no、on和off是布林值,所以一份含挪威的國家程式碼列表,從前回來時裡面會多出一個false。YAML 1.2 把這條去掉了,這裡也一樣——但這些詞寫回去時仍然帶引號,因為下一個開啟這份檔案的,可能是個 1.1 的讀者。