简短的回答
打开 JSON 格式化,把 JSON 粘进框里,读它。排版是你打字的时候就发生的,语言是从文本本身认出来的,缩进默认两个空格,除非你另有吩咐。什么都不会被上传,因为它没有地方可去:解析器不过是几百行 JavaScript,跑在你已经打开的这个标签页里。
底下所有内容,都是你在把一个配置文件粘进那些替代品之前值得知道的:一个格式化工具可以改什么、大多数工具无论如何都改了什么,以及在文件根本读不出来时,那条错误该怎么读。
格式化是什么,不是什么
JSON 几乎没有语法。一个对象、一个数组、一个字符串、一个数,再加上 true、false、null 这三个词。在这些零件之间,空白什么也不表示:下面这个文件
{"name":"thing","tags":["local","offline"]}和下面这个文件
{
  "name": "thing",
  "tags": [
    "local",
    "offline"
  ]
}是同一份文档。格式化就是从前一个走到后一个这件事,整个活儿就这么多。一个格式化工具对你的文件做的其他任何事——重排、取整、丢掉——都是在没人要求的情况下,改动了这份文档说的话。
其中三种改动常见到值得点名,因为它们是无声的,而且正是一个用一下午写出来的格式化工具默认会做的事。
格式化工具不该改的三样东西
你的键的顺序
这是最容易把人绊住的一条。用 JavaScript 写 JSON 格式化最顺手的做法,是先调 JSON.parse,再带上缩进调 JSON.stringify,而这一对并不保留那些长得像整数的键的顺序:
Object.keys(JSON.parse('{"10":"a","2":"b","x":"c"}'))
// ['2', '10', 'x']
这不是谁的代码有毛病。JavaScript 的对象在规范里就规定了要把类整数的键排在前面、按数值升序排,而凡是经过 JSON.parse 的值都会变成 JavaScript 对象。这么造出来的格式化工具,会把一份按 id、端口号、年份或者 HTTP 状态码作键的文件重排一遍,而且一声不吭。
这要不要紧,看文件。JSON 的对象原则上是无序的,所以严格说没坏什么——但和你仓库里那一版的 diff 会大得离谱,评审根本没法看,而如果下游有什么东西是按顺序读这个文件的,行为就变了。
你的数的位数
JSON 没说一个数能有多大,JavaScript 说了:每个数都是双精度。所以一个把数解析成双精度再打印回去的格式化工具,会丢掉一切双精度装不下的东西。
JSON.stringify(JSON.parse('{"id":123456789012345678901}'))
// {"id":123456789012345680000}

JSON.stringify(JSON.parse('{"size":1e999}'))
// {"size":null}
一个二十一位的 id——一个 Twitter id、一个 Snowflake id、一个银行参考号——回来的时候成了另一个数;而一个大到双精度装不下的值,回来的时候成了 null。两个文件照样解析得过,但没有一个还是你出发时的那个文件。
出路是根本不去解析数。格式化工具为了把文档排出来,只需要知道一个数从哪儿开始、到哪儿结束,它从来不需要那个值,所以稳妥的做法是把那些数字原样照抄过去。这里的工具就是这么做的。
你重复的键
{"a": 1, "a": 2} 是合法的 JSON,而标准拒绝说明这两个哪个算数。实际上各家解析器意见不一:多数留最后一个,有些留第一个,少数干脆拒收这份文档。一个悄悄输出其中之一的格式化工具,替你做了这个决定,还把「这儿本来有两个」这个有用得多的事实藏了起来——而那几乎总是文件里的一个错误,一个你会想看见的错误。
文件读不出来的时候
读不出来的 JSON,绝大多数并不稀奇。它是大约六件事里的某一件,而只要错误信息用你找得到的方式说清了位置,它就已经告诉你是哪一件了。像 位置 4193 这样的偏移量不算;行号和列号才算。
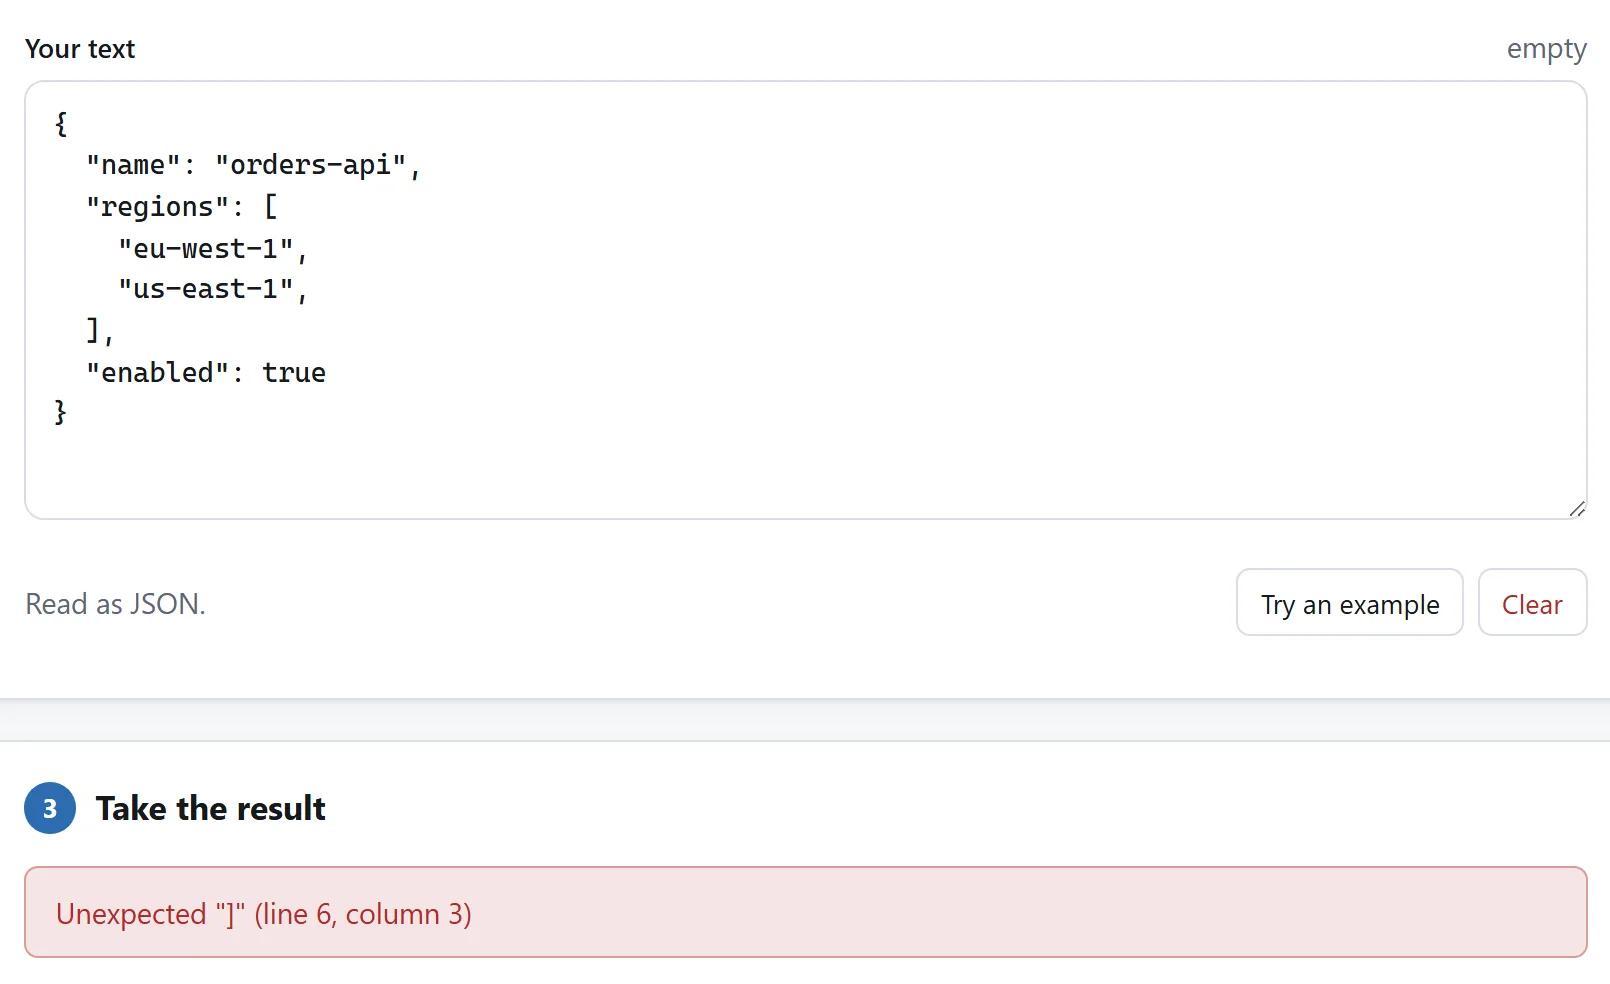
- 末尾多出来的逗号。
{"a": 1,}在 JavaScript 里合法,在 JSON 里不合法。单一原因里最常见的一个,通常是删掉列表最后一项之后留下的。 - 单引号。
{'a': 1}是 JavaScript 的对象字面量,不是 JSON。字符串和键都用双引号,而且键永远要带引号。 - 没加引号的键。
{a: 1},同一个错误从另一头犯起——通常是因为从代码里、而不是从文件里粘出来的。 - 注释。
// 像这样也不是 JSON。那是 JSONC,VS Code 的设置和tsconfig.json用它,别处一概读不了。要是一条注释非留不可,惯例是拿一个键来放:"_comment": "..."。 - 字符串里真正的换行或制表符。它们必须写成
\n和\t。手工把一条 shell 命令或者一份证书粘进某个值里时,通常就是这儿出岔子。 - JSON 不允许的数。前导零(
01)、光秃秃的小数点(.5)、NaN、Infinity和+1,这些人们都写,而它们没有一个是 JSON。
还有一样不是错误、却长得像错误的东西:以字节序标记开头的文件。它在多数编辑器里看不见,它也不是空白,它让文档的第一个字符变得出人意料。要是一份看上去毫无问题的文件报错在第 1 行第 1 列,那就是它。
压缩,以及它通常省下的那一点点
把空白挤出去是同一个操作反过来做,而它到底买来了什么,值得实打实地看。空白是高度重复的东西,而你和读者之间的每一台服务器、每一个浏览器,早就用 gzip 或者 Brotli 把响应压过一遍了,而它们正好最擅长这种重复。
所以压过的 JSON 作为文件常常小三成,在线路上却只小几个百分点。它真正值回票价的地方,是前面没有压缩的那些:数据库某一列里的值、日志一行里的一个字段、塞进二维码的内容,或者你正打算 Base64 之后放进请求头的文档。
它的代价是可读性,而要是这个文件进了仓库,代价里还要加上 diff——一个只有一行的文件,只要里面有任何东西变了,整行就全变了。压缩要放在从编辑器出去的路上,不是进来的路上。
给键排序,以及什么时候别排
给每个对象的键排序,在这儿是一个选项,而不是默认就做的事,因为那是对文件的真实改动,而它值不值得,完全取决于你接下来要干什么。
当你在比较两份本该说同一件事的文档时它有用——两个环境的配置、一次改动前后的 API 响应——而其中一份把键排成了另一个顺序。先把两份都排一遍,就把「哪儿都不一样」的 diff 变成了「真正不同的那两行」的 diff。
当顺序本身在承担某种意义时它有害。package.json 对什么放在前面是有惯例的;手写的配置常常把相关的设置摆在一起;而一份被工具排过序又提交上去的文件,会产出一个巨大而毫无意义的提交。排一份副本,别排原件。
有个细节值得知道:这里的排序按的是键读起来的样子,而不是它们的码位,所以 item2 排在 item10 前面,而不是后面。按码位排,正是把 item10 塞到一堆 1 开头的里头去的那种排法:技术上没错,对读的人毫无用处。
比较两个 JSON 文件
靠谱的做法是先把两份用同样的方式格式化一遍。两份说着同一件事的文档,只要一份压过、另一份没压,就能每一行都不一样,而没有哪个 diff 能看穿这一层。
所以:格式化第一份,格式化第二份,然后比较这两个结果。这三步在这儿都在同一个页面上——比较标签和格式化共用同一个框,正是为了这个。要是这两份还把键排成了不同的顺序,那就在格式化的时候把两边都排一遍,比较就会收缩成你本来要找的那点差别。
没人写在页面上的那部分
搜一个 JSON 格式化工具,你会找到几十个带输入框的网站。往那个框里一粘,就是一次上传。你剪贴板里装的是什么都一样——一份带着客户地址的 API 响应、一个带着连接串的配置文件、一枚你正在调试的令牌——它已经被送到一台不归你管的机器上,现在它是人家的日志、人家的错误报告、人家的备份。
这不是在假设谁心怀恶意。一个完全出于好意的网站,照样留访问日志,照样跑统计,照样有一家托管商。最安全的数据是从来没离开过的数据,而对一件纯粹是字符串操作的活儿来说,它压根没有离开的理由。
两条检查,而且它们对任何做出这种声明的网站都管用,不只是这一个:
- 打开 DevTools,盯着 Network 标签,格式化点东西。要是你的文本正在被送出去,就一定有一条请求驮着它。同一时刻不可能有别的解释。
- 断开网络再试一次。在你浏览器里干活的工具毫无影响。把你的文本送去别处的工具会立刻、彻底地停摆。
这两条还有更长的版本,外加另外两条检查,都在把文件传上去安全吗那一页。
那 YAML、XML 和其余的呢
同一个页面也读 XML、HTML、CSS 和 YAML,并且能在 JSON 和其中的第一种与最后一种之间互转。有两件事值得从上面带过来,因为它们不过是同一个道理换了身衣服:
- 把 YAML 转成 JSON 会丢掉注释,因为 JSON 没有地方放注释。锚点和别名——YAML 用来说「同一个节点出现两次」的办法——也没法表达,所以这里选择直接拒绝,而不是替你猜。
-
no是一个字符串。在 YAML 1.1 里,yes、no、on和off是布尔值,所以一份含挪威的国家代码列表,从前回来时里面会多出一个false。YAML 1.2 把这条去掉了,这里也一样——但这些词写回去时仍然带引号,因为下一个打开这份文件的,可能是个 1.1 的读者。