La réponse courte
Ouvrez Texte & code, collez le JSON dans la zone, et lisez-le. La mise en forme se fait à la frappe, le langage est déduit du texte, et l'indentation est de deux espaces sauf avis contraire. Rien n'est envoyé, parce qu'il n'y a nulle part où aller : l'analyseur, ce sont quelques centaines de lignes de JavaScript qui tournent dans l'onglet déjà ouvert devant vous.
Tout ce qui suit est ce qu'il vaut la peine de savoir avant de coller un fichier de configuration dans l'une des solutions concurrentes : ce qu'un formateur a le droit de changer, ce que la plupart changent quand même, et comment lire l'erreur quand le fichier refuse d'être analysé.
Ce qu'est le formatage, et ce qu'il n'est pas
JSON n'a presque pas de syntaxe. Un objet, un tableau, une chaîne, un nombre, et les trois mots true, false et null. Entre ces éléments, les espaces ne veulent rien dire : le fichier
{"name":"thing","tags":["local","offline"]}et le fichier
{
  "name": "thing",
  "tags": [
    "local",
    "offline"
  ]
}
sont le même document. Formater, c'est passer du premier au second, et c'est tout le travail. Tout ce qu'un formateur fait d'autre à votre fichier — réordonner, arrondir, laisser tomber — est un changement de ce que le document dit, opéré sans qu'on l'ait demandé.
Trois de ces changements sont assez fréquents pour être nommés, parce qu'ils sont silencieux et parce que c'est ce que fait par défaut un formateur écrit en un après-midi.
Les trois choses qu'un formateur ne doit pas changer
L'ordre de vos clés
C'est celle qui piège tout le monde. La façon évidente d'écrire un formateur JSON en JavaScript est d'appeler JSON.parse puis JSON.stringify avec une indentation, et ce duo ne conserve pas l'ordre des clés qui ressemblent à des entiers :
Object.keys(JSON.parse('{"10":"a","2":"b","x":"c"}'))
// ['2', '10', 'x']
Ce n'est le bug de personne. Les objets JavaScript sont spécifiés pour placer d'abord les clés de type entier, en ordre numérique croissant, et toute valeur qui passe par JSON.parse devient un objet JavaScript. Un formateur bâti ainsi remaniera un fichier indexé par identifiant, par numéro de port, par année ou par code d'état HTTP, et il le fera sans un mot.
Que cela compte ou non dépend du fichier. Les objets JSON sont en principe sans ordre, donc techniquement rien n'est cassé — mais le diff avec la version de votre dépôt sera énorme, la relecture illisible, et si quoi que ce soit en aval lit le fichier dans l'ordre, le comportement change.
Les chiffres de vos nombres
JSON ne dit pas quelle taille un nombre peut avoir, et JavaScript si : tout nombre est un double. Un formateur qui analyse en double et réimprime perd donc tout ce qu'un double ne peut pas contenir.
JSON.stringify(JSON.parse('{"id":123456789012345678901}'))
// {"id":123456789012345680000}

JSON.stringify(JSON.parse('{"size":1e999}'))
// {"size":null}
Un identifiant de vingt-et-un chiffres — un identifiant Twitter, un identifiant Snowflake, une référence bancaire — revient sous la forme d'un autre nombre, et une valeur trop grande pour un double revient en null. Les deux fichiers s'analysent toujours, et aucun des deux n'est le fichier de départ.
La solution est de ne pas analyser les nombres du tout. Un formateur a seulement besoin de savoir où un nombre commence et où il finit pour poser le document ; il n'a jamais besoin de sa valeur, donc la chose sûre est de recopier les chiffres exactement tels qu'ils étaient écrits. C'est ce que fait l'outil d'ici.
Vos clés en double
{"a": 1, "a": 2} est du JSON valide, et la norme se refuse à dire laquelle des deux l'emporte. En pratique, les analyseurs ne sont pas d'accord : la plupart gardent la dernière, certains la première, quelques-uns refusent le document. Un formateur qui en émet une en silence a pris cette décision à votre place, et a caché le fait bien plus utile qu'il y en avait deux — ce qui est presque toujours une erreur dans le fichier, et une erreur qu'on veut voir.
Quand le fichier refuse d'être analysé
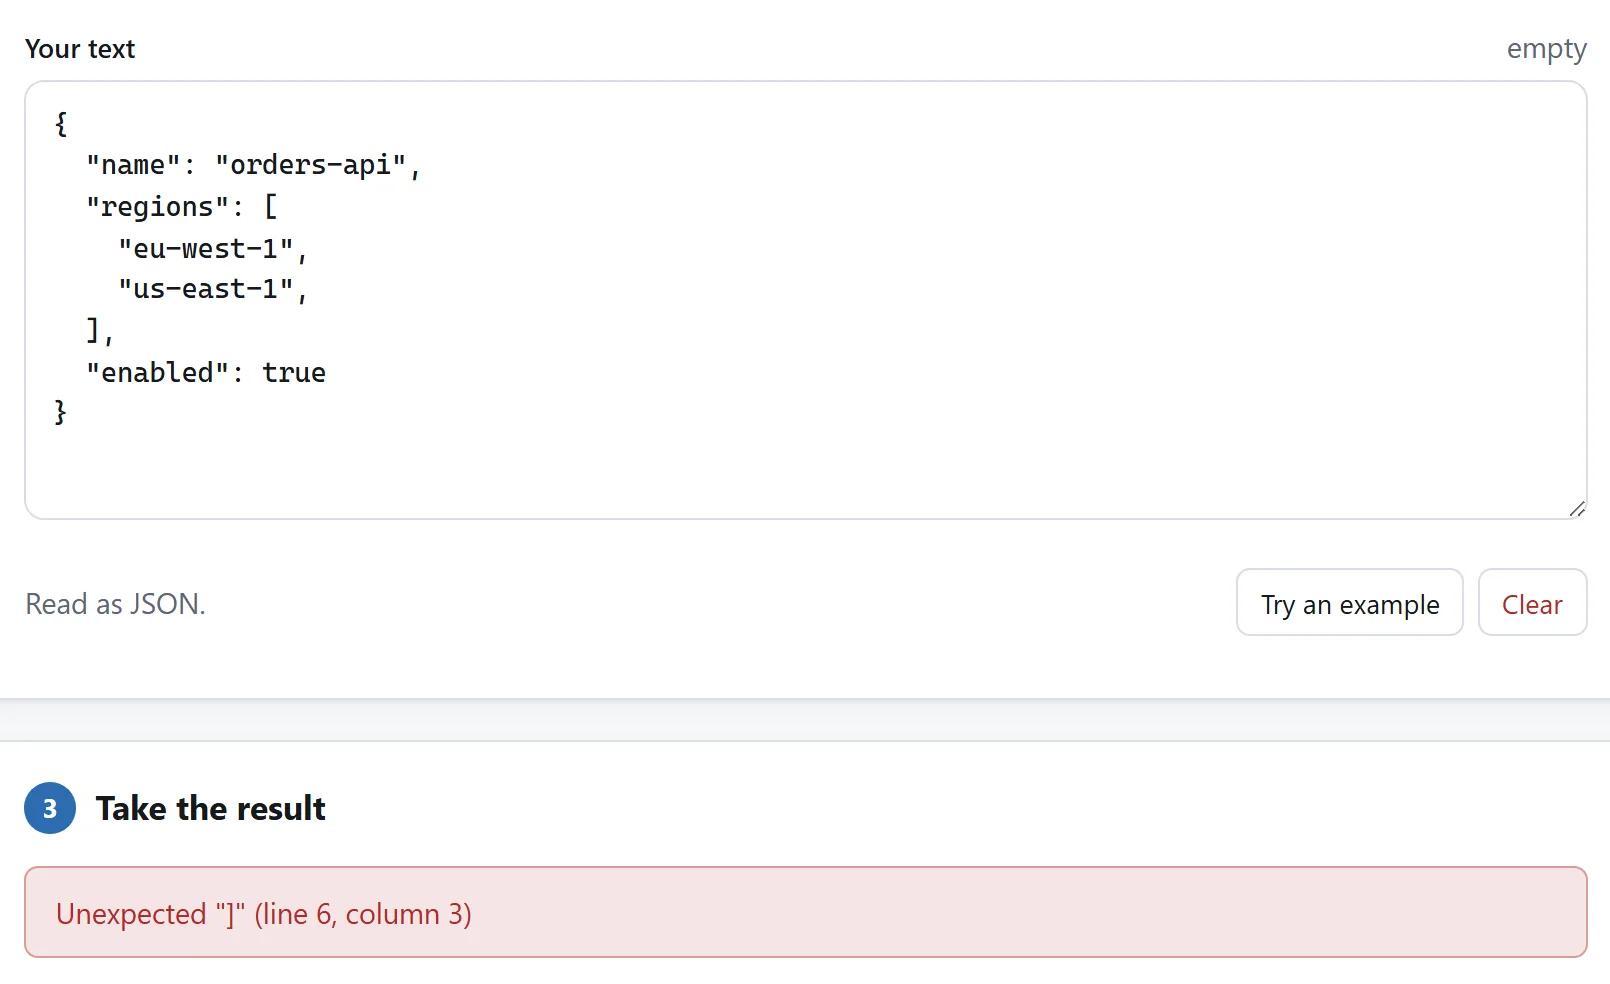
La plupart des JSON qui échouent n'ont rien d'exotique. C'est l'une d'à peu près six choses, et l'erreur vous dit laquelle si elle indique l'endroit dans des termes que vous pouvez retrouver. Un décalage du genre position 4193, non ; une ligne et une colonne, oui.
- Une virgule en trop à la fin.
{"a": 1,}est licite en JavaScript et pas en JSON. La cause unique la plus fréquente, laissée d'ordinaire par la suppression de la dernière entrée d'une liste. - Des apostrophes.
{'a': 1}est un littéral d'objet JavaScript, pas du JSON. Les chaînes et les clés sont toutes deux entre guillemets doubles, et les clés sont toujours entre guillemets. - Une clé sans guillemets.
{a: 1}, la même erreur dans l'autre sens — souvent parce qu'on a collé quelque chose venu du code plutôt que d'un fichier. - Des commentaires.
// like thisn'est pas du JSON non plus. C'est du JSONC, qu'utilisent les réglages de VS Code ettsconfig.json, et il ne s'analysera nulle part ailleurs. Si un commentaire doit survivre, la convention est une clé :"_comment": "...". - Un vrai saut de ligne ou une tabulation dans une chaîne. Ils doivent s'écrire
\net\t. C'est ce qui cloche d'ordinaire quand une commande shell ou un certificat a été collé à la main dans une valeur. - Un nombre que JSON n'autorise pas. Les zéros en tête (
01), un point décimal tout seul (.5),NaN,Infinityet+1sont des choses que les gens écrivent, et aucune n'est du JSON.
Une chose qui n'est pas une erreur et qui y ressemble : un fichier qui commence par une marque d'ordre des octets. Elle est invisible dans la plupart des éditeurs, ce n'est pas un espace, et elle rend inattendu le tout premier caractère du document. Si l'erreur est en ligne 1, colonne 1 sur un fichier qui paraît parfait, c'est cela.
Minifier, et le peu que cela rapporte d'ordinaire
Chasser les espaces est la même opération à l'envers, et il vaut mieux être réaliste sur ce que cela apporte. Les espaces sont extrêmement répétitifs, et tous les serveurs et navigateurs entre vous et un lecteur compressent déjà la réponse en gzip ou en Brotli, ce qui excelle précisément sur ce genre de répétition.
Un JSON minifié est donc souvent trente pour cent plus léger comme fichier et quelques pour cent seulement sur le réseau. Là où cela gagne vraiment sa place, c'est là où il n'y a aucune compression devant : une valeur dans une colonne de base de données, un champ dans une ligne de journal, une charge utile dans un QR code, ou un document que vous vous apprêtez à passer en Base64 dans un en-tête.
Ce que cela coûte, c'est la lisibilité, et si le fichier est versionné cela vous coûte aussi les diffs — un fichier d'une seule ligne change entièrement dès que quoi que ce soit change dedans. Minifiez à la sortie de votre éditeur, pas à l'entrée.
Trier les clés, et quand s'en abstenir
Trier les clés de chaque objet est proposé ici en option plutôt qu'appliqué d'office, parce que c'est un vrai changement du fichier et que son intérêt dépend entièrement de ce que vous allez faire ensuite.
Cela aide quand vous comparez deux documents censés dire la même chose — la configuration de deux environnements, une réponse d'API avant et après un changement — et que l'un liste ses clés dans un autre ordre. Trier les deux d'abord transforme un diff de tout en un diff des deux lignes qui diffèrent réellement.
Cela nuit quand l'ordre servait à quelque chose. Un package.json a ses conventions sur ce qui vient d'abord ; une configuration écrite à la main regroupe souvent les réglages apparentés ; et un fichier dont un outil a trié les clés avant qu'on le valide produit un unique commit énorme et sans intérêt. Triez une copie, pas l'original.
Un détail bon à connaître : le tri se fait ici selon la façon dont les clés se lisent plutôt que selon leurs points de code, donc item2 passe avant item10 et non après. Trier par point de code, c'est ce qui met item10 au milieu des « un quelque chose », ce qui est techniquement exact et inutile pour un lecteur.
Comparer deux fichiers JSON
La méthode fiable est de formater les deux de la même façon d'abord. Deux documents qui disent la même chose peuvent différer à chaque ligne si l'un a été minifié et l'autre non, et aucun diff ne voit au-delà de cela.
Donc : formatez le premier, formatez le second, puis comparez les deux résultats. Les trois étapes sont ici sur la même page — l'onglet Comparer partage la zone avec Formater précisément pour cela. Si en plus les deux listent leurs clés dans des ordres différents, triez-les toutes deux en les formatant et la comparaison se réduit à la différence que vous cherchiez.
La partie que personne ne met sur la page
Cherchez un formateur JSON et vous trouverez des dizaines de sites avec une zone de texte. Coller dans cette zone est un envoi. Ce qui se trouvait dans votre presse-papiers — une réponse d'API contenant l'adresse d'un client, un fichier de configuration avec une chaîne de connexion, un jeton que vous étiez en train de déboguer — a été transmis à une machine que vous ne contrôlez pas, et le voilà dans leur journal, dans leur rapport d'erreur et dans leur sauvegarde.
Ce n'est pas une hypothèse sur la malveillance. Un site parfaitement bien intentionné garde tout de même des journaux d'accès, fait tout de même de l'analytique, et a tout de même un hébergeur. Les données les plus sûres sont celles qui ne sont jamais parties, et pour un travail qui n'est que de la manipulation de texte, il n'y a aucune raison qu'elles partent.
Deux vérifications, valables pour n'importe quel site qui fait cette promesse, pas seulement celui-ci :
- Ouvrez les DevTools, surveillez l'onglet réseau, et formatez quelque chose. Si votre texte part, une requête le transporte. Rien d'autre ne peut être vrai en même temps.
- Coupez internet et recommencez. Un outil qui travaille dans votre navigateur n'y voit que du feu. Un outil qui envoie votre texte quelque part cesse de fonctionner, immédiatement et complètement.
Il y a une version plus longue des deux, avec deux vérifications supplémentaires, dans est-il sûr d'envoyer ses fichiers.
Et YAML, XML et le reste ?
La même page lit XML, HTML, CSS et YAML, et convertit entre JSON et le premier et le dernier d'entre eux. Deux choses méritent d'être reprises d'en haut, car c'est le même argument dans un autre costume :
- Convertir du YAML en JSON perd les commentaires, parce que JSON n'a nulle part où en mettre un. Les ancres et les alias — la façon qu'a YAML de dire « le même nœud deux fois » — ne peuvent pas non plus être exprimés, et sont refusés ici plutôt que devinés.
-
noest une chaîne. En YAML 1.1,yes,no,onetoffétaient des booléens, ce qui explique qu'une liste de codes pays contenant la Norvège revenait autrefois avec unfalsededans. YAML 1.2 a abandonné cela, et cet outil aussi — mais ces mots sont tout de même réécrits entre guillemets, parce que ce qui ouvrira le fichier ensuite peut être un lecteur 1.1.