La risposta corta
Apri Testo e codice, incolla il JSON nella casella, e leggilo. L'impaginazione avviene mentre scrivi, il linguaggio viene capito dal testo, e il rientro è di due spazi finché non dici altrimenti. Non viene caricato niente, perché non c'è nessun posto dove andare: il parser sono qualche centinaio di righe di JavaScript che girano nella scheda che hai già aperta.
Tutto quello che segue è quanto vale la pena sapere prima di incollare un file di configurazione in una qualsiasi delle alternative: cosa a un formattatore è permesso cambiare, cosa cambiano lo stesso quasi tutti, e come si legge l'errore quando il file non si lascia proprio leggere.
Cos'è formattare, e cosa non è
JSON non ha quasi sintassi. Un oggetto, un array, una stringa, un numero, e le tre parole true, false e null. Fra quei pezzi, gli spazi non vogliono dire niente: il file
{"name":"thing","tags":["local","offline"]}e il file
{
  "name": "thing",
  "tags": [
    "local",
    "offline"
  ]
}
sono lo stesso documento. Formattare è passare dal primo al secondo, e il lavoro è tutto lì. Qualsiasi altra cosa un formattatore faccia al tuo file — riordinare, arrotondare, buttare via — è un cambiamento a quello che il documento dice, fatto senza che nessuno lo chiedesse.
Tre di quei cambiamenti sono abbastanza comuni da meritare un nome, perché sono silenziosi e perché sono quello che fa di suo un formattatore scritto in un pomeriggio.
Le tre cose che un formattatore non deve cambiare
L'ordine delle tue chiavi
Questa è quella che frega la gente. Il modo ovvio di scrivere un formattatore JSON in JavaScript è chiamare JSON.parse e poi JSON.stringify con un rientro, e quella coppia non conserva l'ordine delle chiavi che sembrano numeri interi:
Object.keys(JSON.parse('{"10":"a","2":"b","x":"c"}'))
// ['2', '10', 'x']
Non è un errore nel codice di nessuno. Gli oggetti JavaScript sono specificati per mettere per prime le chiavi che sembrano interi, in ordine numerico crescente, e ogni valore che passa da JSON.parse diventa un oggetto JavaScript. Un formattatore costruito così rimescolerà un file indicizzato per id, per numero di porta, per anno o per codice di stato HTTP, e lo farà senza dire una parola.
Se conti o no dipende dal file. Gli oggetti JSON in linea di principio non hanno ordine, quindi tecnicamente non si rompe niente — ma il diff contro la versione nel tuo repository sarà enorme, la revisione illeggibile, e se qualcosa più a valle legge il file in ordine, il comportamento cambia.
Le cifre dei tuoi numeri
JSON non dice quanto grande può essere un numero, e JavaScript sì: ogni numero è un double. Quindi un formattatore che legge in un double e lo ristampa perde tutto quello che un double non riesce a tenere.
JSON.stringify(JSON.parse('{"id":123456789012345678901}'))
// {"id":123456789012345680000}

JSON.stringify(JSON.parse('{"size":1e999}'))
// {"size":null}
Un id da ventun cifre — un id di Twitter, uno Snowflake, un riferimento bancario — torna indietro come un numero diverso, e un valore troppo grande per un double torna come null. Tutti e due i file si leggono ancora, e nessuno dei due è il file da cui eri partito.
La via d'uscita è non leggere affatto i numeri. A un formattatore serve solo sapere dove un numero comincia e finisce per impaginare il documento; il suo valore non gli serve mai, quindi la cosa sicura è copiare le cifre esattamente come erano scritte. È quello che fa lo strumento qui.
Le tue chiavi doppie
{"a": 1, "a": 2} è JSON valido, e lo standard si rifiuta di dire quale delle due vince. Nella pratica i parser non sono d'accordo: quasi tutti tengono l'ultima, alcuni la prima, qualcuno rifiuta il documento. Un formattatore che ne stampa una in silenzio ha preso quella decisione al posto tuo, e ha nascosto il fatto ben più utile che ce n'erano due — che quasi sempre è un errore nel file, e uno che vorresti vedere.
Quando il file non si lascia leggere
Quasi tutto il JSON che fallisce non ha niente di esotico. È una di sei cose circa, e l'errore ti dice quale, se dice dov'è in termini che puoi trovare. Uno scostamento tipo posizione 4193 non lo fa; una riga e una colonna sì.
- Una virgola di troppo alla fine.
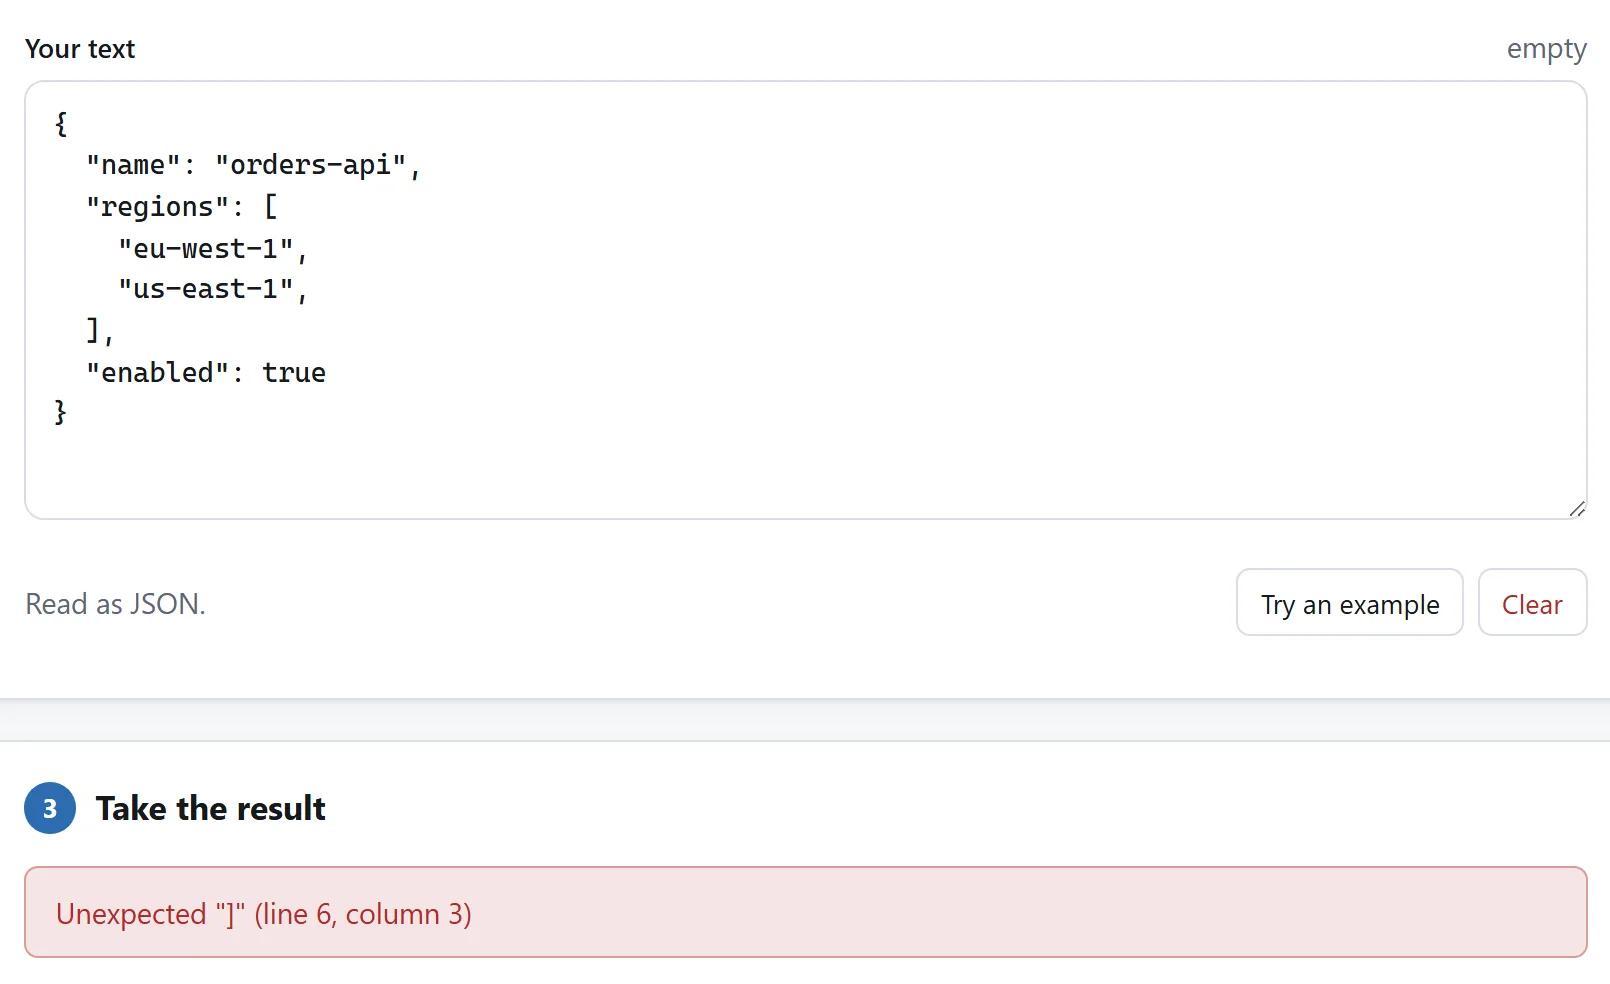
{"a": 1,}è lecito in JavaScript e non in JSON. La singola causa più frequente, di solito lasciata lì da chi ha cancellato l'ultima voce di un elenco. - Apici singoli.
{'a': 1}è un letterale di oggetto JavaScript, non JSON. Stringhe e chiavi vanno entrambe fra virgolette doppie, e le chiavi vanno sempre fra virgolette. - Una chiave senza virgolette.
{a: 1}, lo stesso errore dall'altro verso — di solito perché si è incollato qualcosa preso dal codice invece che da un file. - Commenti.
// cosìnon è JSON nemmeno lui. È JSONC, quello che usano le impostazioni di VS Code etsconfig.json, e altrove non si legge. Se un commento deve sopravvivere, la convenzione è una chiave:"_comment": "...". - Un vero a capo o una tabulazione dentro a una stringa. Vanno scritti come
\ne\t. È quello che di solito va storto quando un comando da terminale o un certificato sono stati incollati a mano dentro a un valore. - Un numero che JSON non ammette. Gli zeri iniziali (
01), un punto decimale da solo (.5),NaN,Infinitye+1sono tutte cose che la gente scrive, e nessuna di loro è JSON.
Una che non è un errore e ci somiglia: un file che comincia con un contrassegno dell'ordine dei byte. Nella maggior parte degli editor è invisibile, non è uno spazio, e rende inatteso il primissimo carattere del documento. Se l'errore è a riga 1, colonna 1 su un file che sembra perfetto, è quello.
Minificare, e quanto poco di solito rende
Spremere via gli spazi è la stessa operazione al contrario, e conviene essere realisti su cosa ci si guadagna. Gli spazi si ripetono moltissimo, e ogni server e ogni browser fra te e chi legge comprimono già la risposta con gzip o Brotli, che su quel tipo di ripetizione vanno benissimo.
Quindi il JSON minificato spesso è più piccolo del trenta per cento come file e solo di qualche punto percentuale sul filo. I posti dove si ripaga davvero sono quelli senza compressione davanti: un valore in una colonna di database, un campo dentro a una riga di log, un contenuto dentro a un codice QR, o un documento che stai per mettere in Base64 dentro a un'intestazione.
Quello che costa è la leggibilità, e se il file sta in un repository ti costa anche i diff — un file su una riga sola cambia tutto ogni volta che dentro cambia qualcosa. Minifica in uscita dall'editor, non in entrata.
Ordinare le chiavi, e quando invece no
Ordinare le chiavi di ogni oggetto qui è un'opzione e non una cosa applicata di default, perché è un cambiamento vero al file e il suo valore dipende tutto da cosa stai per fare.
Aiuta quando stai confrontando due documenti che dovrebbero dire la stessa cosa — la configurazione di due ambienti, la risposta di un'API prima e dopo una modifica — e uno dei due elenca le chiavi in un altro ordine. Ordinarli entrambi prima trasforma un diff di tutto in un diff delle due righe che davvero cambiano.
Fa danno quando l'ordine stava facendo qualcosa. Un package.json ha delle convenzioni su cosa viene prima; una configurazione scritta a mano spesso tiene vicine le impostazioni imparentate; e un file a cui uno strumento ha ordinato le chiavi e che poi è stato committato produce un unico commit enorme e senza senso. Ordina una copia, non l'originale.
Un dettaglio che vale la pena sapere: qui l'ordinamento va per come le chiavi si leggono e non per i loro punti di codice, quindi item2 viene prima di item10 e non dopo. Ordinare per punto di codice è quello che infila item10 in mezzo agli uno, il che è tecnicamente corretto e inutile per chi legge.
Confrontare due file JSON
Il modo affidabile è formattarli tutti e due allo stesso modo prima. Due documenti che dicono la stessa cosa possono differire su ogni riga se uno era minificato e l'altro no, e nessun diff riesce a vedere oltre.
Quindi: formatta il primo, formatta il secondo, poi confronta i due risultati. Tutti e tre i passaggi qui stanno sulla stessa pagina — la scheda Confronta divide la casella con Formatta proprio per questo. Se poi i due elencano le chiavi in ordini diversi, ordinale entrambe mentre le formatti e il confronto si stringe sulla differenza che cercavi.
La parte che nessuno scrive sulla pagina
Cerca un formattatore JSON e troverai decine di siti con una casella. Incollare in quella casella è un caricamento. Qualsiasi cosa ci fosse nei tuoi appunti — la risposta di un'API con dentro l'indirizzo di un cliente, un file di configurazione con una stringa di connessione, un token che stavi guardando — è stata mandata a una macchina che non controlli, e adesso è il loro file di log, la loro segnalazione di errore e il loro backup.
Non è un'ipotesi sulla malafede. Un sito perfettamente in buona fede tiene comunque i log degli accessi, fa comunque analytics, e ha comunque un fornitore di hosting. I dati più sicuri sono quelli che non sono mai partiti, e per un lavoro che è tutto manipolazione di testo non c'è nessuna ragione perché partano.
Due controlli, e funzionano su qualsiasi sito faccia questa promessa, non solo su questo:
- Apri i DevTools, guarda la scheda Rete, e formatta qualcosa. Se il tuo testo viene spedito, c'è una richiesta che se lo porta. Nient'altro può essere vero nello stesso momento.
- Stacca internet e riprova. Uno strumento che fa il lavoro nel tuo browser non se ne accorge nemmeno. Uno strumento che manda il tuo testo da qualche parte smette di funzionare, subito e del tutto.
Di entrambi c'è una versione più lunga, con altri due controlli, in è sicuro caricare i propri file.
E YAML, XML e il resto?
La stessa pagina legge XML, HTML, CSS e YAML, e converte fra JSON e il primo e l'ultimo di quelli. Due cose vale la pena portarsele dietro da sopra, perché sono lo stesso discorso in un altro vestito:
- Convertire YAML in JSON perde i commenti, perché JSON non ha nessun posto dove metterne uno. Ancore e alias — il modo che ha YAML di dire «lo stesso nodo due volte» — non si possono esprimere nemmeno loro, e qui vengono rifiutati invece che indovinati.
-
noè una stringa. In YAML 1.1yes,no,oneofferano booleani, ed è per questo che un elenco di codici di paese che conteneva la Norvegia tornava indietro con dentro unfalse. YAML 1.2 ha lasciato perdere, e così fa questo — ma quelle parole vengono comunque riscritte fra virgolette, perché quello che aprirà il file dopo di te potrebbe essere un lettore 1.1.