यह काम शायद ही कभी एक पन्ने का होता है। यह अनुबंध और उसका हस्ताक्षर वाला पन्ना है, या साल भर की रसीदें, और आखिर में एक इनबॉक्स जो कुछ मेगाबाइट से ऊपर की हर चीज़ लौटा देता है। तीन टूल पूरा रास्ता तय करते हैं, और कागज़ात पूरे रास्ते आपकी अपनी मशीन पर रहते हैं।
# कई पन्ने एक छोटे PDF में कैसे स्कैन करें
यह काम शायद ही कभी एक पन्ने का होता है। यह अनुबंध और उसका हस्ताक्षर वाला पन्ना है, या साल भर की रसीदें, और आखिर में एक इनबॉक्स जो कुछ मेगाबाइट से ऊपर की हर चीज़ लौटा देता है। तीन टूल पूरा रास्ता तय करते हैं, और कागज़ात पूरे रास्ते आपकी अपनी मशीन पर रहते हैं।
आखिरी अपडेट 26 अगस्त 2026
## छोटा जवाब
हर पन्ने की फ़ोटो लीजिए, फिर सारी फ़ोटो एक साथ [दस्तावेज़ स्कैनर](https://abox.tools/hi/document-scanner/) पर डाल दीजिए। वह हर पन्ने के कोने ढूँढ़ता है, हर फ़ोटो सीधी करता है, और *हर फ़ोटो का एक पन्ना वाला एक PDF* लिख देता है — जोड़ने का कोई अलग कदम है ही नहीं, और पन्ने उसी क्रम में बैठते हैं जिसमें आपने जोड़े।
जहाँ स्कैनर रुकता है, वहाँ से दो टूल सँभालते हैं। दस्तावेज़ का कोई हिस्सा पहले से PDF *हो* — ईमेल से आया अनुबंध, बीच में आपका अभी स्कैन किया हस्ताक्षर वाला पन्ना — तो दोनों को [PDF मर्जर](https://abox.tools/hi/merge-pdf/) से गूँथ दीजिए। और बनी फ़ाइल अब भी इनबॉक्स की इजाज़त से बड़ी हो, तो [PDF कंप्रेसर](https://abox.tools/hi/compress-pdf/) उसे सीमा के नीचे ले आता है।
दोनों जोड़ एक क्लिक की दूरी पर हैं: स्कैनर के PDF लिखते ही डाउनलोड बटन के नीचे एक पंक्ति नतीजा सीधे मिलाने वाले या संपीड़क तक ले जाने की पेशकश करती है, पहले से लदा हुआ — और मिलाने वाला अपना नतीजा उसी तरह संपीड़क को सौंप देता है।
कड़ी में कुछ भी कुछ अपलोड नहीं करता। यह बात यहाँ लगभग हर जगह से ज़्यादा मायने रखती है: स्कैन होते हैं अनुबंध, पहचान-पत्र और मेडिकल कागज़ात, और इस काम के आम ऐप हर पन्ना अपने सर्वरों से गुज़ारते हैं।
## फ़ोटो सही लेना
स्कैनर हैरतअंगेज़ हद तक बचा लेता है — तिरछे शॉट, ऊँची-नीची लैंप की रोशनी, पन्ने पर आड़ी परछाईं — मगर जो कैमरे ने पकड़ा ही नहीं, उसे वह नहीं बचा सकता। तीन आदतें ज़्यादातर सँभाल लेती हैं:
- **फ़्रेम भरिए**, हर किनारे के गिर्द मेज़ की थोड़ी झलक छोड़कर। कोने पन्ने को पृष्ठभूमि के मुकाबले खोजकर मिलते हैं; जो पन्ना फ़ोटो से बाहर बह जाए, उसका कोई कोना खोजने को बचता ही नहीं।
- **ऊपर से खींचिए**, लगभग सीध में। परिप्रेक्ष्य सुधर जाता है, मगर तिरछे शॉट के दूर वाले किनारे में पिक्सेल कम होते हैं, और सुधार पिक्सेल गढ़ नहीं सकता।
- **एक फ़ोटो में एक पन्ना**, पढ़ने के क्रम में। बाद में क्रम बदलना भी चलता है, पर जिस क्रम में आप खींचते हैं वही क्रम आपको मिलता है, और क्रम से खींचना मुफ़्त है।
बाकी [स्कैन गाइड](https://abox.tools/hi/guides/scan-a-document-with-your-phone/) में है — कोने कैसे मिलते हैं, कब उन्हें खुद खींचना चाहिए, और ब्लैक-ऐंड-व्हाइट मोड फ़ाइल-आकार के साथ क्या करता है।
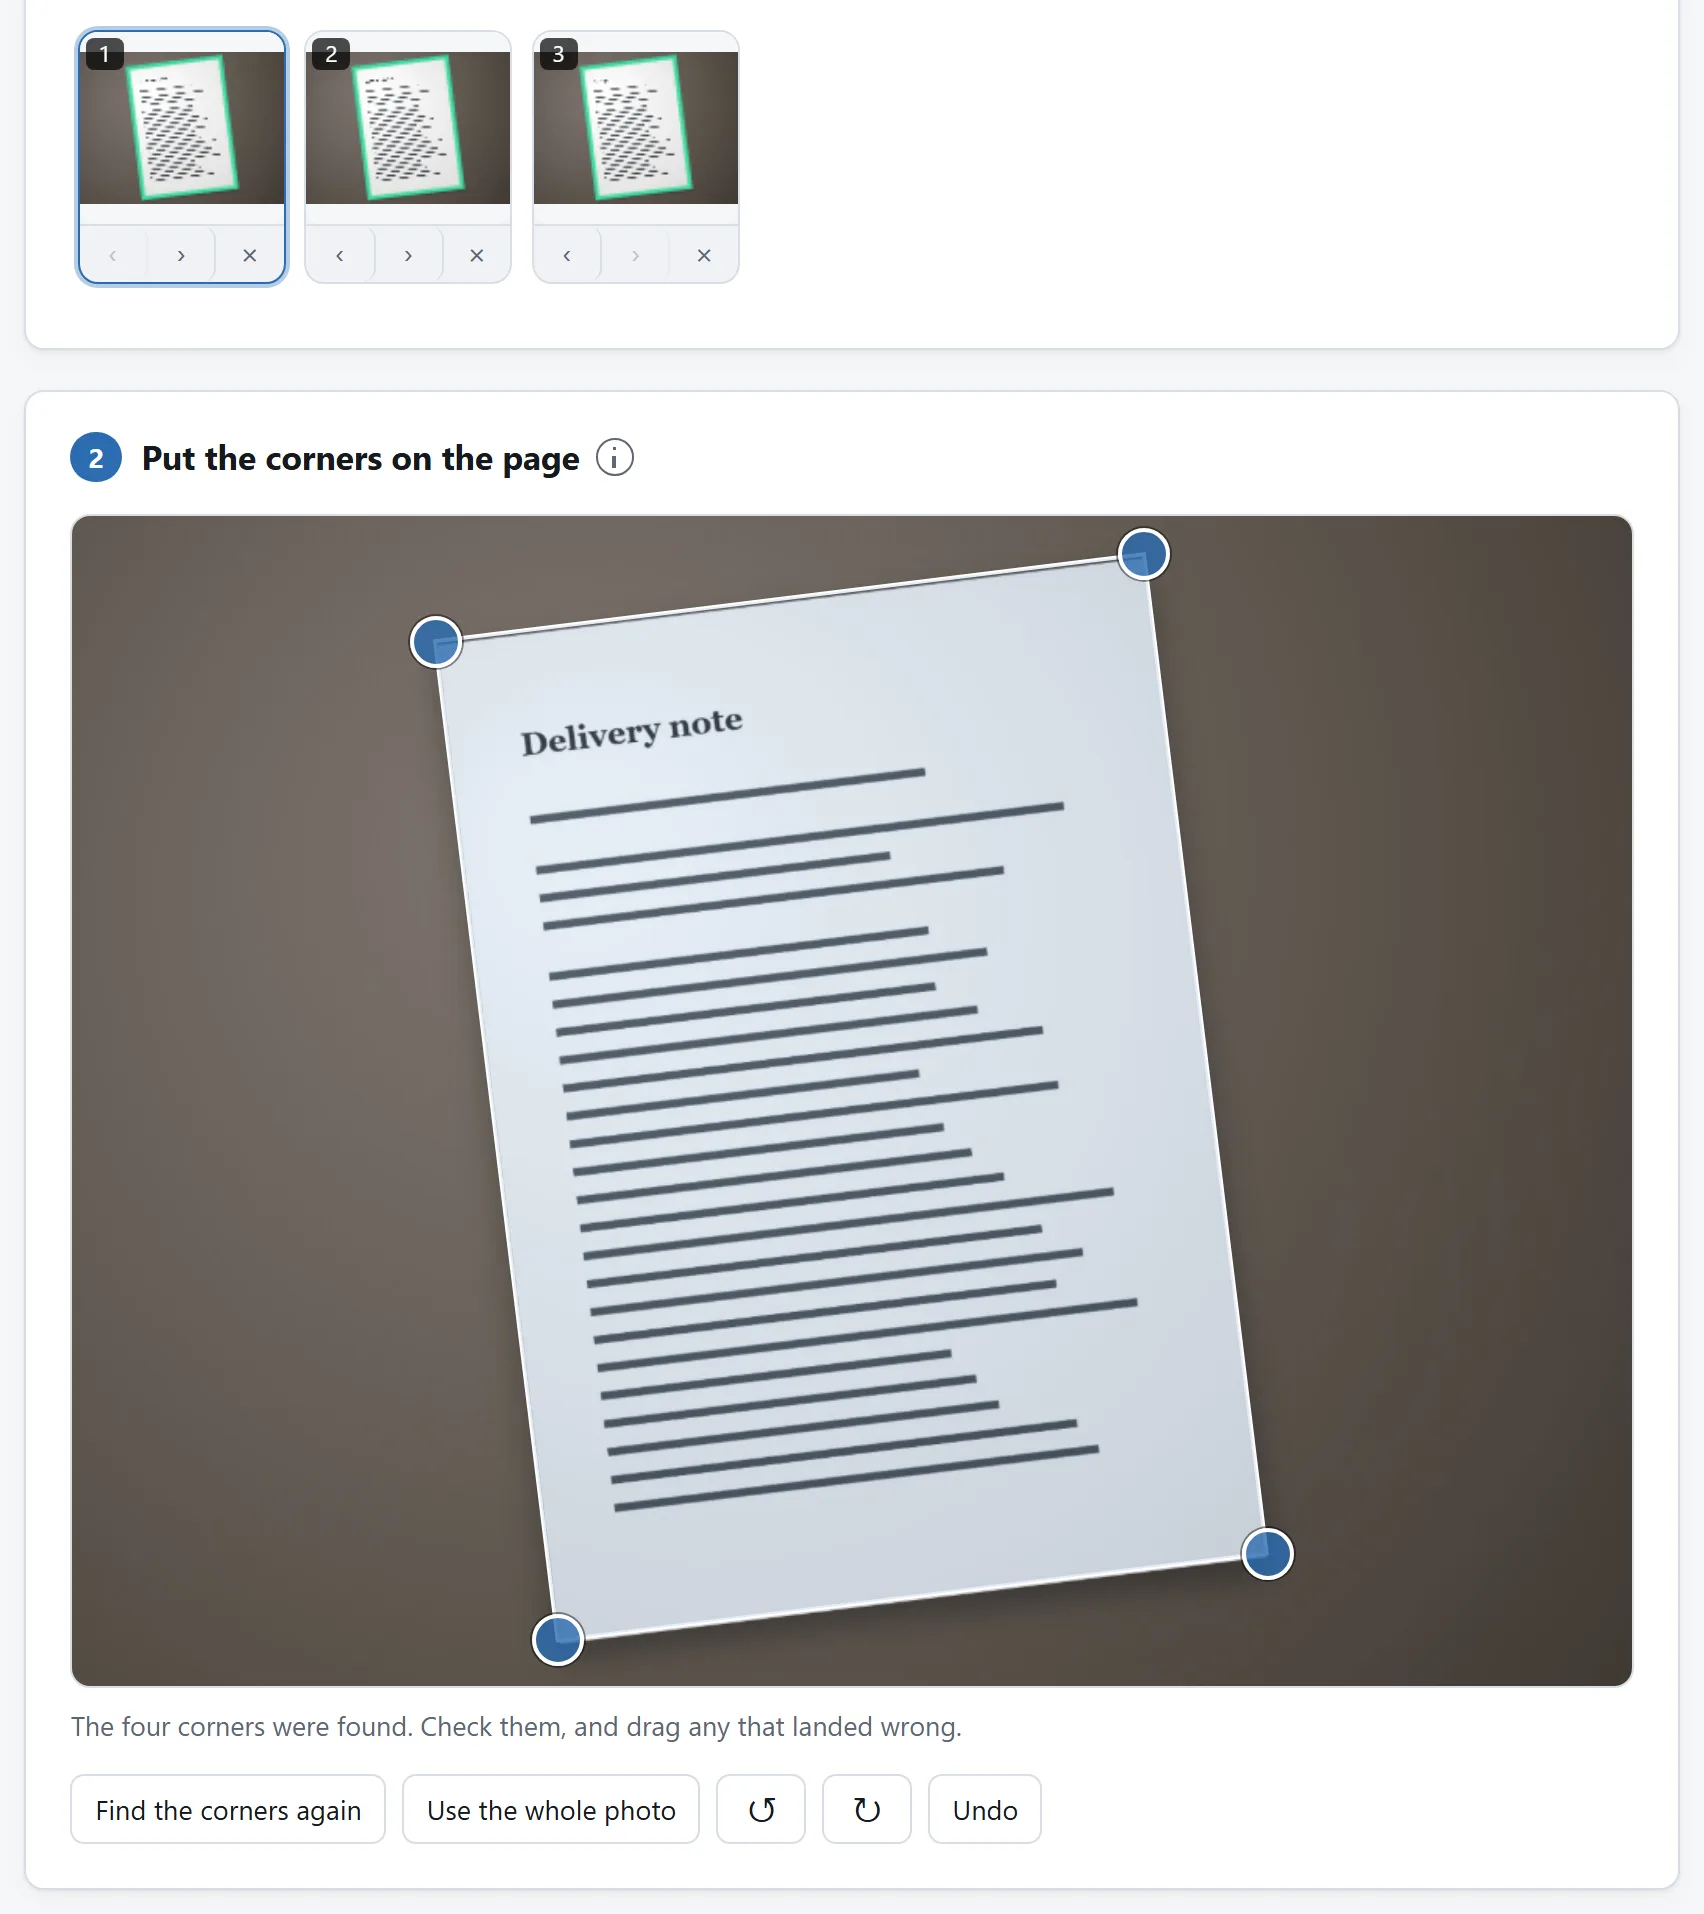
तीन पन्ने, साथ-साथ खींचे और सीधे किए हुए। हर एक अपने कोने रखता है, इसलिए एक खराब तस्वीर पूरे सेट को नहीं बिगाड़ती।
## मर्जर कब अपनी जगह कमाता है
स्कैनर *फ़ोटो* जोड़ता है। मर्जर *PDF* जोड़ता है — और असली काम का बीच अक्सर दोनों होता है: अभी-अभी खींचा गया हस्ताक्षर वाला पन्ना, फ़ाइल बनकर आए दस्तावेज़ के भीतर। पहले अपने पन्ने स्कैन कीजिए, फिर स्कैन और मूल PDF दोनों एक साथ मर्जर में डालिए, पन्ने खींचकर उनकी जगह बिठाइए, और एक दस्तावेज़ निर्यात कीजिए। मूल के बुकमार्क और भीतरी लिंक बचे हुए पन्नों के हिसाब से दोबारा बन जाते हैं, और भरे हुए फ़ॉर्म-फ़ील्ड साथ आते हैं।
अलग-अलग दिनों के स्कैन पर भी यही लागू है: हर बैठक का PDF पन्नों के एक खंड की तरह गिरता है, और मर्जर ही वह जगह है जहाँ खंड एक फ़ाइल बनते हैं।
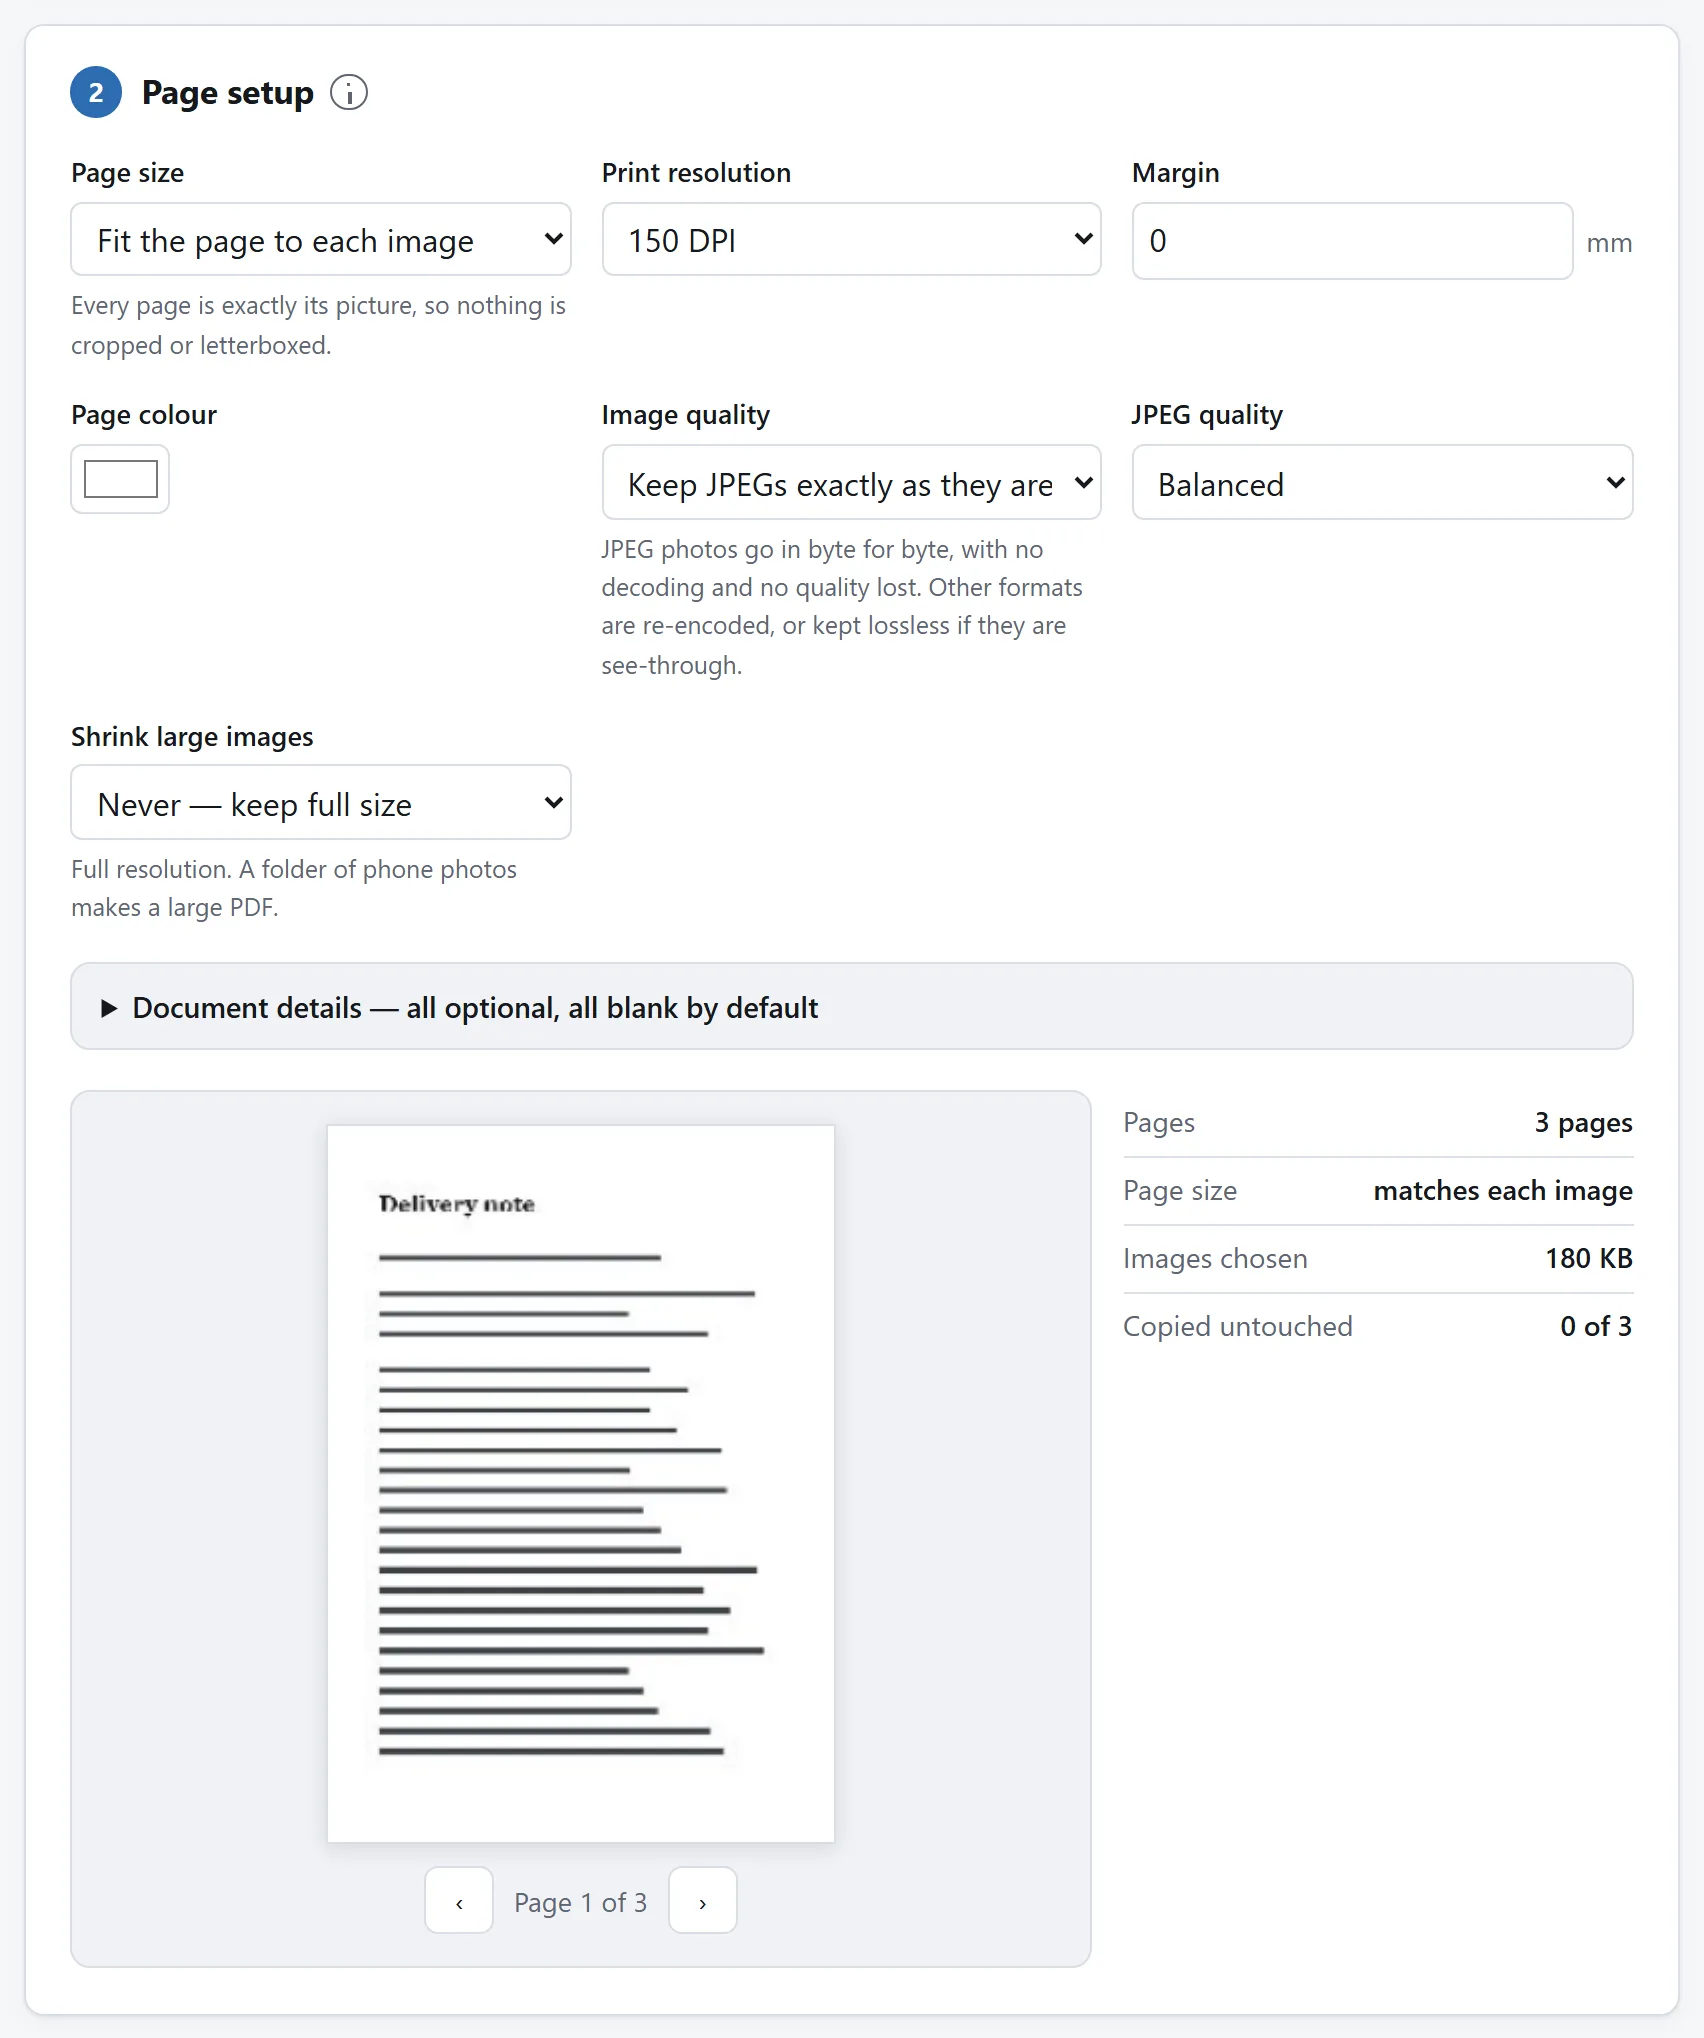
और फिर वही तीन पन्ने एक ही दस्तावेज़ के रूप में, वही कदम जिसमें जोड़ने वाला टूल अपनी जगह कमाता है।
## साइज़-सीमा के नीचे आना
पहले सस्ता लीवर आज़माइए, और वह स्कैनर के भीतर है: जो पन्ने कागज़ पर स्याही हैं — टेक्स्ट, फ़ॉर्म, रसीदें — उनके लिए ब्लैक-ऐंड-व्हाइट मोड हर पन्ना एक बिट प्रति पिक्सेल पर सहेजता है, और PDF बिना कुछ दबाए अक्सर एक मेगाबाइट प्रति पन्ना से काफ़ी नीचे उतर आता है। रंग अपनी कीमत वहीं वसूलता है जहाँ रंग का कोई मतलब हो।
फ़ाइल फिर भी न जाए — रंगीन पन्ने, या ऐसा मर्ज जिसमें किसी और का स्कैन आ गया — तो कंप्रेसर पहले दिखाता है कि आकार असल में कहाँ बैठा है, फिर पन्नों की छवियों को उसी रिज़ॉल्यूशन पर दोबारा एनकोड करता है जिस पर वे दिखती हैं। वह पेश करने से पहले यह भी जाँचता है कि नतीजा खुलता है — फ़ाइल जब समय-सीमा वाला अनुबंध हो, तो यह बात काम आती है।
## अगर आप यह हर हफ़्ते करते हैं
कदमों का यहाँ तीन पन्नों पर रहना जान-बूझकर है — हर पन्ना एक काम करता है, और हर एक अपने दम पर साबित करता है कि कागज़ात कभी आपकी मशीन से बाहर नहीं गए। मगर यह सब ओपन सोर्स है: MIT लाइसेंस, हर टूल का एक फ़ोल्डर, बिना निर्भरता के ES मॉड्यूल, जिनके README कोना-खोजक, मर्जर की पन्ना-नकल और कंप्रेसर का बजट समझाते हैं।
वही काम हर हफ़्ते आपकी मेज़ पर आता हो, तो किसी कोडिंग एजेंट को [रिपॉज़िटरी](https://github.com/A-Box-of-Tools/website) पर लगाइए और कहिए कि वे मॉड्यूल उसी काम के नाप का एक पन्ना बना दें — स्कैन सीधे एक जुड़े, दबे दस्तावेज़ में, आपका कवर पेज पहले से अपनी जगह। ये मॉड्यूल पढ़े जाने के लिए लिखे गए हैं, और इन्हें उठा ले जाना ही तो वह चीज़ है जिसके लिए लाइसेंस बना है।
छोटा जवाब
हर पन्ने की फ़ोटो लीजिए, फिर सारी फ़ोटो एक साथ दस्तावेज़ स्कैनर पर डाल दीजिए। वह हर पन्ने के कोने ढूँढ़ता है, हर फ़ोटो सीधी करता है, और हर फ़ोटो का एक पन्ना वाला एक PDF लिख देता है — जोड़ने का कोई अलग कदम है ही नहीं, और पन्ने उसी क्रम में बैठते हैं जिसमें आपने जोड़े।
जहाँ स्कैनर रुकता है, वहाँ से दो टूल सँभालते हैं। दस्तावेज़ का कोई हिस्सा पहले से PDF हो — ईमेल से आया अनुबंध, बीच में आपका अभी स्कैन किया हस्ताक्षर वाला पन्ना — तो दोनों को PDF मर्जर से गूँथ दीजिए। और बनी फ़ाइल अब भी इनबॉक्स की इजाज़त से बड़ी हो, तो PDF कंप्रेसर उसे सीमा के नीचे ले आता है।
दोनों जोड़ एक क्लिक की दूरी पर हैं: स्कैनर के PDF लिखते ही डाउनलोड बटन के नीचे एक पंक्ति नतीजा सीधे मिलाने वाले या संपीड़क तक ले जाने की पेशकश करती है, पहले से लदा हुआ — और मिलाने वाला अपना नतीजा उसी तरह संपीड़क को सौंप देता है।
कड़ी में कुछ भी कुछ अपलोड नहीं करता। यह बात यहाँ लगभग हर जगह से ज़्यादा मायने रखती है: स्कैन होते हैं अनुबंध, पहचान-पत्र और मेडिकल कागज़ात, और इस काम के आम ऐप हर पन्ना अपने सर्वरों से गुज़ारते हैं।
फ़ोटो सही लेना
स्कैनर हैरतअंगेज़ हद तक बचा लेता है — तिरछे शॉट, ऊँची-नीची लैंप की रोशनी, पन्ने पर आड़ी परछाईं — मगर जो कैमरे ने पकड़ा ही नहीं, उसे वह नहीं बचा सकता। तीन आदतें ज़्यादातर सँभाल लेती हैं:
फ़्रेम भरिए, हर किनारे के गिर्द मेज़ की थोड़ी झलक छोड़कर। कोने पन्ने को पृष्ठभूमि के मुकाबले खोजकर मिलते हैं; जो पन्ना फ़ोटो से बाहर बह जाए, उसका कोई कोना खोजने को बचता ही नहीं।
ऊपर से खींचिए, लगभग सीध में। परिप्रेक्ष्य सुधर जाता है, मगर तिरछे शॉट के दूर वाले किनारे में पिक्सेल कम होते हैं, और सुधार पिक्सेल गढ़ नहीं सकता।
एक फ़ोटो में एक पन्ना, पढ़ने के क्रम में। बाद में क्रम बदलना भी चलता है, पर जिस क्रम में आप खींचते हैं वही क्रम आपको मिलता है, और क्रम से खींचना मुफ़्त है।
बाकी स्कैन गाइड में है — कोने कैसे मिलते हैं, कब उन्हें खुद खींचना चाहिए, और ब्लैक-ऐंड-व्हाइट मोड फ़ाइल-आकार के साथ क्या करता है।
तीन पन्ने, साथ-साथ खींचे और सीधे किए हुए। हर एक अपने कोने रखता है, इसलिए एक खराब तस्वीर पूरे सेट को नहीं बिगाड़ती।
मर्जर कब अपनी जगह कमाता है
स्कैनर फ़ोटो जोड़ता है। मर्जर PDF जोड़ता है — और असली काम का बीच अक्सर दोनों होता है: अभी-अभी खींचा गया हस्ताक्षर वाला पन्ना, फ़ाइल बनकर आए दस्तावेज़ के भीतर। पहले अपने पन्ने स्कैन कीजिए, फिर स्कैन और मूल PDF दोनों एक साथ मर्जर में डालिए, पन्ने खींचकर उनकी जगह बिठाइए, और एक दस्तावेज़ निर्यात कीजिए। मूल के बुकमार्क और भीतरी लिंक बचे हुए पन्नों के हिसाब से दोबारा बन जाते हैं, और भरे हुए फ़ॉर्म-फ़ील्ड साथ आते हैं।
अलग-अलग दिनों के स्कैन पर भी यही लागू है: हर बैठक का PDF पन्नों के एक खंड की तरह गिरता है, और मर्जर ही वह जगह है जहाँ खंड एक फ़ाइल बनते हैं।
और फिर वही तीन पन्ने एक ही दस्तावेज़ के रूप में, वही कदम जिसमें जोड़ने वाला टूल अपनी जगह कमाता है।
साइज़-सीमा के नीचे आना
पहले सस्ता लीवर आज़माइए, और वह स्कैनर के भीतर है: जो पन्ने कागज़ पर स्याही हैं — टेक्स्ट, फ़ॉर्म, रसीदें — उनके लिए ब्लैक-ऐंड-व्हाइट मोड हर पन्ना एक बिट प्रति पिक्सेल पर सहेजता है, और PDF बिना कुछ दबाए अक्सर एक मेगाबाइट प्रति पन्ना से काफ़ी नीचे उतर आता है। रंग अपनी कीमत वहीं वसूलता है जहाँ रंग का कोई मतलब हो।
फ़ाइल फिर भी न जाए — रंगीन पन्ने, या ऐसा मर्ज जिसमें किसी और का स्कैन आ गया — तो कंप्रेसर पहले दिखाता है कि आकार असल में कहाँ बैठा है, फिर पन्नों की छवियों को उसी रिज़ॉल्यूशन पर दोबारा एनकोड करता है जिस पर वे दिखती हैं। वह पेश करने से पहले यह भी जाँचता है कि नतीजा खुलता है — फ़ाइल जब समय-सीमा वाला अनुबंध हो, तो यह बात काम आती है।
अगर आप यह हर हफ़्ते करते हैं
कदमों का यहाँ तीन पन्नों पर रहना जान-बूझकर है — हर पन्ना एक काम करता है, और हर एक अपने दम पर साबित करता है कि कागज़ात कभी आपकी मशीन से बाहर नहीं गए। मगर यह सब ओपन सोर्स है: MIT लाइसेंस, हर टूल का एक फ़ोल्डर, बिना निर्भरता के ES मॉड्यूल, जिनके README कोना-खोजक, मर्जर की पन्ना-नकल और कंप्रेसर का बजट समझाते हैं।
वही काम हर हफ़्ते आपकी मेज़ पर आता हो, तो किसी कोडिंग एजेंट को रिपॉज़िटरी पर लगाइए और कहिए कि वे मॉड्यूल उसी काम के नाप का एक पन्ना बना दें — स्कैन सीधे एक जुड़े, दबे दस्तावेज़ में, आपका कवर पेज पहले से अपनी जगह। ये मॉड्यूल पढ़े जाने के लिए लिखे गए हैं, और इन्हें उठा ले जाना ही तो वह चीज़ है जिसके लिए लाइसेंस बना है।

