छोटा जवाब
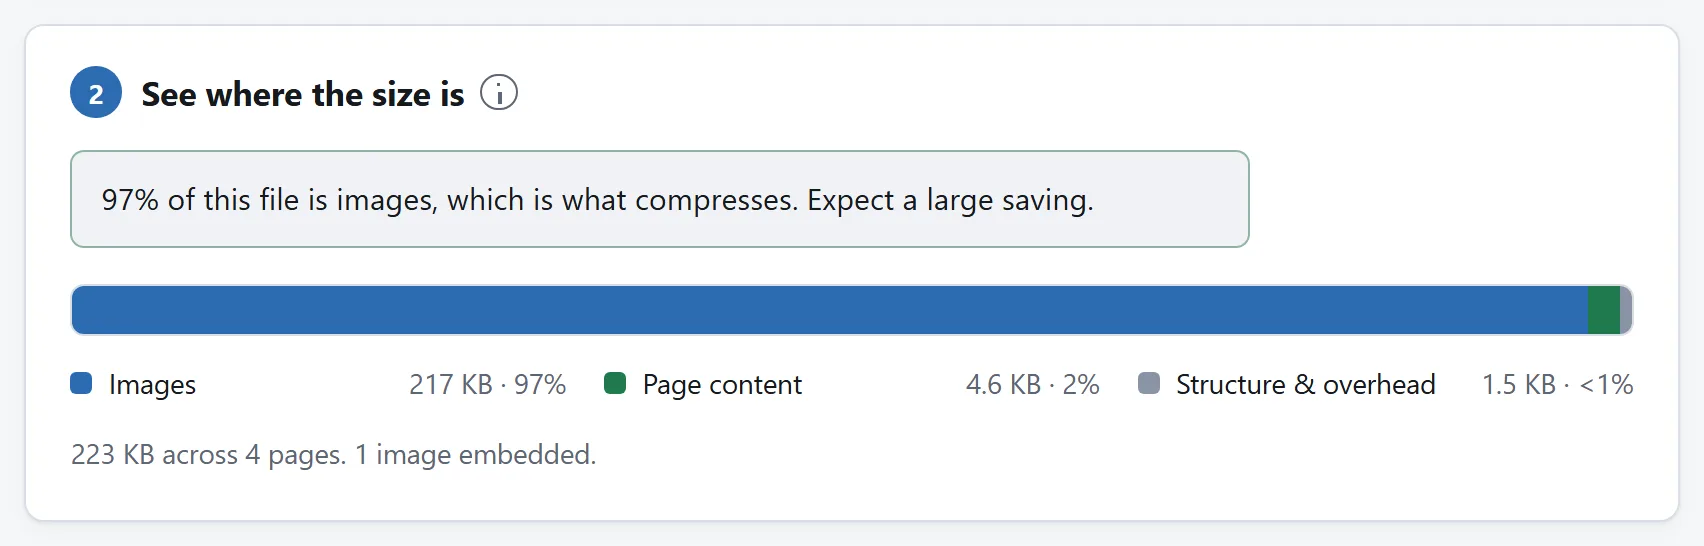
PDF कंप्रेसर खोलिए, दस्तावेज़ भीतर छोड़ दीजिए, और कुछ भी बदलने से पहले देखिए कि वह आपको बताता क्या है। वह फ़ाइल पढ़ता है और दिखा देता है कि साइज़ असल में बैठा कहाँ है, यानी तस्वीरें, फ़ॉन्ट, टेक्स्ट और ड्रॉइंग, और वह सब जिसका दस्तावेज़ में अब कोई हवाला नहीं बचा। आम तौर पर वही एक स्क्रीन सवाल का जवाब दे देती है।
अगर ज़्यादातर साइज़ तस्वीरों का है, तो आप बड़ी बचत की उम्मीद कर सकते हैं। अगर वह फ़ॉन्ट और टेक्स्ट का है, तो नहीं कर सकते, और कोई टूल नहीं कर सकता। इनमें से आपके पास कौन-सा है, पूरी कहानी बस यही है, और उसे देखने में दस सेकंड लगाना सार्थक है।
PDF का साइज़ असल में बैठा कहाँ होता है
PDF कई अलग-अलग तरह की चीज़ों का कंटेनर है, और वे सब एक जैसी नहीं दबतीं।
- तस्वीरें। फ़ोटोग्राफ़ और स्कैन। बड़ी PDF का लगभग हमेशा सबसे भारी हिस्सा, और अकेला ऐसा हिस्सा जिसमें असल में जगह होती है।
- भीतर रखे फ़ॉन्ट। पूरा फ़ॉन्ट कई सौ किलोबाइट का हो सकता है; सिर्फ़ इस्तेमाल हुए अक्षरों का उपसमुच्चय उससे कहीं कम। दोनों ही हालात में, जिसने फ़ाइल बनाई उसने उन्हें पहले ही कंप्रेस कर दिया था।
- टेक्स्ट और वेक्टर ड्रॉइंग। पिक्सल नहीं, निर्देश: यह लकीर खींचिए, यह शब्द यहाँ रखिए। पहले से ही सुडौल, और पहले से ही कंप्रेस हो चुका।
- वे ऑब्जेक्ट जिनकी तरफ़ अब कुछ भी इशारा नहीं करता। PDF में ये जमा होते रहते हैं। दस्तावेज़ बदलने पर फ़ाइल दोबारा लिखने के बजाय अक्सर बदलाव आगे जोड़ दिया जाता है, इसलिए किसी पन्ने का पुराना रूप उसमें अनिश्चित काल तक पड़ा रह सकता है। फ़ाइल दोबारा पैक करने पर वे गिर जाते हैं।
इसलिए PDF कंप्रेसर पर लोग जो दो तरह के दस्तावेज़ लाते हैं, उनकी संभावनाएँ बिलकुल अलग हैं। स्कैन किया दस्तावेज़ मूलतः फ़ोटोग्राफ़ों का ढेर है, और आम तौर पर 60–90% छोटा निकलता है। कोई अनुबंध, शोध-प्रबंध या एक्सपोर्ट की गई रिपोर्ट टेक्स्ट, ड्रॉइंग और फ़ॉन्ट होती है, और ये सब उसी सॉफ़्टवेयर के हाथों पहले ही कंप्रेस हो चुके होते हैं जिसने उसे लिखा। वहाँ बचत आम तौर पर कुछ प्रतिशत ही होती है, दोबारा पैक करने और बिना हवाले वाली चीज़ें गिरा देने से।
जो टूल आपकी फ़ाइल देखे बिना “90% तक छोटा” का वादा करे, वह पहली तरह का सबसे अच्छा मामला दूसरी तरह को सुना रहा है।
इसमें DPI का क्या काम है
PDF सिर्फ़ तस्वीर नहीं रखती; वह यह भी दर्ज रखती है कि वह तस्वीर पन्ने पर कितनी बड़ी बनाई गई है। इससे आपको पिक्सलों की गिनती से ज़्यादा काम की चीज़ मिलती है: असरदार रिज़ॉल्यूशन।
4000 पिक्सल चौड़ा स्कैन अगर कागज़ पर आठ इंच में फैला है, तो वह प्रति इंच 500 पिक्सल ढो रहा है। स्क्रीन करीब 100 दिखाती है। अच्छा दफ़्तरी प्रिंटर 300 पर काम करता है और उससे बहुत ज़्यादा इस्तेमाल कर ही नहीं सकता। उससे ऊपर सब कुछ ऐसा ब्योरा है जिसे दस्तावेज़ के भविष्य में कुछ भी कभी नहीं दिखाएगा, और आम तौर पर वही फ़ाइल का ज़्यादातर हिस्सा होता है।
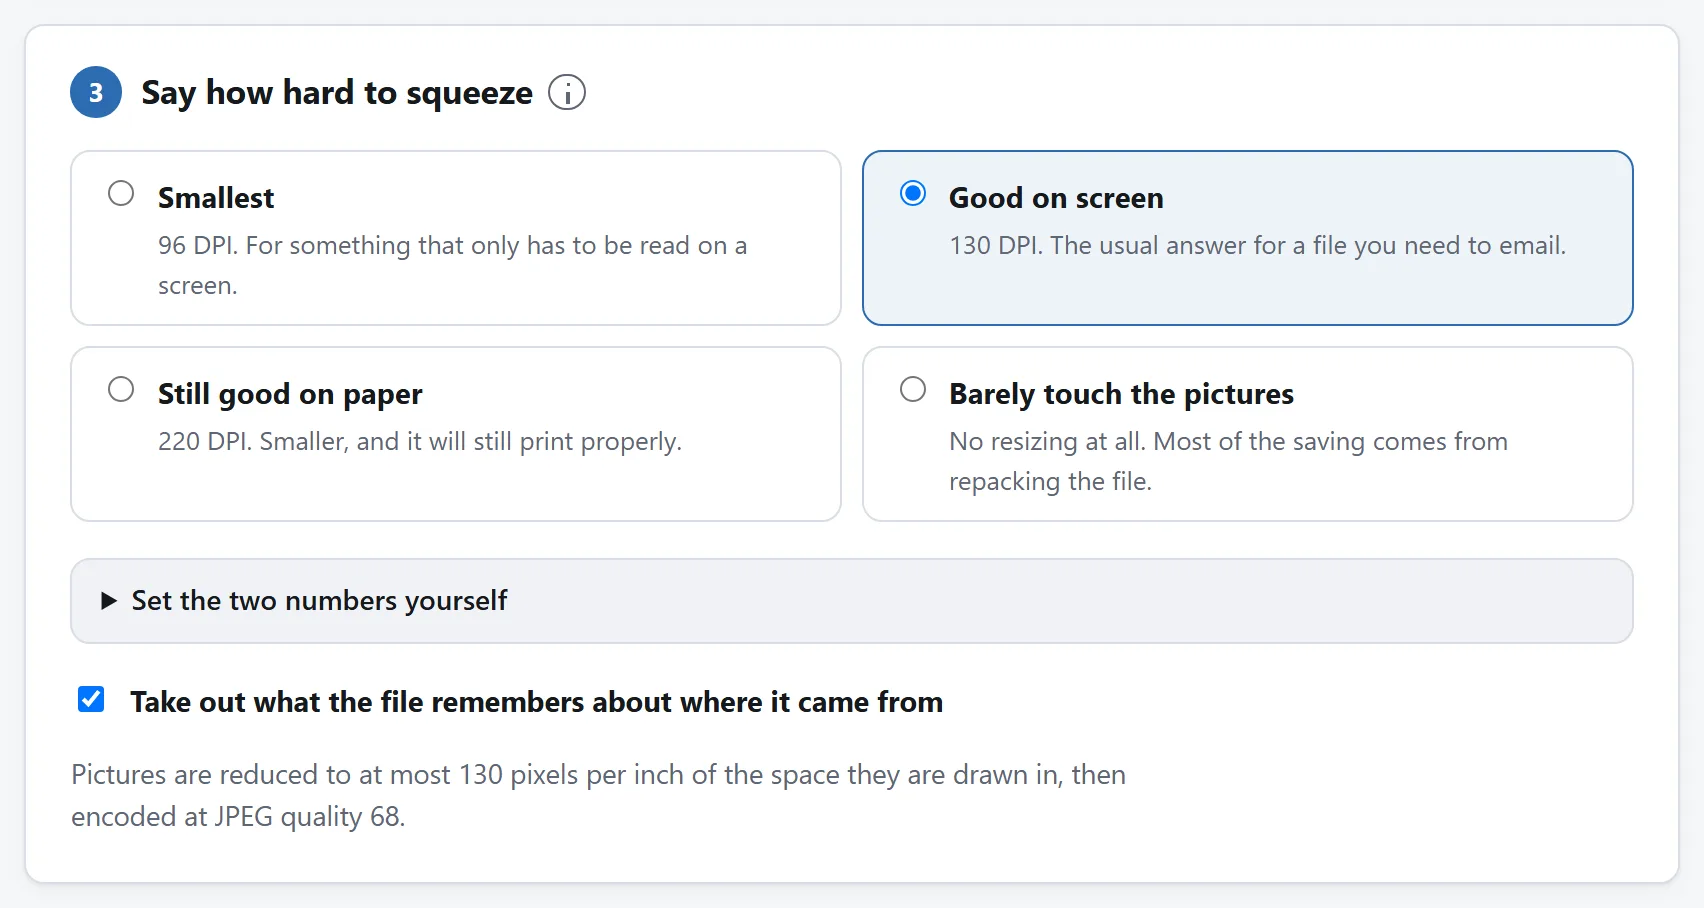
इसीलिए समझदार PDF कंप्रेसर क्वालिटी का प्रतिशत नहीं, DPI पूछता है। वह पहले आपके आँकड़े से ऊपर के पिक्सल फेंकता है, क्योंकि उनकी कीमत ऐसी किसी चीज़ में नहीं लगती जो किसी को दिखे, और उसके बाद ही असली क्वालिटी खर्च करना शुरू करता है।
मोटा नियम: स्क्रीन पर पढ़े जाने वाले दस्तावेज़ के लिए 150 DPI, छपने वाली चीज़ के लिए 200–300, और ऐसे मसौदे के लिए जिसे कोई रखेगा ही नहीं, 72–100। तस्वीर पन्ने पर कितनी बड़ी बनी है, इसके हिसाब से नापने की वजह से ही छोटा रखा लोगो पूरे पन्ने के स्कैन जैसा नहीं समझा जाता। लोगो पहले से ही अपने असरदार रिज़ॉल्यूशन के आसपास होता है और उसमें से लेने को कुछ है ही नहीं।
कंप्रेस करने में क्या छूना चाहिए और क्या नहीं
तस्वीरें दोबारा एनकोड होती हैं, इसलिए उनका थोड़ा नुकसान होता है। बाकी कुछ भी छूना ही नहीं चाहिए, और यह जाँच लेना अच्छा है कि आप जो भी टूल इस्तेमाल कर रहे हैं वह इस पर टिका रहता है या नहीं:
- टेक्स्ट टेक्स्ट ही रहे। चुनने लायक, खोजने लायक, कॉपी करने लायक। जो कंप्रेसर पन्नों को तस्वीरों में चपटा कर देता है वह बहुत छोटी फ़ाइल बनाएगा और दस्तावेज़ को तबाह कर देगा। आप उसमें खोज नहीं सकते, स्क्रीन रीडर उसे पढ़ नहीं सकते, और उसे कभी वापस भी नहीं किया जा सकता।
- फ़ॉन्ट पूरे के पूरे रहें। फ़ॉन्ट बदल देने से किसी और की मशीन पर दस्तावेज़ का दिखना बदल जाता है, और PDF का होना ही ठीक इसी चीज़ को रोकने के लिए है।
- वेक्टर ड्रॉइंग हूबहू उतारी जाए। वह पहले से ही छोटी है, और उसे पिक्सलों में बदलने से वह बड़ी भी हो जाती और खराब भी।
- फ़ॉर्म, लिंक, बुकमार्क, सुलभता का ढाँचा और अटैचमेंट साथ जाएँ। दोबारा लिखते वक्त ये आसानी से खो जाते हैं और तब तक किसी की नज़र में नहीं आते जब तक किसी को इनमें से कोई चाहिए न हो।
एक जुड़ा हुआ नियम, जिस पर कंप्रेसर को टिकना चाहिए और बहुत सारे नहीं टिकते: अगर किसी तस्वीर को दोबारा एनकोड करने पर वह असली से छोटी न निकले, तो असली बाइट ही वापस रख दीजिए। बिना किसी बचत के तस्वीर को बदतर बना देना शुद्ध नुकसान वाला मामला है, और पहले से अच्छी तरह दबी हुई तस्वीरों पर यह आपकी सोच से ज़्यादा बार होता है।
वे तस्वीरें जो कंप्रेस नहीं की जा सकतीं
PDF के भीतर की कुछ तस्वीरें छोड़ दी जाती हैं, और अच्छा टूल उन्हें चुपचाप हिसाब से बाहर रखने के बजाय उनके नाम गिना देता है:
- JPEG 2000, JBIG2 और फ़ैक्स-कोडेड (CCITT) तस्वीरें। इनमें से किसी का भी डिकोडर किसी ब्राउज़र में नहीं आता, इसलिए वे बिना छुए आगे भेज दी जाती हैं। बाद की दोनों दो-स्तरीय हैं, यानी सिर्फ़ काला और सफ़ेद, और आम तौर पर पहले से ही अपने सबसे छोटे रूप के आसपास होती हैं।
- CMYK तस्वीरें। जान-बूझकर छोड़ी जाती हैं। उन्हें दोबारा एनकोड करने में वे रंग खिसकने का खतरा है जो प्रिंटर छापेगा, और जिस दस्तावेज़ को कोई छापने वाला है उसके साथ यह चौंकाने वाली बात होती।
कंप्रेस करने से पहले आज़माने लायक चीज़ें
कभी-कभी फ़ाइल किसी ऐसी वजह से बड़ी होती है जिसका जवाब कंप्रेशन है ही नहीं।
क्या इसे बेवजह स्कैन कर दिया गया? जो दस्तावेज़ छापकर फिर स्कैन किया गया हो, वह टेक्स्ट की फ़ोटोग्राफ़ों का ढेर है। अगर असली दस्तावेज़ अब भी कहीं दस्तावेज़ के रूप में मौजूद है, तो उसे PDF में एक्सपोर्ट करने पर ऐसी फ़ाइल बनेगी जो साइज़ के एक अंश जितनी होगी और खोजी भी जा सकेगी।
क्या इसे प्रिंट सेटिंग पर एक्सपोर्ट किया गया था? वर्ड प्रोसेसर और डिज़ाइन सॉफ़्टवेयर अक्सर डिफ़ॉल्ट रूप से प्रिंट-क्वालिटी पर एक्सपोर्ट करते हैं। स्रोत फ़ाइल से स्क्रीन के लिए दोबारा एक्सपोर्ट करना आम तौर पर उस एक्सपोर्ट को कंप्रेस करने से बेहतर पड़ता है।
क्या इसका एक ही फ़ाइल होना ज़रूरी है? ईमेल की सीमा हर संदेश पर लगती है। 200 पन्नों के दस्तावेज़ को अध्यायों में बाँट देना कभी-कभी ईमानदार इलाज होता है।
एन्क्रिप्टेड फ़ाइलें, और कंप्रेसर को उन्हें मना क्यों करना चाहिए
पासवर्ड से सुरक्षित PDF को यहाँ का टूल मना कर देता है, और यह किसी सुविधा की कमी नहीं, जान-बूझकर है। ऐसा तब भी होता है जब पासवर्ड खाली हो, और बहुत सारे स्कैनर तथा कॉपियर ऐसे ही सहेजते हैं।
किसी दस्तावेज़ से सुरक्षा उतारना, उसे कंप्रेस करने से अलग काम है। जो टूल यह चुपचाप कर दे, वह ऐसी फ़ाइल के साथ वह कर रहा होगा जो आपने माँगा ही नहीं था, और वह भी ऐसी फ़ाइल के साथ जिसे किसी ने जान-बूझकर बंद किया था। वह आपको ऐसी नकल लौटा रहा होगा जिसमें वह गुण बचा ही नहीं जो वे उसमें चाहते थे। अगर आपको यही चाहिए, तो सुरक्षा पहले खुद, जान-बूझकर हटा लीजिए।
नतीजा जाँचना
उसे खोलिए। तस्वीरों को पूरे ज़ूम पर देखिए, जाँचिए कि टेक्स्ट अब भी चुना जा सकता है, और पन्नों की गिनती की पुष्टि कीजिए।
यहाँ का टूल आखिरी वाला काम फ़ाइल देने से पहले खुद कर देता है: वह अभी-अभी लिखा दस्तावेज़ दोबारा खोलता है और उसके पन्ने गिनता है, आपकी अपनी मशीन पर। वह PDF 1.5 भी लिखता है, जिसे 2003 के बाद आया हर रीडर समझता है, इसलिए “यह मेरी मशीन पर खुलती है” इस बात का ठीक-ठाक संकेत है कि “यह उनकी मशीन पर भी खुलेगी”।
इसमें सर्वर की ज़रूरत क्यों नहीं
PDF कंप्रेस करना सर्वर का काम लगता है, और वेब के ज़्यादातर जीवन में था भी। असल में इसमें शामिल है फ़ाइल का ढाँचा समझना, तस्वीरों की धाराएँ ढूँढ़ना, उन्हें उन्हीं कोडेक से डिकोड और दोबारा एनकोड करना जो ब्राउज़र पहले से साथ लाता है, और दस्तावेज़ वापस लिख देना। यह सब अब ब्राउज़र में चलता है।
और यह बात ज़्यादातर दूसरी तरह की फ़ाइलों से इस तरह की फ़ाइलों के लिए कहीं ज़्यादा मायने रखती है, क्योंकि लोग कंप्रेस करते क्या हैं। अनुबंध, डॉक्टरी चिट्ठियाँ, बैंक के विवरण, पहचान के दस्तावेज़, टैक्स रिटर्न। यहाँ के टूल में कोई नेटवर्क सुविधा है ही नहीं, और पेज की Content-Security-Policy उन सारे पतों के नाम गिना देती है जिनसे वह संपर्क कर सकता है; उनमें से एक भी इस साइट का नहीं है। इसे लोड कीजिए, प्लग निकाल दीजिए, और तब भी कुछ कंप्रेस करके देखिए।
क्या ऑनलाइन कन्वर्टर पर फ़ाइलें अपलोड करना सुरक्षित है? ऐसी ही तीन और जाँचें बताता है।