Vergelijk twee JSON-bestanden zoals ze komen en bijna alles wat oplicht is niets: inspringing, regelafbrekingen, sleutels in een andere volgorde. De remedie is geen slimmere diff — het is beide bestanden eerst door dezelfde formatter halen, zodat alleen de echte verschillen overblijven. Beide stappen draaien in je browser, en daar horen configuratiebestanden met geheimen erin thuis.
Open de tool TekstvergelijkerTwee teksten erin, elk verschil gemarkeerd, regel voor regel en woord voor woord. Er wordt niets in andermans server geplakt.
# Zo vergelijk je twee JSON-bestanden
Vergelijk twee JSON-bestanden zoals ze komen en bijna alles wat oplicht is niets: inspringing, regelafbrekingen, sleutels in een andere volgorde. De remedie is geen slimmere diff — het is beide bestanden eerst door dezelfde formatter halen, zodat alleen de echte verschillen overblijven. Beide stappen draaien in je browser, en daar horen configuratiebestanden met geheimen erin thuis.
[Open de tool Tekstvergelijker](https://abox.tools/nl/tekst-vergelijken/): Twee teksten erin, elk verschil gemarkeerd, regel voor regel en woord voor woord. Er wordt niets in andermans server geplakt.
Laatst bijgewerkt 26 augustus 2026
## Het korte antwoord
1. Open de [JSON-formatter](https://abox.tools/nl/json-formatteren/), plak het eerste bestand, zet de inspringing op twee spaties en vink *De sleutels van elk object sorteren* aan. Kopieer het resultaat.
2. Open de [Tekstvergelijker](https://abox.tools/nl/tekst-vergelijken/) en plak het in het linkervak.
3. Doe hetzelfde met het tweede bestand, in het rechtervak.
Wat nu oplicht is echt: een waarde die veranderde, een sleutel die verscheen, een regel die verdween. De opmaakverschillen en de herschikte sleutels waarin een gewone diff verdronken zou zijn, zijn weg, omdat beide kanten hetzelfde gespeld waren voordat de vergelijking begon.
Geen van beide pagina's heeft ook maar één netwerkfunctie — goed om te weten, want de JSON die mensen vergelijken is zo vaak een configuratiebestand met de inloggegevens er nog in.
## Waarom een rauwe JSON-diff vooral ruis is
JSON geeft niets om witruimte, en het geeft sleutelvolgorde geen betekenis. Hetzelfde document kan één regel zijn of vierhonderd, de sleutels in de volgorde waarin ze getypt zijn of in die welke een of andere bibliotheek uitspuwde — en tools herschrijven allebei vrijelijk. De ene kant geminificeerd, de andere uitgevouwen; de ene met de hand opgeslagen, de andere door een serializer die alfabetisch sorteert: een regeldiff ziet twee bestanden zonder verwantschap.
De twee ergste gevallen maken het punt. Een **geminificeerd** bestand is één regel, dus een diff ertegen is één gigantische veranderde regel — waar en nutteloos. En twee bestanden met **dezelfde inhoud in een andere volgorde** vergelijken als alles-veranderd, terwijl het eerlijke antwoord “niets” zou zijn.
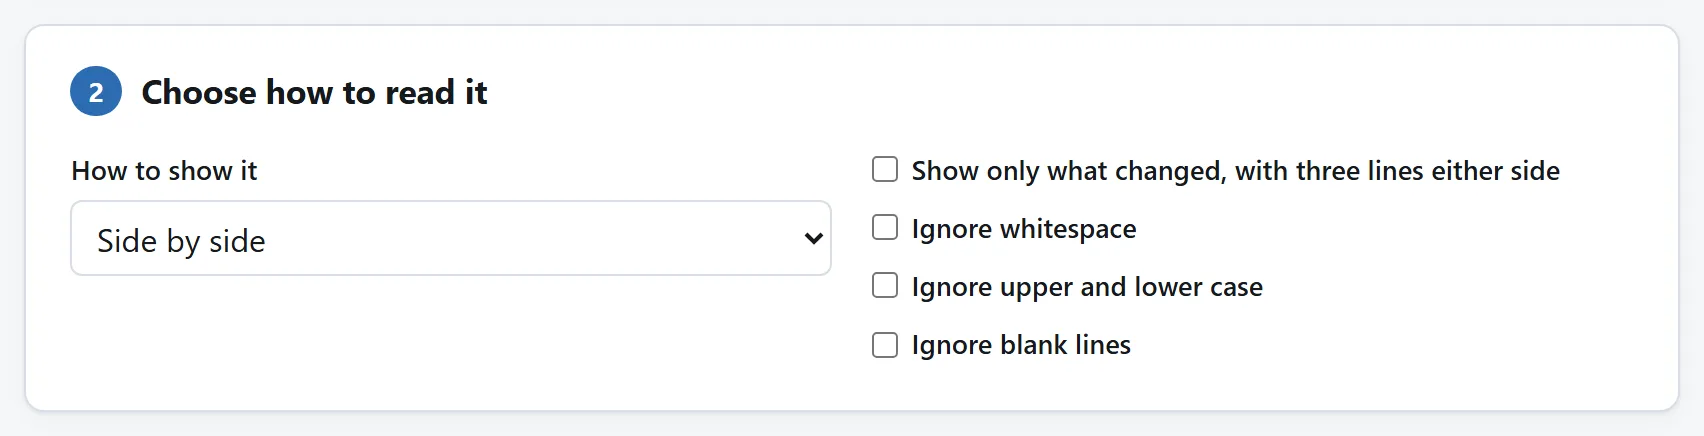
Deze voorkomen dat een vergelijking elke regel meldt omdat één bestand met andere regeleindes is opgeslagen.
## Wat de canonieke vorm van de formatter oplost
Beide bestanden door dezelfde formatter met dezelfde instellingen halen is precies wat een diff nodig heeft: één spelling per document.
- **Dezelfde inspringing** zet elke sleutel op zijn eigen regel, zodat de diff regel voor regel werkt en zijn woordmarkeringen kunnen wijzen naar de ene waarde die in een regel veranderde.
- **Gesorteerde sleutels** zetten beide kanten in dezelfde volgorde, zodat volgorde ophoudt een verschil te zijn. Er wordt gesorteerd op hoe sleutels lezen, niet op codepunten — `item2` vóór `item10` — en identiek op beide kanten toegepast.
- **Verder beweegt er niets.** Deze formatter houdt getallen als de cijfers die je schreef en houdt dubbele sleutels in plaats van ze te beslechten — canoniek maken kan dus zelf geen verschil verzinnen. De [formattergids](https://abox.tools/nl/gidsen/json-formatteren/) legt uit waarom dat zeldzamer is dan het zou moeten zijn.
Eén eerlijke kanttekening: de gesorteerde uitvoer is het document met zijn sleutels verplaatst. Geeft een tool verderop om sleutelvolgorde — weinige doen dat, maar ze bestaan — behandel de gesorteerde kopieën dan als het ding dat vergeleken wordt, niet als vervanging van de originelen.
## Het resultaat lezen, en meenemen
De vergelijker markeert verwijderde regels links, toegevoegde rechts, en licht binnen een veranderde regel de woorden op die verschillen — op een canonieke vorm is dat doorgaans de ene waarde die van `false` naar `true` ging. Het onveranderde midden vouwt samen tot een telling, zodat een configuratie van tweeduizend regels met drie wijzigingen leest als drie korte passages.
De download is een unified `.patch` — het formaat dat codereview begrijpt. Hij beschrijft de canonieke vormen, en dat is meestal wat een review toch al wil: de wijziging, zonder de heropmaak.
Hetzelfde recept werkt voor al het andere dat beide pagina's spreken. YAML en XML worden op dezelfde manier canoniek; en voor twee bestanden van dezelfde vorm uit verschillende bronnen zijn de negeerschakelaars van de vergelijker — witruimte, hoofdletters, lege regels — een lichtere versie van hetzelfde idee.
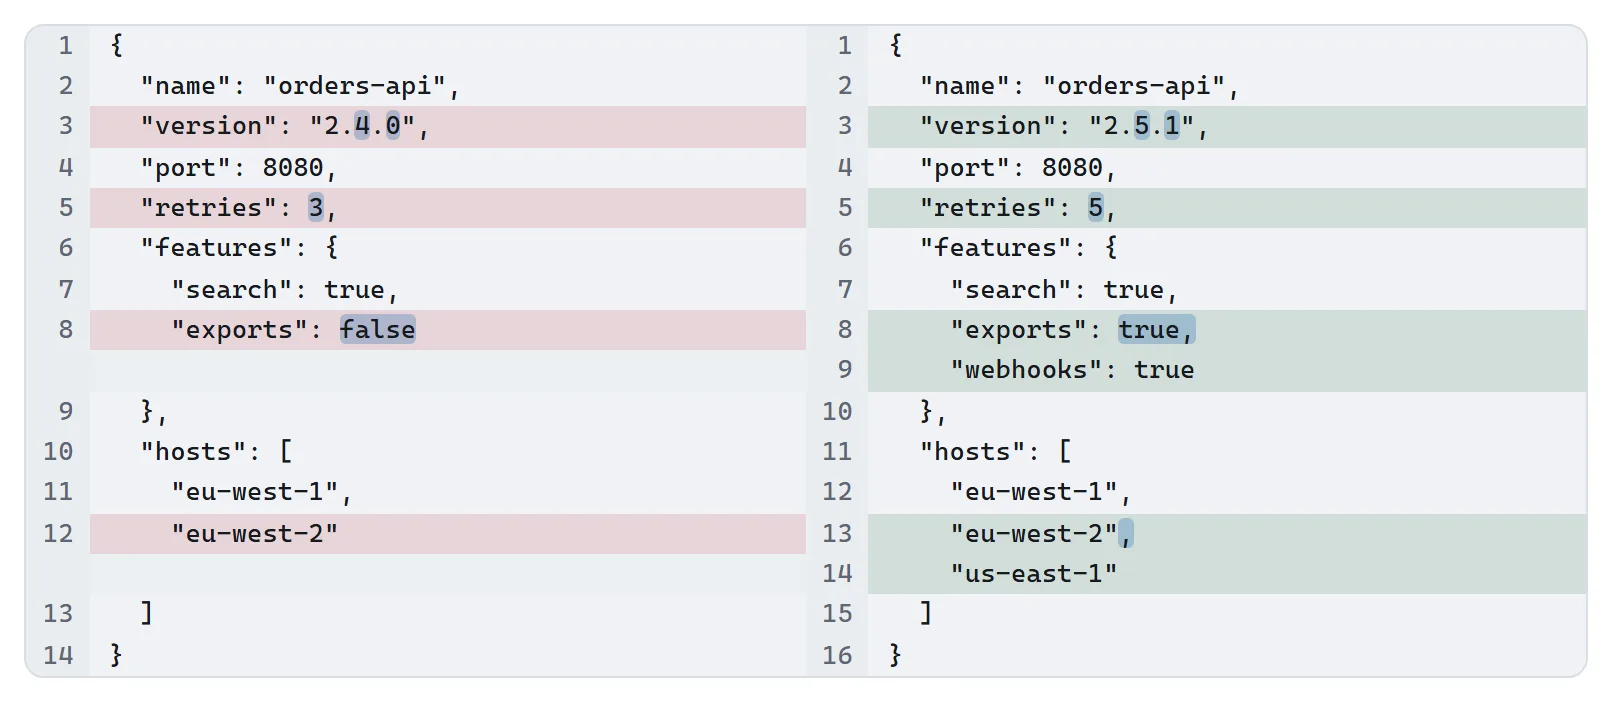
Vier echte verschillen, en verder niets gemeld. Lezen is de makkelijke helft; het werk is gedaan door de instellingen hierboven.
## Als je dit elke week doet
Twee keer formatteren, twee keer plakken — de stappen wonen op twee pagina's omdat elke pagina één klus doet, en elke op zichzelf kan bewijzen dat niets van wat je plakte ergens heen ging. Maar beide zijn open source: MIT-licentie, ES-modules zonder afhankelijkheden — de parser van de formatter houdt sleutelvolgorde en cijfers, de diff is Myers' algoritme — elk met een README die het uitlegt.
Hoort dit bij je dag, zet dan een codeeragent op de [repository](https://github.com/A-Box-of-Tools/website) en vraag om een pagina met twee vakken die canoniek maakt terwijl ze vergelijkt — `parseJson`, `printJson` en `compareText` zijn drie imports ver. De modules zijn geschreven om gelezen te worden, en ze meenemen is precies waar de licentie voor is.
Het korte antwoord
Open de JSON-formatter, plak het eerste bestand, zet de inspringing op twee spaties en vink De sleutels van elk object sorteren aan. Kopieer het resultaat.
Doe hetzelfde met het tweede bestand, in het rechtervak.
Wat nu oplicht is echt: een waarde die veranderde, een sleutel die verscheen, een regel die verdween. De opmaakverschillen en de herschikte sleutels waarin een gewone diff verdronken zou zijn, zijn weg, omdat beide kanten hetzelfde gespeld waren voordat de vergelijking begon.
Geen van beide pagina's heeft ook maar één netwerkfunctie — goed om te weten, want de JSON die mensen vergelijken is zo vaak een configuratiebestand met de inloggegevens er nog in.
Waarom een rauwe JSON-diff vooral ruis is
JSON geeft niets om witruimte, en het geeft sleutelvolgorde geen betekenis. Hetzelfde document kan één regel zijn of vierhonderd, de sleutels in de volgorde waarin ze getypt zijn of in die welke een of andere bibliotheek uitspuwde — en tools herschrijven allebei vrijelijk. De ene kant geminificeerd, de andere uitgevouwen; de ene met de hand opgeslagen, de andere door een serializer die alfabetisch sorteert: een regeldiff ziet twee bestanden zonder verwantschap.
De twee ergste gevallen maken het punt. Een geminificeerd bestand is één regel, dus een diff ertegen is één gigantische veranderde regel — waar en nutteloos. En twee bestanden met dezelfde inhoud in een andere volgorde vergelijken als alles-veranderd, terwijl het eerlijke antwoord “niets” zou zijn.
Deze voorkomen dat een vergelijking elke regel meldt omdat één bestand met andere regeleindes is opgeslagen.
Wat de canonieke vorm van de formatter oplost
Beide bestanden door dezelfde formatter met dezelfde instellingen halen is precies wat een diff nodig heeft: één spelling per document.
Dezelfde inspringing zet elke sleutel op zijn eigen regel, zodat de diff regel voor regel werkt en zijn woordmarkeringen kunnen wijzen naar de ene waarde die in een regel veranderde.
Gesorteerde sleutels zetten beide kanten in dezelfde volgorde, zodat volgorde ophoudt een verschil te zijn. Er wordt gesorteerd op hoe sleutels lezen, niet op codepunten — item2 vóór item10 — en identiek op beide kanten toegepast.
Verder beweegt er niets. Deze formatter houdt getallen als de cijfers die je schreef en houdt dubbele sleutels in plaats van ze te beslechten — canoniek maken kan dus zelf geen verschil verzinnen. De formattergids legt uit waarom dat zeldzamer is dan het zou moeten zijn.
Eén eerlijke kanttekening: de gesorteerde uitvoer is het document met zijn sleutels verplaatst. Geeft een tool verderop om sleutelvolgorde — weinige doen dat, maar ze bestaan — behandel de gesorteerde kopieën dan als het ding dat vergeleken wordt, niet als vervanging van de originelen.
Het resultaat lezen, en meenemen
De vergelijker markeert verwijderde regels links, toegevoegde rechts, en licht binnen een veranderde regel de woorden op die verschillen — op een canonieke vorm is dat doorgaans de ene waarde die van false naar true ging. Het onveranderde midden vouwt samen tot een telling, zodat een configuratie van tweeduizend regels met drie wijzigingen leest als drie korte passages.
De download is een unified .patch — het formaat dat codereview begrijpt. Hij beschrijft de canonieke vormen, en dat is meestal wat een review toch al wil: de wijziging, zonder de heropmaak.
Hetzelfde recept werkt voor al het andere dat beide pagina's spreken. YAML en XML worden op dezelfde manier canoniek; en voor twee bestanden van dezelfde vorm uit verschillende bronnen zijn de negeerschakelaars van de vergelijker — witruimte, hoofdletters, lege regels — een lichtere versie van hetzelfde idee.
Vier echte verschillen, en verder niets gemeld. Lezen is de makkelijke helft; het werk is gedaan door de instellingen hierboven.
Als je dit elke week doet
Twee keer formatteren, twee keer plakken — de stappen wonen op twee pagina's omdat elke pagina één klus doet, en elke op zichzelf kan bewijzen dat niets van wat je plakte ergens heen ging. Maar beide zijn open source: MIT-licentie, ES-modules zonder afhankelijkheden — de parser van de formatter houdt sleutelvolgorde en cijfers, de diff is Myers' algoritme — elk met een README die het uitlegt.
Hoort dit bij je dag, zet dan een codeeragent op de repository en vraag om een pagina met twee vakken die canoniek maakt terwijl ze vergelijkt — parseJson, printJson en compareText zijn drie imports ver. De modules zijn geschreven om gelezen te worden, en ze meenemen is precies waar de licentie voor is.

