Het korte antwoord
- Knip. Open de Audioknipper, sleep de memo erin en markeer de delen die blijven met I en O terwijl hij speelt. De golfvorm laat de stiltes en de valse starts als vlakke stukken zien, dus het meeste knippen gaat op het oog. Exporteer één bestand.
- Til op. Breng dat bestand naar de Audiobewerker en normaliseer: het volume stijgt tot vlak onder vol uit, zo luid als een opname kan zijn zonder te vervormen. Exporteer, en verstuur dat.
De reis tussen de twee vraagt geen download: zodra de knipper heeft geëxporteerd, biedt een rij onder zijn downloadknop aan het resultaat rechtstreeks mee te nemen naar de bewerker, en de memo staat daar al klaar.
Beide stappen draaien op je eigen machine. Een spraakmemo is zo ongeveer het persoonlijkste dat een bestand kan zijn, en de gebruikelijke "audio online verbeteren"-sites nemen er een kopie van als prijs voor het schuifje.
Waarom knippen vóór optillen
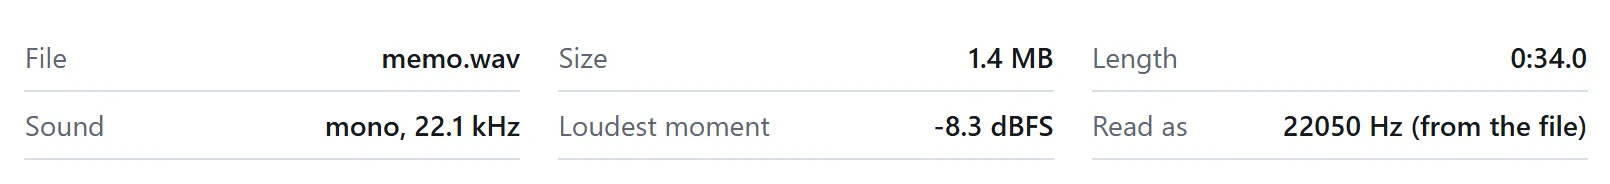
Omdat normaliseren het hele bestand leest om het luidste moment te vinden, en in een rauwe memo is het luidste moment vaak precies wat je op het punt staat te wissen: de bons van de neergelegde telefoon, de kuch vóór de tweede poging. Normaliseer eerst en die piek bepaalt het plafond, zodat de stem er even zacht uitkomt als hij erin ging. Knip de rommel weg en het luidste dat overblijft is de stem zelf, en daar hoort de ruimte aan besteed te worden.
De knipper snijdt op het exacte sample en vervaagt elke las een paar milliseconden, zodat een knip midden in kamergeruis niet kán tikken. Alleen de lassen: de onaangeroerde audio ertussen wordt gekopieerd, niet opnieuw gecodeerd.
Wat de bewerker herstelt, en wat niet
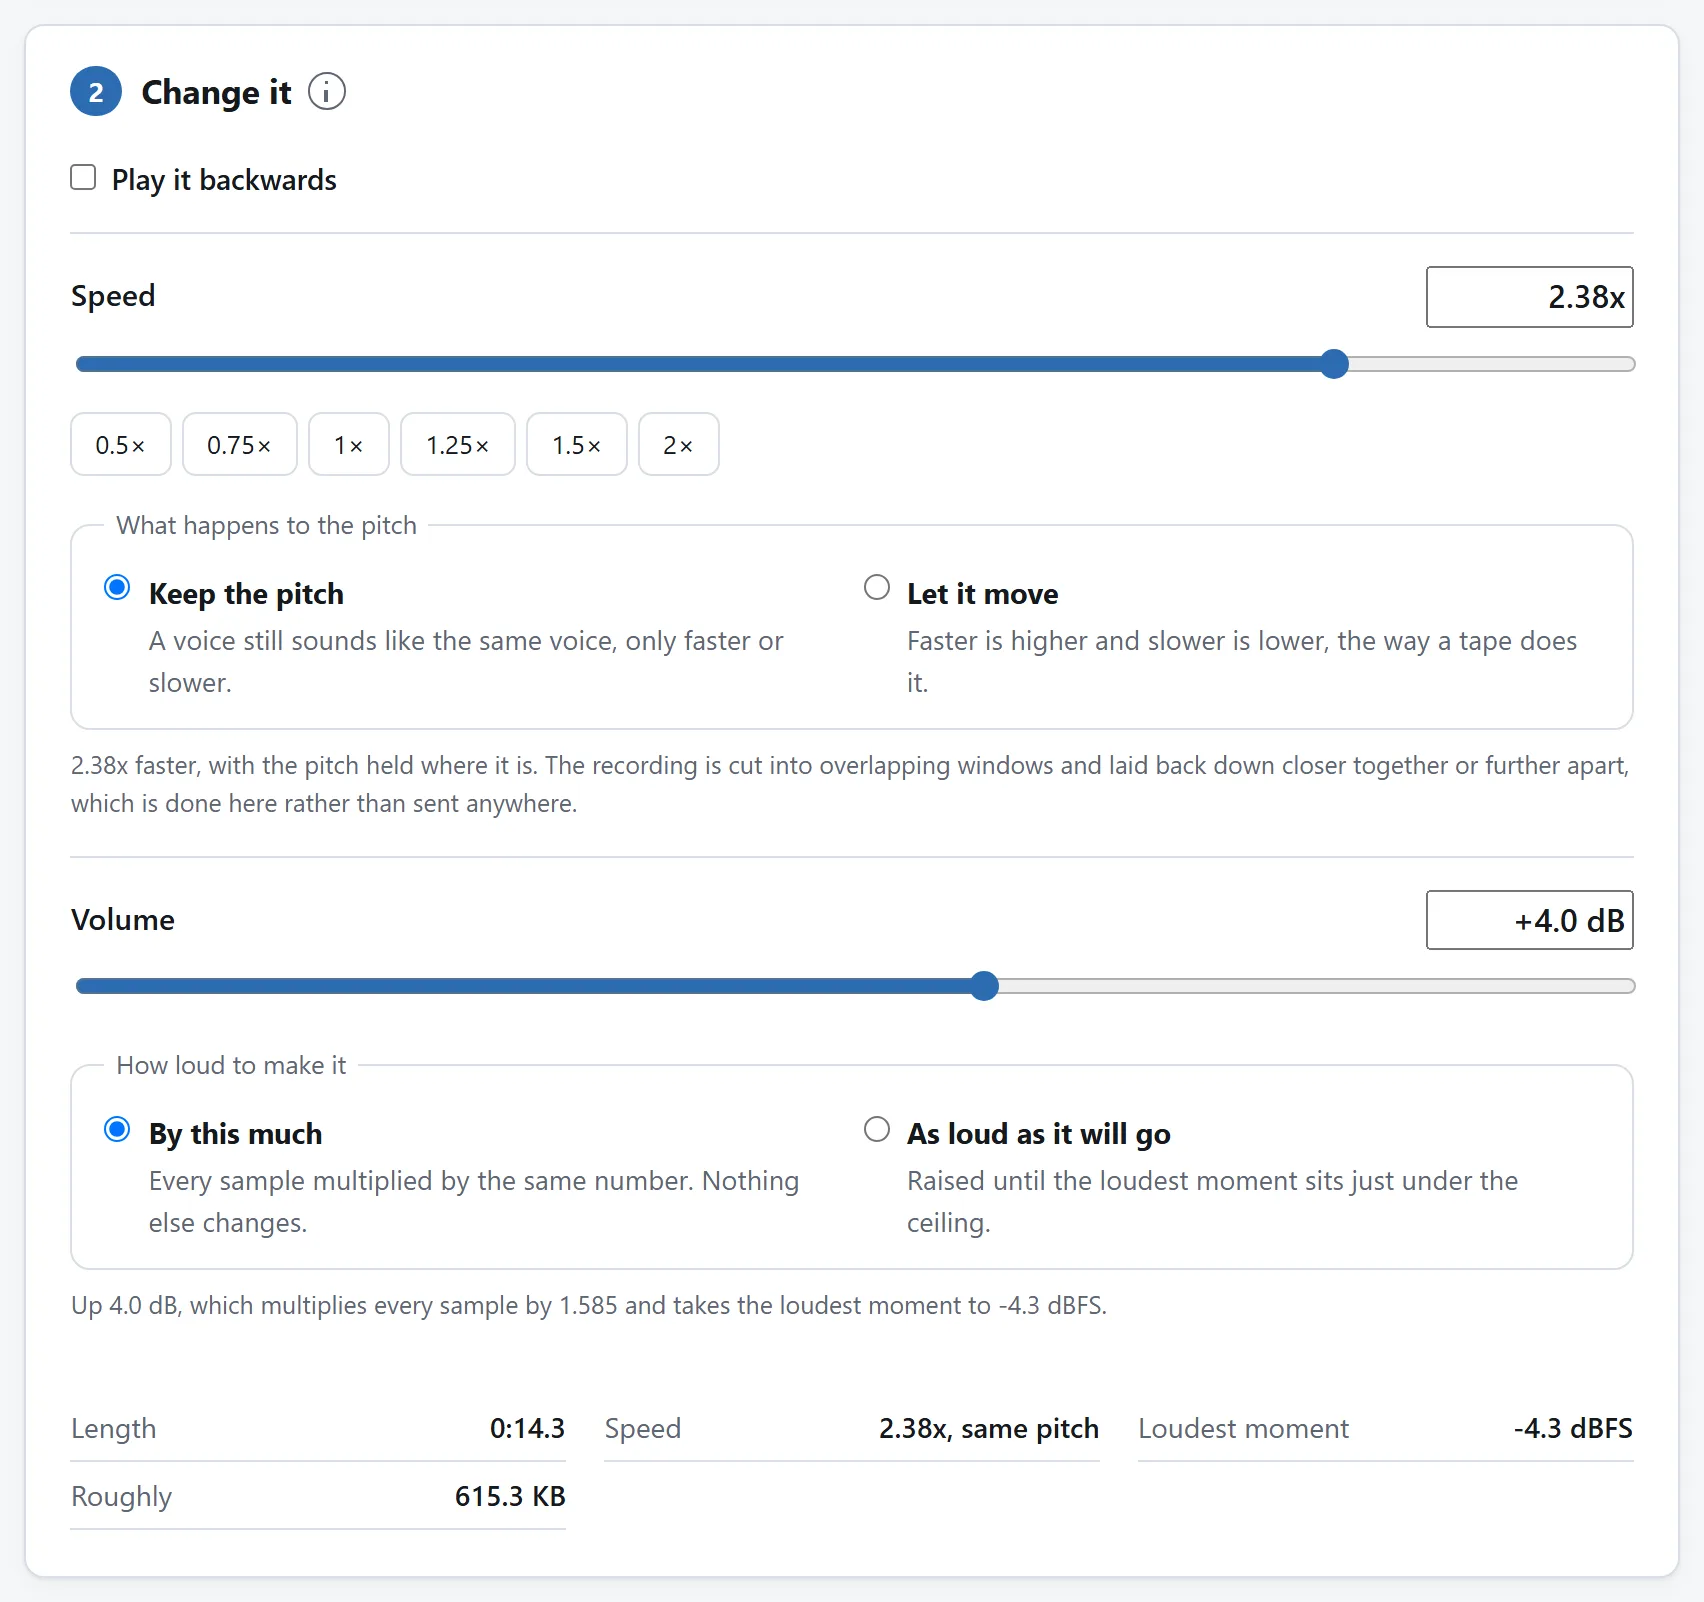
Normaliseren herstelt het zachte. Het herstelt niet het lawaaiige: de airco stijgt mee met de stem, want het is één opname en ze zitten er samen in. Wat een memo verstaanbaar houdt is vooral het knippen — dode lucht is waar de ruis in z'n eentje hoorbaar is — plus de snelheidsknop uit consideratie met de luisteraar: 1,25× met behoud van toonhoogte is de podcasttruc, en die werkt net zo goed op een memo die uitwaaiert.
De bewerker schrijft WAV — exacte samples, geen encoder ertussen — dus het bestand weegt meer dan het gecomprimeerde origineel. Voor een memo die je in minuten meet is dat een eerlijke prijs om nooit een tweede verliesgevende codering op de eerste van de telefoon te stapelen; de messenger die hem verstuurt comprimeert toch nog een keer, en dat hoort de enige keer te zijn.
Dezelfde keten, langere opnames
Een interview, een college, een vergadering: de keten is dezelfde, het knippen levert alleen meer op. Markeer de vragen die ertoe doen, laat de rest vallen, en de markeringen zelf worden als gewoon tekstbestand opgeslagen en weer ingeladen, wat van een lange schoonmaak iets maakt dat je kunt neerleggen en oppakken. Voor audio die in een video woont, haalt de bewerker de track ook uit een MP4 of MOV zonder het beeld aan te raken: de eerste stap om van een opgenomen gesprek iets te maken dat onderweg te beluisteren is.
Als je dit elke week doet
Knippen en optillen wonen met opzet op twee pagina's: elke doet één klus, en elke kan in z'n eentje bewijzen dat de opname je machine nooit heeft verlaten. Maar beide zijn open source: MIT-licentie, één map per gereedschap, ES-modules zonder dependencies waarvan de README's de sample-precieze knippen en de WAV-schrijver uitleggen.
Als de memo's dagelijks binnenstromen, wijs dan een code-agent naar de repository en vraag om de één-pagina-versie: golfvorm, markeringen, normaliseren bij export. De modules zijn geschreven om gelezen te worden, en ze meenemen is precies waar de licentie voor bestaat.