# 여러 이미지를 PDF 하나로 묶는 방법
누군가 “PDF 하나로”를 요구했는데 손에는 종이를 찍은 사진 열한 장이 있습니다. 결과를 실제로 바꾸는 선택은 넷입니다. 페이지 크기, 순서, 품질, 그리고 그 문서가 만든 사람에 대해 흘리는 정보. 그중 무시해도 되는 것이 무엇인지까지 정리했습니다.
[이미지를 PDF로 열기](https://abox.tools/ko/이미지-pdf-변환/): 사진을 문서 하나에 담습니다.
마지막 업데이트 2026년 8월 26일
## 짧은 답
[이미지를 PDF로](https://abox.tools/ko/이미지-pdf-변환/)를 열고 사진을 넣은 다음, 순서가 맞을 때까지 타일을 끌어 옮기고 문서를 만드세요. 기본값은 A4 페이지에 작은 여백, 그리고 다시 인코딩하지 않고 그대로 들어가는 사진입니다. 대부분은 이게 원하던 그것입니다.
한 번 더 생각해 볼 만한 것은 넷입니다. 순서, 페이지 크기, 품질 설정, 그리고 완성된 문서가 만든 사람에 대해 흘리는 정보. 자주 잘못되는 순서대로 적었습니다.
미리보기가 해 볼 만한 유일한 확인입니다. 이것이 완성된 쪽이고, 완성된 쪽이 가질 모양 그대로입니다.
## 무엇보다 순서를 먼저 맞추세요
페이지 순서는 가장 흔히 잘못되는 것 하나입니다. 파일 이름이 아무도 예상하지 못하는 방식으로 정렬되기 때문입니다. 알파벳순으로는 `IMG_2.jpg`가 `IMG_10.jpg` 뒤에 옵니다. 비교가 글자 단위로 이루어지고 `1`이 `2`보다 앞이니까요. `page1`부터 `page12`까지 이름 붙은 스캔 폴더는 거의 어떤 도구에서든 틀린 순서로 들어옵니다.
사진이라면 촬영 날짜순이 대개 더 믿을 만합니다. 종이를 있던 순서대로 찍었을 테니까요. 어느 쪽이든, 나중에 PDF를 확인하지 말고 버튼을 누르기 전에 타일을 확인하세요.
## 품질: 대부분의 도구가 조용히 그르치는 대목
PDF는 JPEG 데이터를 그대로 실을 수 있습니다. 그건 형식의 성질입니다. JPEG의 압축된 바이트를 있는 그대로 문서에 넣을 수 있고, 리더는 브라우저가 하듯 그것을 디코딩합니다.
이게 중요한 이유는, 사진이 PDF로 들어가는 길에 무엇도 잃지 않아도 된다는 뜻이기 때문입니다. 디코딩되지도, 다시 압축되지도 않습니다. 문서 속 사진이 비트 하나까지 원본 파일 속 사진 그대로입니다. 그런데도 많은 도구가 다시 인코딩합니다. 전부 캔버스에 그려 일률적으로 인코딩하는 편이 간단하기 때문인데, 그 바람에 아무 이유 없이 화질 한 세대를 잃습니다.
다른 형식은 그렇게 얹혀 갈 수 없습니다. PNG, WebP, HEIC를 비롯한 나머지는 PDF에 대응하는 필터가 없어서 변환되어야 합니다. 어떻게 할지는 고르실 수 있습니다.
- **JPEG로 다시 인코딩**(기본값). 파일이 가장 작고, 품질을 조금 치르며, 사진에는 맞는 답입니다.
- **무손실.** 정확한 픽셀을 저장하는 대신 문서가 훨씬 커집니다. 스크린샷과 도표, 그리고 글자나 또렷한 가장자리가 있어서 JPEG 흔적이 눈에 띄는 것에는 맞는 답입니다.
## 페이지 크기, 그리고 “사진에 맞추기”가 나을 때
A4, Letter, Legal, A3, A5, Tabloid 같은 표준 페이지 크기는 각 이미지를 그 크기의 쪽에 여백 안으로 맞춰 배치합니다. 문서를 인쇄할 것이거나 공적인 곳에 보관할 것이라면 이쪽을 쓰세요.
“이미지에 페이지 맞추기”는 모든 쪽을 그 이미지 크기에 맞춰, 흰 여백도 크기 조절도 전혀 없게 만듭니다. PDF가 문서라기보다 사진을 담는 그릇일 때 쓰세요. 포트폴리오, 스크린샷 묶음, 만화 같은 것들요. 인쇄하면 이상해 보입니다. 쪽마다 크기가 다르니까요.
인쇄할 것이라면 여백을 두는 편이 좋습니다. 가정용 프린터는 종이 가장자리까지 인쇄하지 못해서, 가장자리에 딱 붙인 사진은 잘려 나옵니다.
### 가로로 찍은 사진을 세로 쪽에
휴대폰을 옆으로 들고 종이를 찍었다면 모든 이미지가 가로가 되어 세로 쪽 한가운데 작게 앉게 됩니다. 문서를 만들기 전에 각각을 90도 돌리면 해결되는데, 전체가 아니라 이미지별 선택입니다. 대개 몇 장은 제대로 들어와 있으니까요.
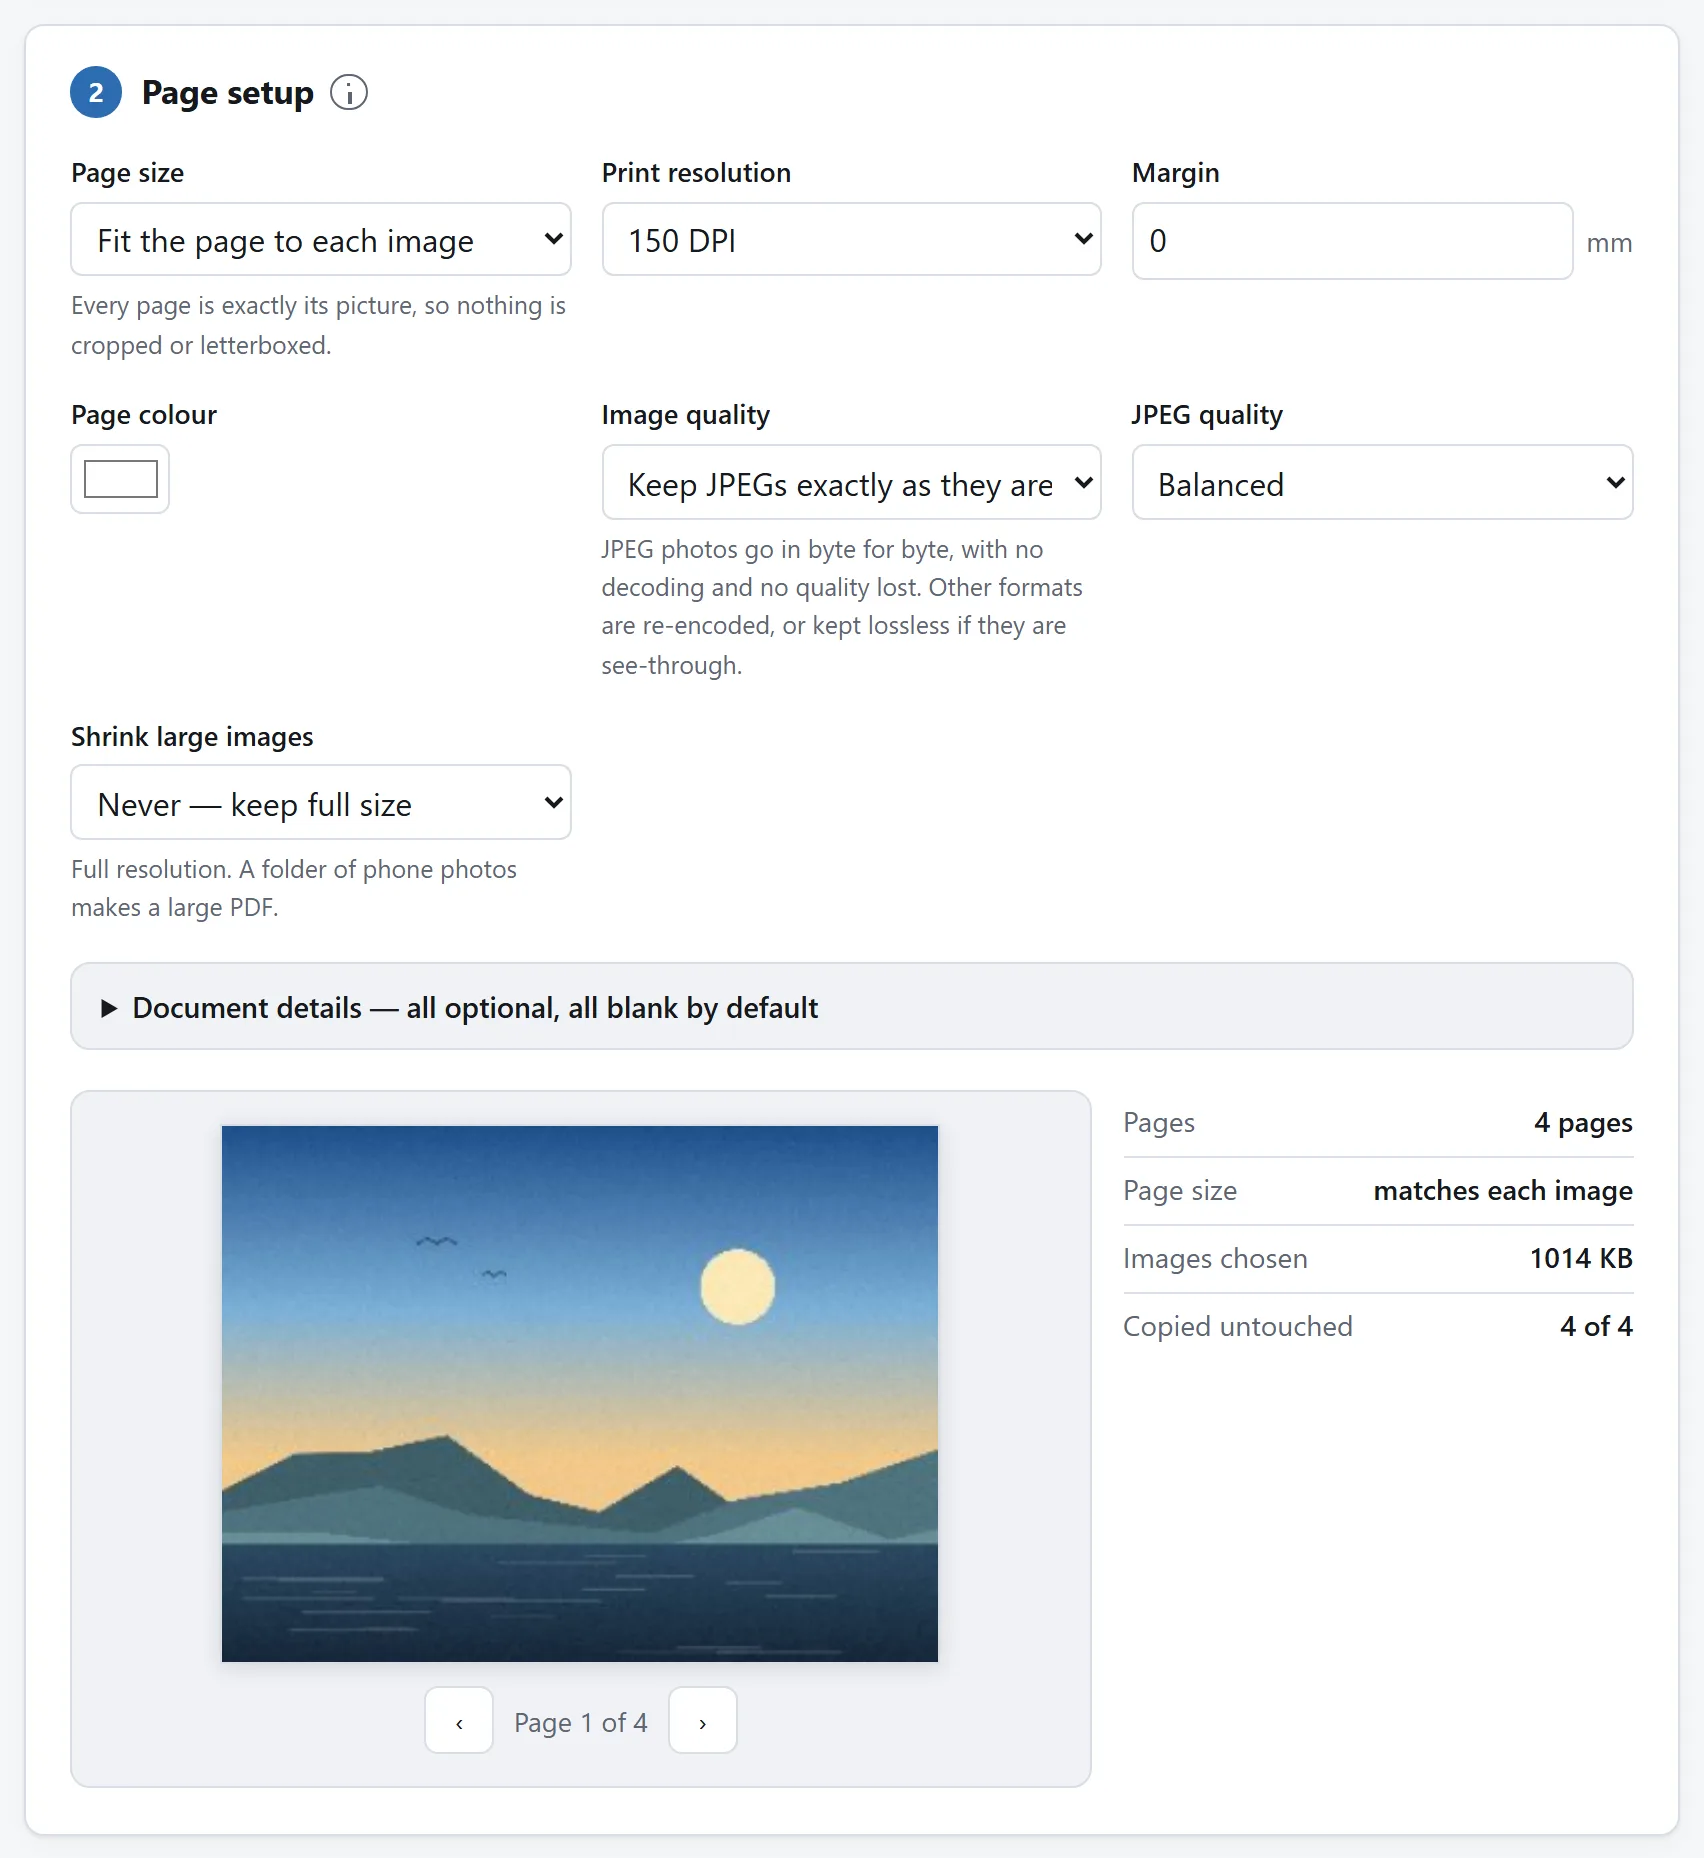
쪽 크기와 맞춤 방식이 함께 사진이 통째로 보일지 종이에 맞춰 잘릴지를 정합니다. 각 이미지에 맞추는 선택은 그 질문 자체를 없애 버립니다.
## 완성된 PDF가 만든 사람에 대해 흘리는 정보
PDF에는 문서 정보 블록이 들어 있습니다. 작성자, 제작 프로그램, 만든 날짜, 때로는 제목까지요. 무엇이 썼느냐에 따라 계정 이름과 기기 이름, 그리고 만든 정확한 시각이 들어갈 수 있습니다.
생각해 볼 만한 일입니다. PDF는 사람이 사람에게 보내는 물건이니까요. 입사 지원서, 청구서, 집주인에게 보내는 서류. 메타데이터가 그것과 함께 가고, 어떤 리더든 그것을 보여 줄 수 있습니다.
여기 도구는 자기 이름을 빼고 그 블록을 비워 둡니다. 파일명도, 기기 이름도, 사용자 이름도 없고, 체크박스를 켜지 않으면 만든 날짜도 없습니다. 다른 도구를 쓰신다면, 결과의 속성을 한 번 열어 무엇이 쓰였는지 보실 만합니다.
별개로, 이미지 자체도 있습니다. 사진에 EXIF와 GPS 태그가 있다면 그것이 어떻게 되는지는 경로에 달렸습니다. 다시 인코딩되지 않고 복사되어 들어간 JPEG는 안에 있던 것을 그대로 지니고, 다시 인코딩되는 이미지는 부수적으로 태그를 잃습니다. 중요하다면 [EXIF 확인 및 제거](https://abox.tools/ko/exif-정보-삭제/)로 사진을 먼저 정리하세요. 거기 무엇이 들었는지는 [그 가이드](https://abox.tools/ko/가이드/사진-위치정보-삭제/)가 설명합니다.
## PDF가 너무 크게 나왔다면
휴대폰 사진은 큽니다. 스무 장이면 메일이 거부하는 문서가 됩니다. 순서대로 세 가지를 해 보세요.
**긴 변을 줄이세요.** 종이 한 장을 찍은 4000픽셀짜리 사진은 어떤 리더도 프린터도 쓰지 못할 만큼 많은 디테일을 싣고 있습니다. 긴 변을 2000픽셀쯤으로 내리면 대개 파일이 4분의 1이 되고, 쪽에서 누구도 알아볼 만한 변화는 없습니다.
사진 같은 것에는 **무손실 대신 JPEG를 쓰세요.** 무손실은 도표에는 맞는 답이고 종이를 찍은 사진에는 틀린 답입니다.
**완성된 문서를 압축하세요.** [PDF 압축](https://abox.tools/ko/pdf-용량-줄이기/)은 픽셀 수가 아니라 각 이미지가 지면에 얼마나 크게 그려지는지를 기준으로 일하는데, 중요한 측정이 그것입니다. 그 대가는 [그 가이드](https://abox.tools/ko/가이드/pdf-용량-줄이는-법/)에 적혀 있습니다.
이미지를 몇 장까지 쓸 수 있는지 도구에 정해 둔 제한은 없습니다. 현실적인 한계는 기기의 메모리입니다. 완성된 문서가 내려받기 전에 거기서 조립되니까요. 원본 해상도의 휴대폰 사진 수백 장이면 먼저 체감하게 되는데, 긴 변을 줄이면 그 한계가 한참 멀어집니다.
## 이것으로 얻지 못하는 것
사진으로 만든 PDF는 그림으로 가득한 PDF입니다. 그 안의 글자는 텍스트가 아닙니다. 검색할 수도, 복사할 수도, 화면 낭독기가 읽어 줄 수도 없습니다. 변환의 성질이 아니라 시작한 재료의 성질입니다.
검색되는 텍스트가 필요하다면 OCR이 필요하고, 그건 다른 일입니다. 그리고 원본 문서가 아직 문서로 어딘가에 남아 있다면, 그것을 바로 PDF로 내보내는 편이 찍는 것보다 언제나 낫습니다. 더 작고, 더 선명하고, 검색까지 됩니다.
## 여기에 업로드가 필요 없는 이유
PDF를 쓴다는 것은 구조화된 파일을 쓴다는 뜻입니다. 헤더, 객체의 집합, 상호 참조 표. 브라우저가 못 할 것이 하나도 없고, 사진이 어딘가로 가야 할 이유도 없습니다.
여기서는 특히 신경 쓸 만합니다. 사람들이 이런 문서에 무엇을 넣는지 생각해 보면요. 신분증, 은행 명세서, 진단서, 서명한 계약서. 애초에 PDF를 만드는 이유는 대개 그걸 기관에 보내려는 것입니다. 여기 도구에는 네트워크 기능이 하나도 없고, 페이지의 `Content-Security-Policy`가 연결 가능한 주소를 전부 적어 두는데 그중 이 사이트의 것은 없습니다.
[온라인 변환 사이트에 파일을 올려도 안전할까요?](https://abox.tools/ko/가이드/파일-업로드-안전한가/)에 여기서든 다른 어디서든 그것을 직접 확인하는 방법이 적혀 있습니다.
짧은 답
이미지를 PDF로를 열고 사진을 넣은 다음, 순서가 맞을 때까지 타일을 끌어 옮기고 문서를 만드세요. 기본값은 A4 페이지에 작은 여백, 그리고 다시 인코딩하지 않고 그대로 들어가는 사진입니다. 대부분은 이게 원하던 그것입니다.
한 번 더 생각해 볼 만한 것은 넷입니다. 순서, 페이지 크기, 품질 설정, 그리고 완성된 문서가 만든 사람에 대해 흘리는 정보. 자주 잘못되는 순서대로 적었습니다.
미리보기가 해 볼 만한 유일한 확인입니다. 이것이 완성된 쪽이고, 완성된 쪽이 가질 모양 그대로입니다.
무엇보다 순서를 먼저 맞추세요
페이지 순서는 가장 흔히 잘못되는 것 하나입니다. 파일 이름이 아무도 예상하지 못하는 방식으로 정렬되기 때문입니다. 알파벳순으로는 IMG_2.jpg가 IMG_10.jpg 뒤에 옵니다. 비교가 글자 단위로 이루어지고 1이 2보다 앞이니까요. page1부터 page12까지 이름 붙은 스캔 폴더는 거의 어떤 도구에서든 틀린 순서로 들어옵니다.
사진이라면 촬영 날짜순이 대개 더 믿을 만합니다. 종이를 있던 순서대로 찍었을 테니까요. 어느 쪽이든, 나중에 PDF를 확인하지 말고 버튼을 누르기 전에 타일을 확인하세요.
품질: 대부분의 도구가 조용히 그르치는 대목
PDF는 JPEG 데이터를 그대로 실을 수 있습니다. 그건 형식의 성질입니다. JPEG의 압축된 바이트를 있는 그대로 문서에 넣을 수 있고, 리더는 브라우저가 하듯 그것을 디코딩합니다.
이게 중요한 이유는, 사진이 PDF로 들어가는 길에 무엇도 잃지 않아도 된다는 뜻이기 때문입니다. 디코딩되지도, 다시 압축되지도 않습니다. 문서 속 사진이 비트 하나까지 원본 파일 속 사진 그대로입니다. 그런데도 많은 도구가 다시 인코딩합니다. 전부 캔버스에 그려 일률적으로 인코딩하는 편이 간단하기 때문인데, 그 바람에 아무 이유 없이 화질 한 세대를 잃습니다.
다른 형식은 그렇게 얹혀 갈 수 없습니다. PNG, WebP, HEIC를 비롯한 나머지는 PDF에 대응하는 필터가 없어서 변환되어야 합니다. 어떻게 할지는 고르실 수 있습니다.
JPEG로 다시 인코딩(기본값). 파일이 가장 작고, 품질을 조금 치르며, 사진에는 맞는 답입니다.
무손실. 정확한 픽셀을 저장하는 대신 문서가 훨씬 커집니다. 스크린샷과 도표, 그리고 글자나 또렷한 가장자리가 있어서 JPEG 흔적이 눈에 띄는 것에는 맞는 답입니다.
페이지 크기, 그리고 “사진에 맞추기”가 나을 때
A4, Letter, Legal, A3, A5, Tabloid 같은 표준 페이지 크기는 각 이미지를 그 크기의 쪽에 여백 안으로 맞춰 배치합니다. 문서를 인쇄할 것이거나 공적인 곳에 보관할 것이라면 이쪽을 쓰세요.
“이미지에 페이지 맞추기”는 모든 쪽을 그 이미지 크기에 맞춰, 흰 여백도 크기 조절도 전혀 없게 만듭니다. PDF가 문서라기보다 사진을 담는 그릇일 때 쓰세요. 포트폴리오, 스크린샷 묶음, 만화 같은 것들요. 인쇄하면 이상해 보입니다. 쪽마다 크기가 다르니까요.
인쇄할 것이라면 여백을 두는 편이 좋습니다. 가정용 프린터는 종이 가장자리까지 인쇄하지 못해서, 가장자리에 딱 붙인 사진은 잘려 나옵니다.
가로로 찍은 사진을 세로 쪽에
휴대폰을 옆으로 들고 종이를 찍었다면 모든 이미지가 가로가 되어 세로 쪽 한가운데 작게 앉게 됩니다. 문서를 만들기 전에 각각을 90도 돌리면 해결되는데, 전체가 아니라 이미지별 선택입니다. 대개 몇 장은 제대로 들어와 있으니까요.
쪽 크기와 맞춤 방식이 함께 사진이 통째로 보일지 종이에 맞춰 잘릴지를 정합니다. 각 이미지에 맞추는 선택은 그 질문 자체를 없애 버립니다.
완성된 PDF가 만든 사람에 대해 흘리는 정보
PDF에는 문서 정보 블록이 들어 있습니다. 작성자, 제작 프로그램, 만든 날짜, 때로는 제목까지요. 무엇이 썼느냐에 따라 계정 이름과 기기 이름, 그리고 만든 정확한 시각이 들어갈 수 있습니다.
생각해 볼 만한 일입니다. PDF는 사람이 사람에게 보내는 물건이니까요. 입사 지원서, 청구서, 집주인에게 보내는 서류. 메타데이터가 그것과 함께 가고, 어떤 리더든 그것을 보여 줄 수 있습니다.
여기 도구는 자기 이름을 빼고 그 블록을 비워 둡니다. 파일명도, 기기 이름도, 사용자 이름도 없고, 체크박스를 켜지 않으면 만든 날짜도 없습니다. 다른 도구를 쓰신다면, 결과의 속성을 한 번 열어 무엇이 쓰였는지 보실 만합니다.
별개로, 이미지 자체도 있습니다. 사진에 EXIF와 GPS 태그가 있다면 그것이 어떻게 되는지는 경로에 달렸습니다. 다시 인코딩되지 않고 복사되어 들어간 JPEG는 안에 있던 것을 그대로 지니고, 다시 인코딩되는 이미지는 부수적으로 태그를 잃습니다. 중요하다면 EXIF 확인 및 제거로 사진을 먼저 정리하세요. 거기 무엇이 들었는지는 그 가이드가 설명합니다.
PDF가 너무 크게 나왔다면
휴대폰 사진은 큽니다. 스무 장이면 메일이 거부하는 문서가 됩니다. 순서대로 세 가지를 해 보세요.
긴 변을 줄이세요. 종이 한 장을 찍은 4000픽셀짜리 사진은 어떤 리더도 프린터도 쓰지 못할 만큼 많은 디테일을 싣고 있습니다. 긴 변을 2000픽셀쯤으로 내리면 대개 파일이 4분의 1이 되고, 쪽에서 누구도 알아볼 만한 변화는 없습니다.
사진 같은 것에는 무손실 대신 JPEG를 쓰세요. 무손실은 도표에는 맞는 답이고 종이를 찍은 사진에는 틀린 답입니다.
완성된 문서를 압축하세요.PDF 압축은 픽셀 수가 아니라 각 이미지가 지면에 얼마나 크게 그려지는지를 기준으로 일하는데, 중요한 측정이 그것입니다. 그 대가는 그 가이드에 적혀 있습니다.
이미지를 몇 장까지 쓸 수 있는지 도구에 정해 둔 제한은 없습니다. 현실적인 한계는 기기의 메모리입니다. 완성된 문서가 내려받기 전에 거기서 조립되니까요. 원본 해상도의 휴대폰 사진 수백 장이면 먼저 체감하게 되는데, 긴 변을 줄이면 그 한계가 한참 멀어집니다.
이것으로 얻지 못하는 것
사진으로 만든 PDF는 그림으로 가득한 PDF입니다. 그 안의 글자는 텍스트가 아닙니다. 검색할 수도, 복사할 수도, 화면 낭독기가 읽어 줄 수도 없습니다. 변환의 성질이 아니라 시작한 재료의 성질입니다.
검색되는 텍스트가 필요하다면 OCR이 필요하고, 그건 다른 일입니다. 그리고 원본 문서가 아직 문서로 어딘가에 남아 있다면, 그것을 바로 PDF로 내보내는 편이 찍는 것보다 언제나 낫습니다. 더 작고, 더 선명하고, 검색까지 됩니다.
여기에 업로드가 필요 없는 이유
PDF를 쓴다는 것은 구조화된 파일을 쓴다는 뜻입니다. 헤더, 객체의 집합, 상호 참조 표. 브라우저가 못 할 것이 하나도 없고, 사진이 어딘가로 가야 할 이유도 없습니다.
여기서는 특히 신경 쓸 만합니다. 사람들이 이런 문서에 무엇을 넣는지 생각해 보면요. 신분증, 은행 명세서, 진단서, 서명한 계약서. 애초에 PDF를 만드는 이유는 대개 그걸 기관에 보내려는 것입니다. 여기 도구에는 네트워크 기능이 하나도 없고, 페이지의 Content-Security-Policy가 연결 가능한 주소를 전부 적어 두는데 그중 이 사이트의 것은 없습니다.

