Het korte antwoord
Open de DICOM-viewer en sleep de hele map met bestanden erop. Ze worden op je eigen machine gelezen, teruggezet in de series waar ze uit komen, en gestapeld in de volgorde waarin het apparaat ze heeft opgenomen. Er wordt niets geüpload, en er wordt niets terug in je bestanden geschreven.
Als je een schijfje hebt gekregen en je je afvraagt welk bestand je moet openen: allemaal, tegelijk. Een CT of een MRI is niet één bestand. Het is één bestand per coupe, en een thoraxonderzoek zijn er driehonderd.
Wat er op een ziekenhuisschijfje staat
Meestal vier dingen, en maar één ervan doet ertoe.
- Een map met scans, vaak
DICOM,IMAGESofST0001geheten, met bestanden dieIM000001,I0000001of een lang nummer met punten heten. Vaak helemaal zonder extensie. Dit is de scan. - Een bestand dat
DICOMDIRheet. Een index van de rest, geschreven zodat een viewer de onderzoeken op het schijfje kan opsommen zonder elk bestand te openen. Je hebt hem niet nodig. - Een viewer, als Windows-programma, als autorun-vermelding of af en toe als Java-applet. Hij is gecompileerd voor wat er actueel was toen het schijfje gebrand werd, en daarom draaien er zoveel niet meer.
- Een HTML-pagina of een PDF met het logo van het ziekenhuis erop, waarin uitgelegd wordt hoe je de viewer start.
De scans hebben die viewer niet nodig. Het formaat is een gepubliceerde standaard en de bestanden zijn op zichzelf leesbaar; het programma op het schijfje is één programma dat ze zou kunnen lezen, niet het enige.
Waarom de bestanden geen extensie hebben
Omdat DICOM er geen nodig heeft. Elk bestand draagt zijn eigen markering: 128 bytes niets, dan de vier letters DICM, dan een klein blok velden dat beschrijft hoe de rest van het bestand geschreven is. Een lezer controleert op die vier letters en niet op een naam die op .dcm eindigt.
Daarom verandert een bestand hernoemen naar .dcm ook niets, en daarom is een viewer die op de extensie staat te hameren onnodig streng. Bestanden die rechtstreeks van een ziekenhuisnetwerk geschreven zijn hebben zelfs de 128 bytes en de markering niet — dat zijn de kale gegevens zonder iets ervoor, en een lezer moet uit het eerste veld afleiden hoe ze gecodeerd zijn. Dat is een normaal bestand, geen kapot bestand.
Venster en niveau, en dat is de knop die ertoe doet
Dit is het ene ding dat een medisch beeld anders maakt dan een foto, en de reden dat een fotobewerker niet deugt om ernaar te kijken.
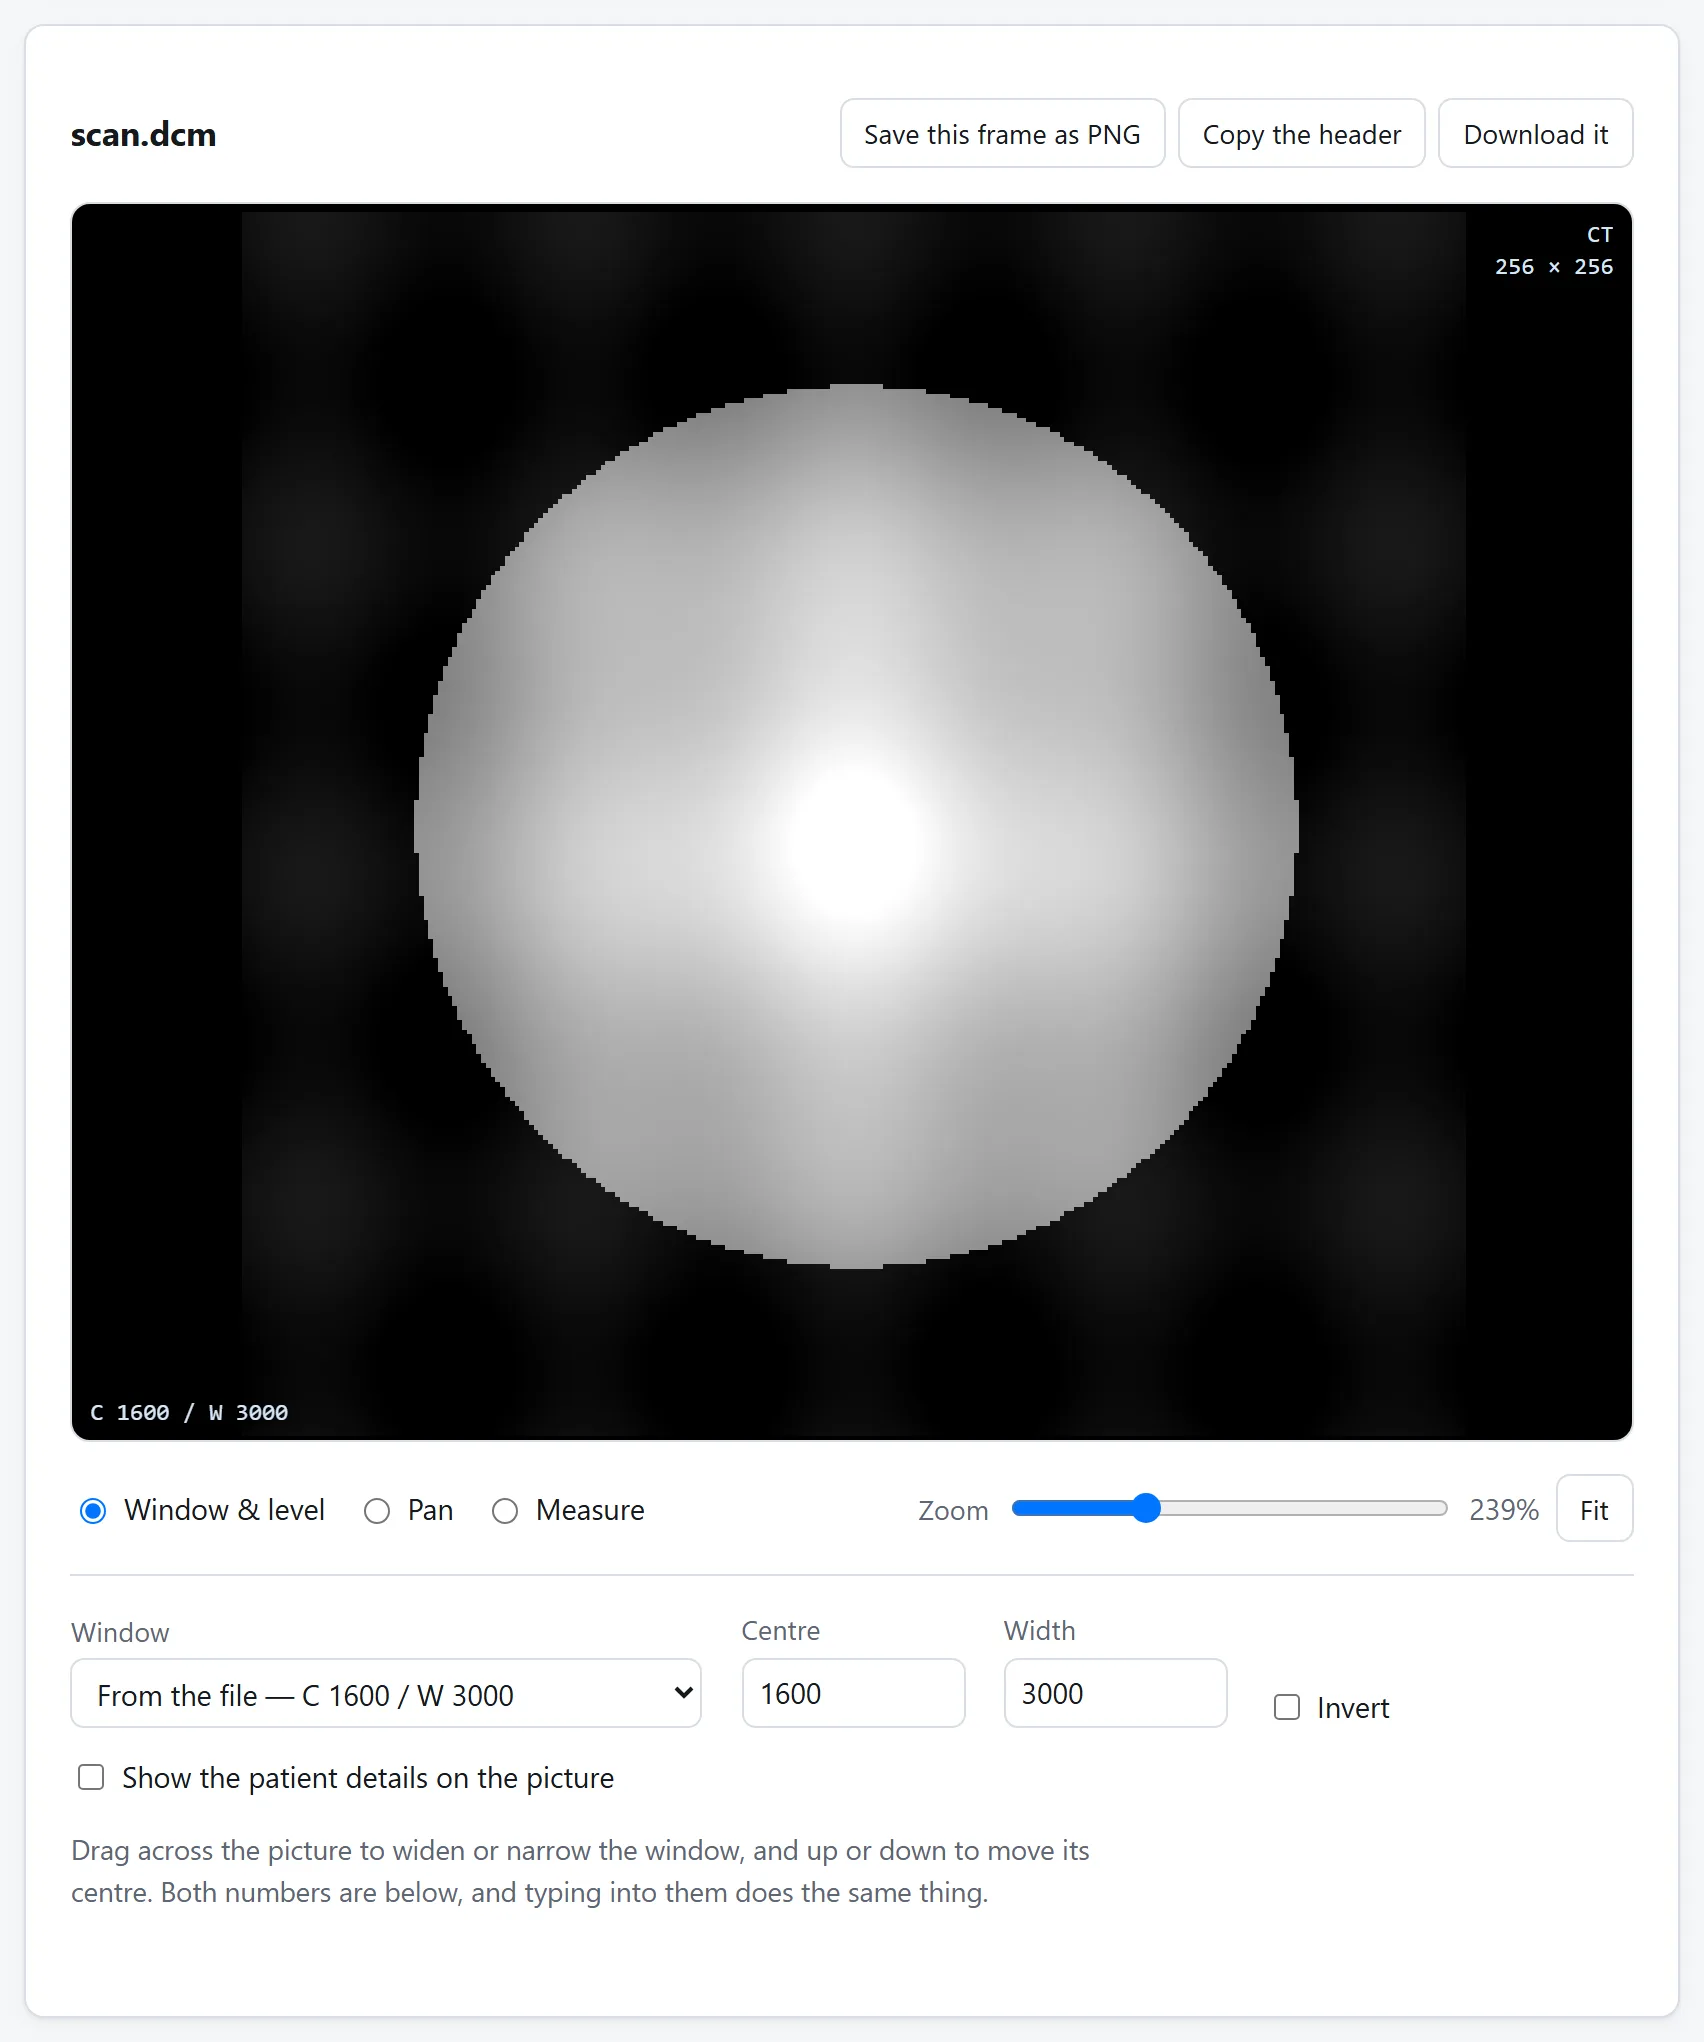
Een CT-coupe bevat zo'n vierduizend verschillende waarden. Je scherm laat tweehonderdzesenvijftig grijstinten zien. Iets moet beslissen welke vierduizend op welke tweehonderdzesenvijftig terechtkomen, en die beslissing is het venster: alles eronder is zwart, alles erboven is wit, en het bereik ertussen wordt over de grijstinten verdeeld.
Verschuif het venster en hetzelfde bestand lijkt een andere scan. Dat is geen renderfout, dat is juist de bedoeling. Long en bot zitten allebei in de coupe en zijn niet tegelijk te zien: een venster dat de structuur van een opgeblazen long laat zien, zet elk bot op zuiver wit, en een venster dat het trabeculaire detail in een rib laat zien, zet de hele long op zuiver zwart.
Op een CT zijn de getallen Hounsfield-eenheden, en die zijn absoluut vastgelegd in plaats van per apparaat: water is 0 en lucht is −1000, per definitie, op elke CT-scanner ter wereld. Daarom kan een viewer vensters met een naam aanbieden — long, bot, hersenen, zacht weefsel — en betekenen die op jouw bestand hetzelfde als op het werkstation waar de scan beoordeeld is. De gebruikelijke:
- Zacht weefsel — midden 40, breedte 400.
- Long — midden −600, breedte 1500.
- Bot — midden 300, breedte 1500.
- Hersenen — midden 40, breedte 80. Een smal venster, want grijze en witte stof verschillen maar een paar eenheden.
Op een MRI bestaat zo'n schaal niet. De waarden hangen af van de sequentie, de spoel en het apparaat, dus er valt niets te vernoemen als preset en het venster om mee te beginnen is het venster waar het bestand zelf om vraagt. Elke scan draagt een suggestie mee.
Waarom de coupes soms de verkeerde kant op schuiven
Een viewer moet beslissen in welke volgorde hij de bestanden zet, en er zijn twee dingen in het bestand die hij zou kunnen gebruiken.
Instance Number is een teller. Het is de voor de hand liggende keuze en hij wordt toegekend door wat de bestanden ook geschreven heeft, en dat hoeft ze niet te nummeren in de richting waarin de patiënt loopt. Een onderzoek dat van de voeten omhoog gereconstrueerd is en van het hoofd omlaag genummerd, schuift achteruit, en een serie die uit twee reconstructies is samengesteld kan de nummers ronduit herhalen.
Image Position (Patient) is waar de coupe fysiek ligt, in millimeters, in een coördinatenstelsel dat aan de patiënt vastzit en niet aan het apparaat. Daarop sorteren is goed, wat de nummering ook gedaan heeft, en het heeft een nuttig neveneffect: zodra de coupes in fysieke volgorde liggen, is de afstand ertussen meetbaar, dus een viewer kan je vertellen dat de coupes 5 mm uit elkaar liggen — en merken wanneer er één ontbreekt, wat het bestand nooit zegt.
Iets meten
Een scan is gemeten materiaal, dus een lengte erop is een echte lengte — als het bestand zegt hoe ver zijn pixels uit elkaar liggen. Dat is één veld, Pixel Spacing, in millimeters, en het staat op vrijwel elke CT en MRI.
Het ontbreekt vaak op echobeelden, op gescande documenten en op schermafbeeldingen die als DICOM zijn opgeslagen. Waar het ontbreekt is er geen eerlijk antwoord in millimeters, en een viewer die er toch een geeft heeft een schaal verzonnen. Een aantal pixels is het juiste antwoord op een vraag die het bestand niet kan beantwoorden.
Let ook op pixels die niet vierkant zijn, wat buiten de CT normaal is. In pixels meten en met één afstandsgetal vermenigvuldigen klopt alleen waar de twee gelijk zijn; elke as moet met zijn eigen getal gemeten worden.
Wat een scan behalve het beeld meedraagt
Dit is het deel waarin mensen zich vergissen, en de reden om voorzichtig te zijn met deze bestanden.
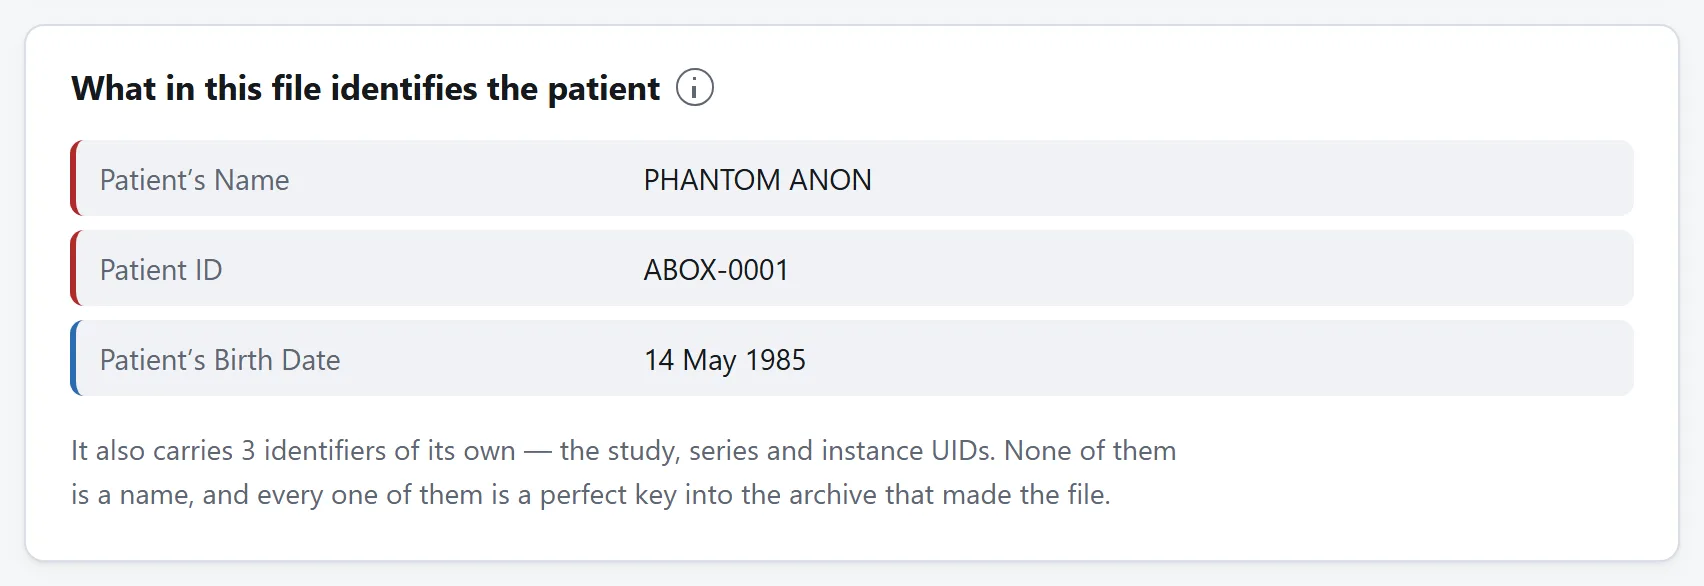
Een DICOM-bestand is geen plaatje met wat metagegevens eraan. Het is een medisch dossier met een plaatje erin. De header is een lijst velden, en op een gebruikelijke klinische scan bevat die:
- de naam van de patiënt, het patientennummer, de geboortedatum en het geslacht;
- het aanvraagnummer, dat de sleutel is naar de aanvraag in het systeem van het ziekenhuis;
- de verwijzend arts, de laborant die het onderzoek uitvoerde, de radioloog die het beoordeelde;
- de instelling, het adres ervan en de afdeling;
- de fabrikant van het apparaat, het model en het serienummer;
- de datum en het tijdstip van de scan tot op de seconde;
- en een reeks unieke identificatoren — onderzoek, serie, instantie — die perfecte sleutels terug zijn naar het archief waar het bestand vandaan komt.
Elk bestand dat je gekregen hebt draagt dat allemaal mee, en het reist met het bestand mee waar het bestand ook heen gaat. De naam wissen is niet genoeg: een geboortedatum, een instelling ter grootte van een postcode en een scantijdstip wijzen ongeveer even goed één persoon aan als een naam doet, en de onderzoeks-UID wijst hem precies aan voor iedereen met toegang tot het archief.
Sommige apparaten bewaren ook een tweede kopie van de naam van de patiënt in een privé-veld, en dat is een veld waarvan de betekenis nergens gepubliceerd is en waar de meeste anonimiseerders vanaf blijven, omdat ze niet kunnen weten wat erin staat.
Upload de scan niet om ernaar te kijken
De gebruikelijke manier waarop dit probleem opgelost wordt is zoeken op „dicom viewer online” en een uploadvak. Wat er dan net gebeurd is, is dat een vreemde een kopie van een medisch dossier heeft: de pixels, de naam, de geboortedatum, het patientennummer en de sleutel terug naar het archief.
Daar is geen reden voor. Een DICOM-bestand lezen is een header ontleden en wat gehele getallen uitpakken, en dat doet een browser prima, en daarom heeft de viewer hier helemaal geen netwerkfunctie: geen fetch, geen XMLHttpRequest, niets dat een bestand zou kunnen versturen ook al probeerde iets het. Laad de pagina één keer, verbreek de internetverbinding, en hij blijft scans openen.
Is het veilig om bestanden naar online omzetters te uploaden? zet uiteen hoe je die bewering nakijkt, op deze site of op een andere. Dit is het bestandstype waarbij dat het meest de moeite waard is.
Wat een browser niet kan
Twee dingen, en over allebei is het de moeite waard om duidelijk te zijn.
Het is geen diagnostische viewer. Je scherm is niet gekalibreerd, de browser is geen gevalideerde renderketen, en geen webpagina heeft een regelgevingsbeoordeling doorlopen. Een scan lezen om een klinische beslissing te nemen is werk voor het werkstation waarop hij beoordeeld is. Kijken wat er op een schijfje staat, een coupe eruit halen voor een college of een artikel, een header lezen, of uitzoeken waarom een ander programma het bestand weigert, zijn allemaal prima redenen om er een in een browser te openen.
Sommige gecomprimeerde scans decoderen niet. DICOM staat verschillende compressieschema's toe en browsers implementeren er één van. Gewone bestanden, run-length gecodeerde bestanden, baseline JPEG en JPEG Lossless — en dat laatste gebruiken de meeste ziekenhuisexports — gaan allemaal open. JPEG 2000, JPEG-LS en de videoformaten vragen codecs die megabytes aan gecompileerde bibliotheek zijn. Waar het beeld niet gedecodeerd kan worden is de header nog steeds volledig leesbaar, en dat is meestal toch de helft waar je voor kwam.