छोटा जवाब
DICOM व्यूअर खोलिए और फ़ाइलों का पूरा फ़ोल्डर उस पर खींचकर छोड़ दीजिए। वे आपकी अपनी मशीन पर पढ़ी जाती हैं, अपनी-अपनी सीरीज़ में वापस बैठा दी जाती हैं, और उसी क्रम में लग जाती हैं जिसमें मशीन ने उन्हें लिया था। कुछ भी अपलोड नहीं होता, और आपकी फ़ाइलों में कुछ दोबारा लिखा भी नहीं जाता।
अगर आपको कोई डिस्क मिली है और आप सोच रहे हैं कि कौन-सी फ़ाइल खोलें, तो सारी, एक साथ। CT या MRI एक फ़ाइल नहीं होती। हर स्लाइस की अपनी फ़ाइल होती है, और छाती की जाँच में वे तीन सौ तक होती हैं।
अस्पताल की डिस्क में क्या होता है
आम तौर पर चार चीज़ें, और उनमें से सिर्फ़ एक मायने रखती है।
- स्कैन का एक फ़ोल्डर, जिसका नाम अक्सर
DICOM,IMAGESयाST0001होता है, और जिसमेंIM000001,I0000001या बिंदुओं वाला कोई लंबा नंबर नाम की फ़ाइलें होती हैं। कई बार तो कोई एक्सटेंशन ही नहीं होता। यही स्कैन है। -
DICOMDIRनाम की एक फ़ाइल, जो बाकी सबकी सूची है और इसलिए लिखी जाती है कि कोई व्यूअर हर फ़ाइल खोले बिना डिस्क की जाँचें गिना सके। आपको इसकी ज़रूरत नहीं। - एक व्यूअर, जो विंडोज़ का प्रोग्राम, कोई ऑटोरन एंट्री, या कभी-कभी कोई जावा ऐप्लेट होता है। वह उसी ज़माने के लिए कंपाइल हुआ था जब डिस्क जलाई गई थी, और इसीलिए उनमें से इतने सारे अब चलते ही नहीं।
- अस्पताल के लोगो वाला कोई HTML पेज या PDF, जो बताता है कि व्यूअर कैसे चलाना है।
स्कैन को उस व्यूअर की ज़रूरत नहीं है। यह फ़ॉर्मैट एक प्रकाशित मानक है और फ़ाइलें अपने आप में पढ़ी जा सकती हैं। डिस्क वाला प्रोग्राम बस एक प्रोग्राम है जो उन्हें पढ़ सकता है, अकेला नहीं।
फ़ाइलों पर एक्सटेंशन क्यों नहीं होता
क्योंकि DICOM को उसकी ज़रूरत ही नहीं। हर फ़ाइल अपना निशान खुद लिए चलती है, यानी 128 बाइट का कुछ नहीं, फिर DICM ये चार अक्षर, और फिर फ़ील्डों का एक छोटा-सा हिस्सा जो बताता है कि बाकी फ़ाइल किस तरह लिखी गई है। पढ़ने वाला .dcm पर खत्म होने वाला नाम नहीं, वही चार अक्षर देखता है।
इसीलिए किसी फ़ाइल का नाम बदलकर .dcm कर देने से कुछ नहीं बदलता, और इसीलिए वह व्यूअर बेवजह सख्त है जो एक्सटेंशन पर अड़ता है। जो फ़ाइलें सीधे अस्पताल के नेटवर्क से लिखी जाती हैं उनमें तो वे 128 बाइट और वह निशान भी नहीं होते। वे बस नंगा डेटा होती हैं जिसके आगे कुछ नहीं होता, और पढ़ने वाले को उसकी पहली फ़ील्ड से यह निकालना पड़ता है कि वह किस तरह लिखा गया है। वह सामान्य फ़ाइल है, टूटी हुई नहीं।
विंडो और लेवल, यही वह चीज़ है जो मायने रखती है
यही एक बात है जो किसी मेडिकल तस्वीर को आम तस्वीर से अलग करती है, और यही वजह है कि उसे देखने के लिए इमेज एडिटर काम का नहीं।
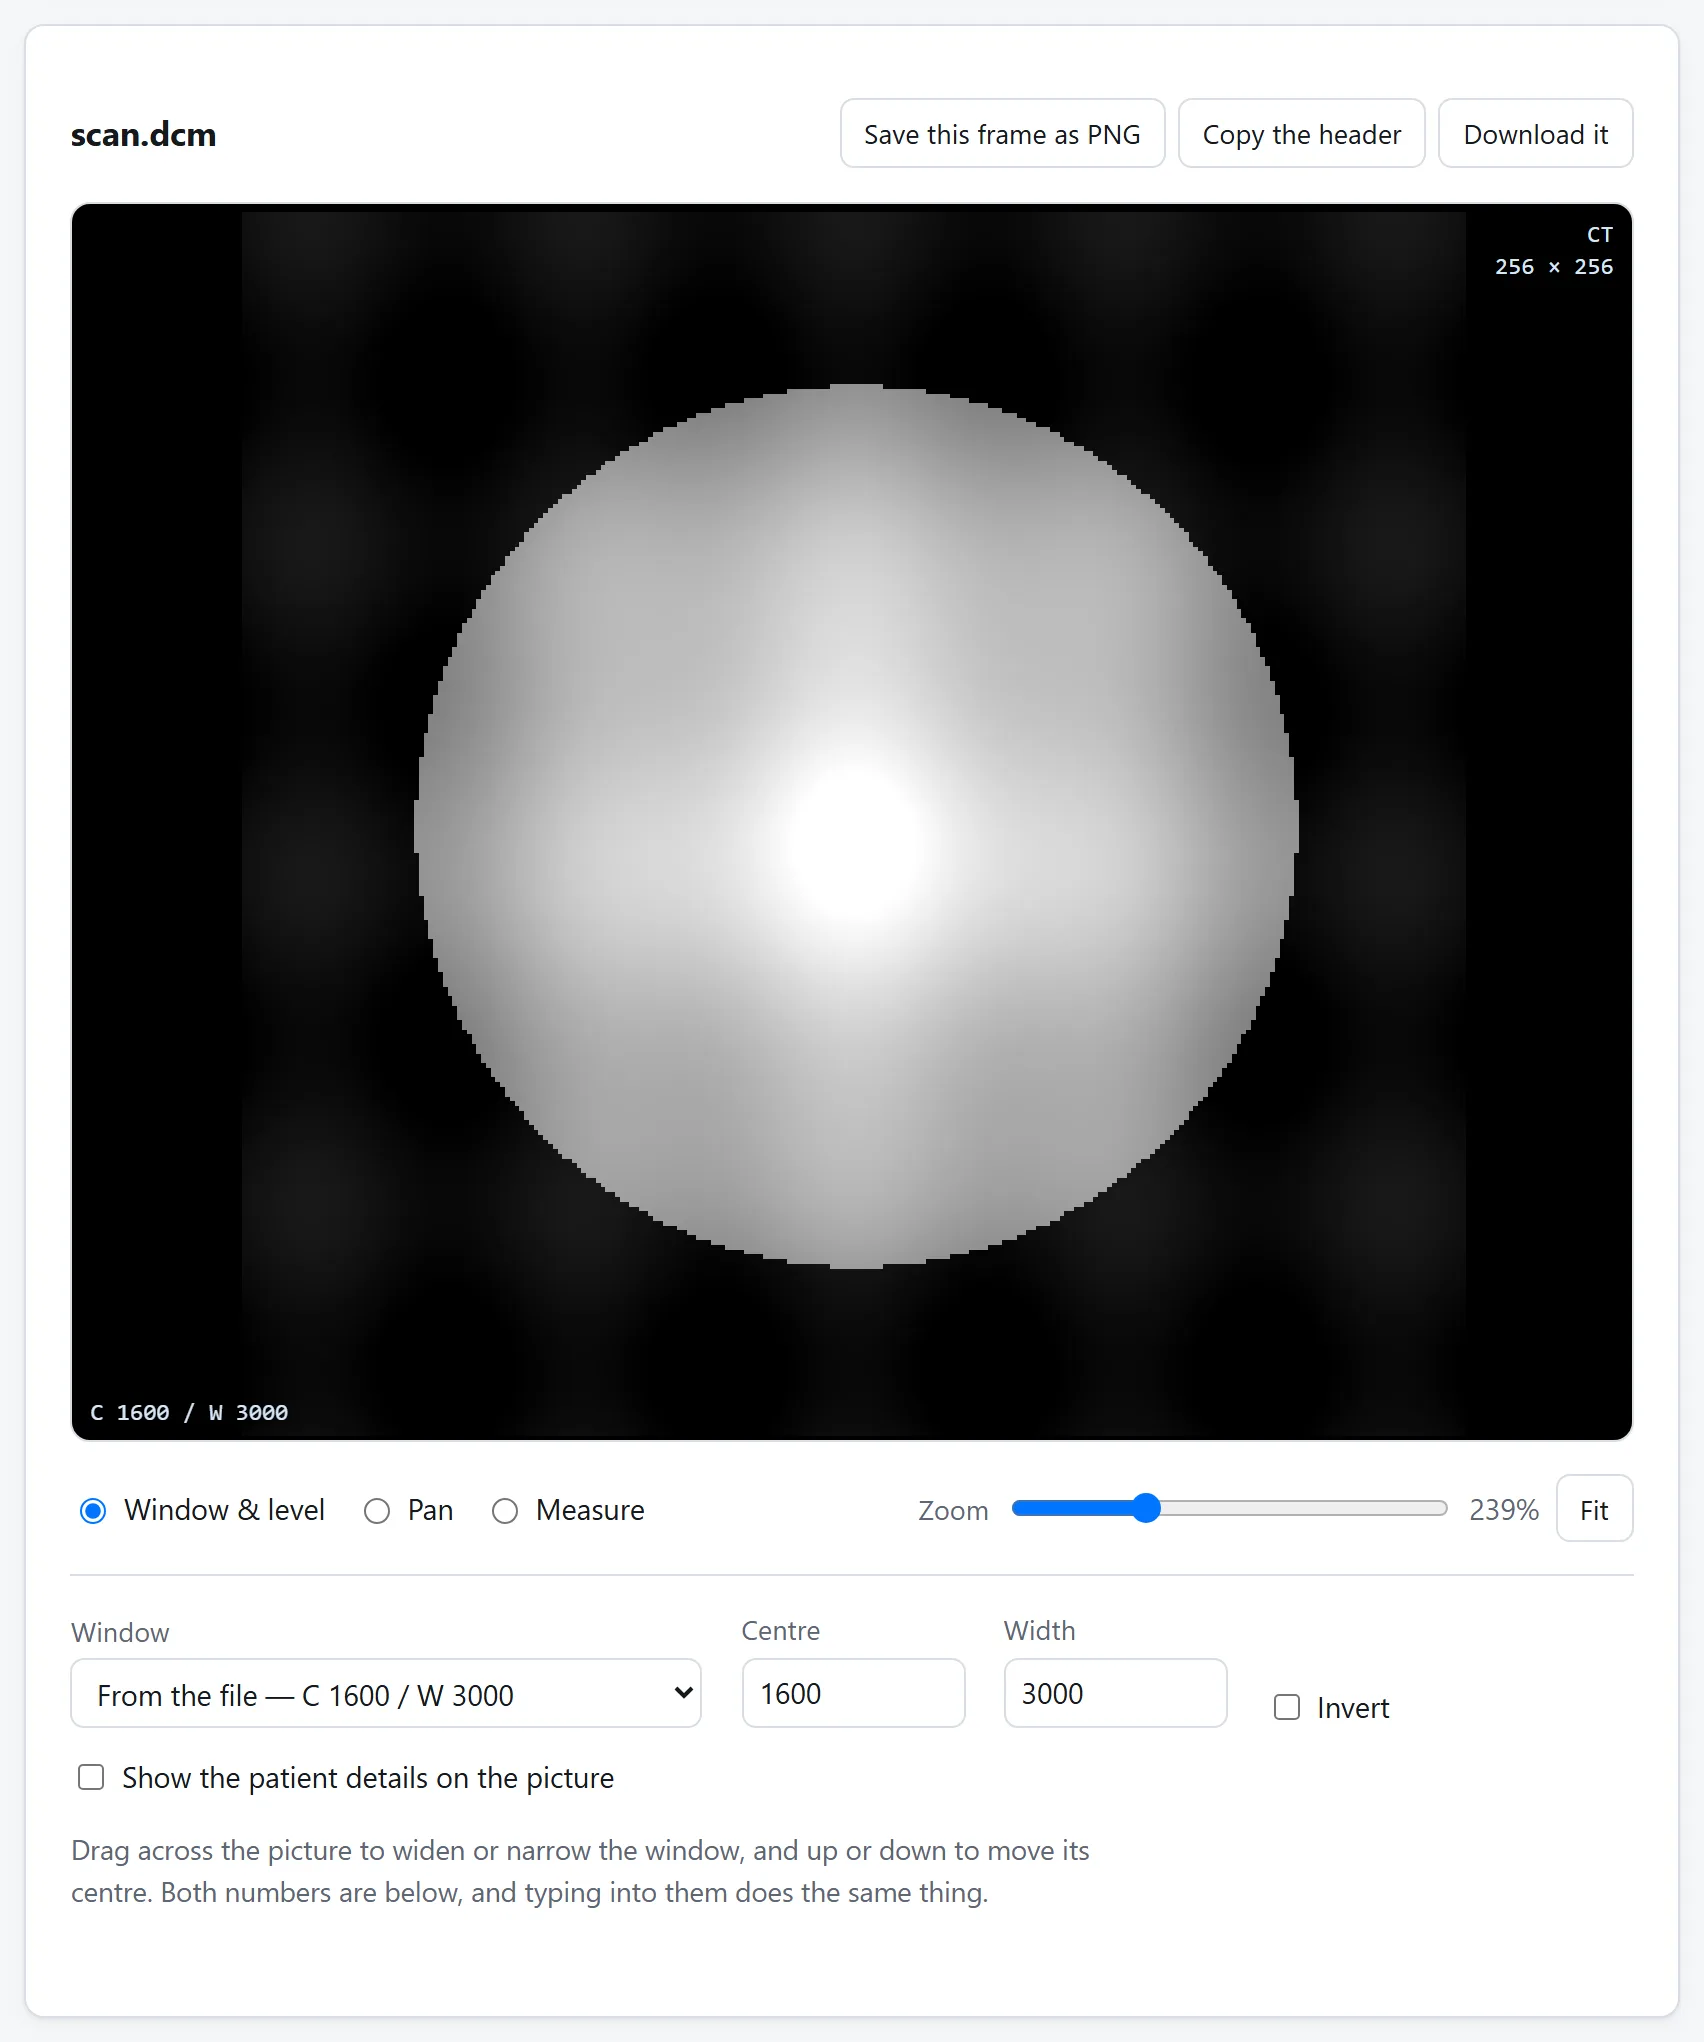
एक CT स्लाइस में करीब चार हज़ार अलग-अलग मान होते हैं। आपकी स्क्रीन दो सौ छप्पन धूसर रंग दिखाती है। किसी को तय करना पड़ता है कि उन चार हज़ार में से कौन-से उन दो सौ छप्पन पर बैठेंगे, और वही फ़ैसला विंडो है। उससे नीचे सब काला, उससे ऊपर सब सफ़ेद, और बीच का दायरा धूसर रंगों में फैला हुआ।
विंडो सरकाइए और वही फ़ाइल किसी दूसरे स्कैन जैसी दिखने लगती है। यह रेंडरिंग की गड़बड़ नहीं है, यही तो बात है। फेफड़ा और हड्डी दोनों उसी स्लाइस में हैं और एक साथ नहीं देखे जा सकते। जो विंडो फूले हुए फेफड़े की बनावट दिखाती है वह हर हड्डी को पूरा सफ़ेद कर देती है, और जो पसली की बारीक जाली दिखाती है वह पूरे फेफड़े को पूरा काला।
CT पर ये संख्याएँ हाउंसफ़ील्ड इकाइयाँ हैं, और वे हर मशीन के लिए अलग नहीं बल्कि पूरी तरह तय हैं। पानी 0 है और हवा −1000, दुनिया की हर CT मशीन पर। इसीलिए कोई व्यूअर नाम वाली विंडो दे सकता है, जैसे फेफड़ा, हड्डी, दिमाग, नरम ऊतक, और वे आपकी फ़ाइल पर भी वही मतलब रखती हैं जो उस वर्कस्टेशन पर जहाँ स्कैन पढ़ा गया था। आम विंडो ये हैं।
- नरम ऊतक — केंद्र 40, चौड़ाई 400।
- फेफड़ा — केंद्र −600, चौड़ाई 1500।
- हड्डी — केंद्र 300, चौड़ाई 1500।
- दिमाग — केंद्र 40, चौड़ाई 80। यह सँकरी है, क्योंकि धूसर और सफ़ेद पदार्थ में बस कुछ ही इकाइयों का फ़र्क होता है।
MRI पर ऐसा कोई पैमाना नहीं होता। मान सीक्वेंस, कॉइल और मशीन पर निर्भर करते हैं, इसलिए किसी प्रीसेट को कोई नाम देने का आधार ही नहीं बनता, और जिस विंडो से शुरुआत होती है वह वही है जो फ़ाइल खुद माँगती है। हर स्कैन एक सुझाव लिए चलता है।
स्लाइस कभी-कभी उलटी तरफ़ क्यों चलती हैं
व्यूअर को तय करना पड़ता है कि फ़ाइलें किस क्रम में रखे, और फ़ाइल के भीतर दो चीज़ें हैं जिनका वह इस्तेमाल कर सकता है।
Instance Number एक गिनती है। यह सीधा-सा चुनाव है और इसे वही चीज़ देती है जिसने फ़ाइलें लिखीं, और ज़रूरी नहीं कि वह उन्हें उसी दिशा में गिने जिस दिशा में मरीज़ लेटा है। जो जाँच पैरों से ऊपर की ओर बनाई गई हो और सिर से नीचे की ओर गिनी गई हो वह उलटी चलती है, और दो पुनर्रचनाओं से जोड़ी गई सीरीज़ में तो नंबर सीधे दोहरा भी सकते हैं।
Image Position (Patient) बताता है कि स्लाइस भौतिक रूप से कहाँ है, मिलीमीटर में, और वह भी उस निर्देशांक व्यवस्था में जो मशीन से नहीं बल्कि मरीज़ से बँधी है। उसी से क्रम लगाना सही है, चाहे गिनती ने कुछ भी किया हो, और उसका एक काम का फ़ायदा भी है। एक बार स्लाइस भौतिक क्रम में आ जाएँ तो उनके बीच की दूरी नापी जा सकती है, इसलिए कोई व्यूअर बता सकता है कि स्लाइस 5 mm की दूरी पर हैं, और यह भी भाँप सकता है कि कोई एक गायब है, जो फ़ाइल कभी नहीं बताती।
कुछ नापना
स्कैन नापा हुआ डेटा है, इसलिए उस पर ली गई लंबाई असली लंबाई होती है, बशर्ते फ़ाइल बताए कि उसके पिक्सल कितनी दूर हैं। यह एक ही फ़ील्ड है, Pixel Spacing, मिलीमीटर में, और लगभग हर CT और MRI में मौजूद रहती है।
अल्ट्रासाउंड की तस्वीरों, स्कैन किए हुए कागज़ों और DICOM में सेव की गई स्क्रीन तस्वीरों में यह अक्सर नहीं होती। जहाँ वह न हो वहाँ मिलीमीटर में कोई ईमानदार जवाब है ही नहीं, और जो व्यूअर फिर भी एक जवाब दे देता है उसने कोई पैमाना गढ़ लिया है। पिक्सल की गिनती उस सवाल का सही जवाब है जिसका जवाब फ़ाइल दे ही नहीं सकती।
उन पिक्सलों का भी ध्यान रखिए जो वर्गाकार नहीं होते, जो CT के बाहर आम बात है। पिक्सल में नापकर एक ही दूरी से गुणा करना सिर्फ़ वहीं सही है जहाँ दोनों बराबर हों, और हर अक्ष को उसकी अपनी दूरी से नापना चाहिए।
स्कैन तस्वीर के अलावा और क्या लिए चलता है
यही वह हिस्सा है जिसके बारे में लोग गलत होते हैं, और इन फ़ाइलों को लेकर सावधान रहने की वजह भी यही है।
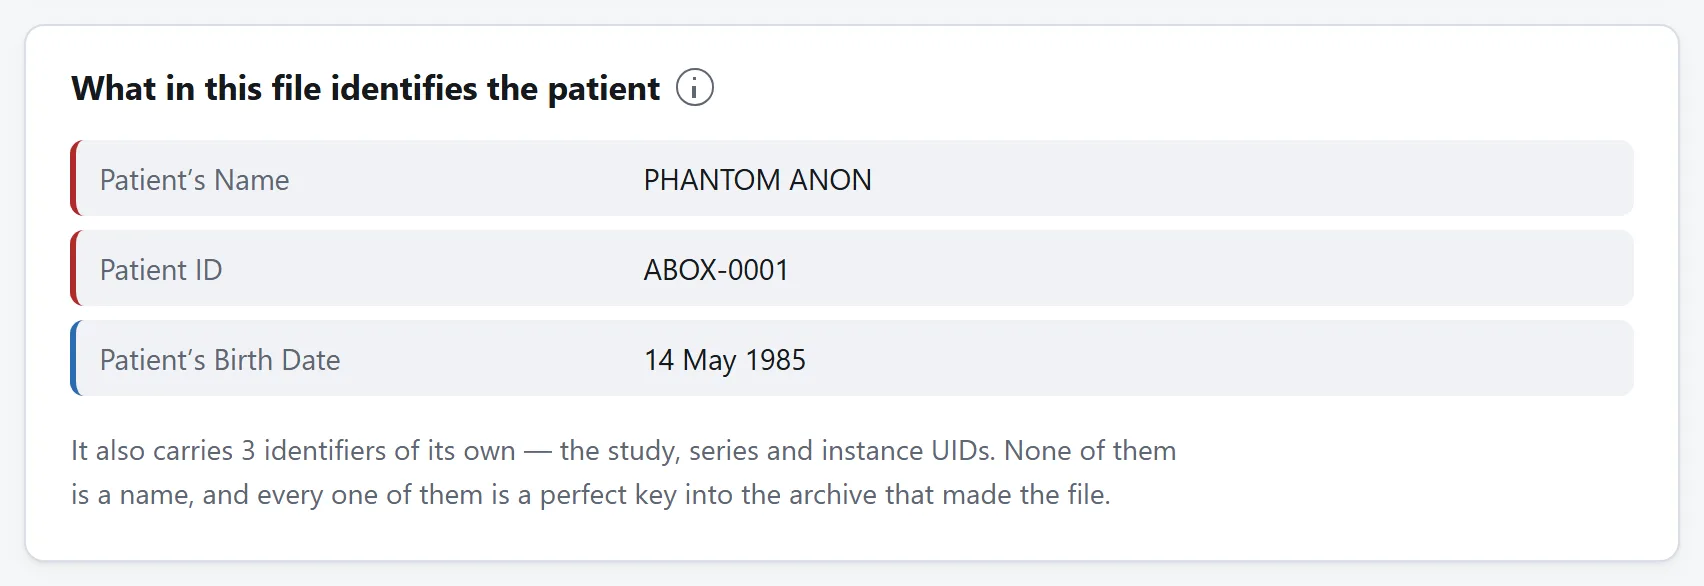
DICOM फ़ाइल मेटाडेटा लगी हुई तस्वीर नहीं है। वह तस्वीर वाला मेडिकल रिकॉर्ड है। हेडर फ़ील्डों की एक सूची है, और किसी आम क्लिनिकल स्कैन में उसमें ये सब होता है।
- मरीज़ का नाम, अस्पताल का नंबर, जन्म तारीख और लिंग;
- वह रेफ़रेंस नंबर जो अस्पताल के सिस्टम में उस अनुरोध की कुंजी है;
- रेफ़र करने वाला डॉक्टर, जाँच करने वाला तकनीशियन, रिपोर्ट लिखने वाला रेडियोलॉजिस्ट;
- संस्थान, उसका पता और विभाग;
- मशीन बनाने वाली कंपनी, मॉडल और सीरियल नंबर;
- सेकंड तक की तारीख और समय;
- और जाँच, सीरीज़ व इंस्टेंस के अनूठे पहचान-चिह्न, जो उस आर्काइव तक लौटने की एकदम सटीक कुंजी हैं जहाँ से यह फ़ाइल आई।
आपको जो भी फ़ाइल मिली है वह यह सब लिए चलती है, और यह सब फ़ाइल के साथ हर जगह जाता है। नाम मिटा देना काफ़ी नहीं है। जन्म तारीख, पिन कोड जितने बड़े इलाके का संस्थान और जाँच का समय मिलकर किसी इंसान को लगभग उतना ही पहचान लेते हैं जितना नाम, और जाँच का UID तो आर्काइव तक पहुँच रखने वाले किसी भी इंसान के लिए उसे ठीक-ठीक पहचान देता है।
कुछ मशीनें मरीज़ के नाम की दूसरी कॉपी किसी प्राइवेट फ़ील्ड में भी रख देती हैं, यानी ऐसी फ़ील्ड में जिसका मतलब कहीं छपा नहीं है और जिसे ज़्यादातर गुमनाम करने वाले टूल छूते ही नहीं, क्योंकि उन्हें पता ही नहीं चल सकता कि उसमें क्या है।
देखने भर के लिए स्कैन अपलोड मत कीजिए
यह मुश्किल आम तौर पर ‘dicom viewer online’ की खोज और एक अपलोड डिब्बे से हल की जाती है। और तब जो अभी-अभी हुआ वह यह है कि किसी अजनबी के पास एक मेडिकल रिकॉर्ड की कॉपी पहुँच गई, यानी पिक्सल, नाम, जन्म तारीख, अस्पताल का नंबर, और आर्काइव तक लौटने की कुंजी।
इसकी कोई वजह नहीं है। DICOM फ़ाइल पढ़ने का मतलब है एक हेडर को समझना और कुछ पूर्णांक खोल लेना, और ब्राउज़र यह बखूबी करता है। इसीलिए यहाँ वाले व्यूअर में नेटवर्क का कोई काम है ही नहीं। न fetch, न XMLHttpRequest, और ऐसा कुछ भी नहीं जो कोशिश करने पर भी फ़ाइल भेज सके। पेज एक बार लोड कीजिए, इंटरनेट बंद कर दीजिए, और यह स्कैन खोलता रहेगा।
क्या ऑनलाइन कन्वर्टर पर फ़ाइलें अपलोड करना सुरक्षित है? बताता है कि इस दावे को इस साइट पर या किसी और साइट पर कैसे जाँचा जाए। यही वह फ़ाइल है जिस पर जाँचना सबसे ज़्यादा ज़रूरी है।
ब्राउज़र क्या नहीं कर सकता
दो बातें, और दोनों साफ़ कह देने लायक हैं।
यह डायग्नोस्टिक व्यूअर नहीं है। आपकी स्क्रीन कैलिब्रेट नहीं है, ब्राउज़र कोई प्रमाणित रेंडरिंग चेन नहीं है, और कोई भी वेब पेज किसी नियामक जाँच से नहीं गुज़रा है। किसी क्लिनिकल फ़ैसले के लिए स्कैन पढ़ना उसी वर्कस्टेशन का काम है जिस पर उसकी रिपोर्ट बनी। डिस्क में क्या है यह देखना, किसी लेक्चर या पर्चे के लिए एक स्लाइस निकालना, हेडर पढ़ना, या यह पता करना कि कोई दूसरा प्रोग्राम इस फ़ाइल को क्यों मना कर रहा है, ये सब ब्राउज़र में स्कैन खोलने की बिलकुल ठीक वजहें हैं।
कुछ कंप्रेस किए हुए स्कैन डीकोड नहीं होंगे। DICOM कई कंप्रेशन योजनाओं की इजाज़त देता है और ब्राउज़र उनमें से एक को लागू करते हैं। सादी फ़ाइलें, run-length में लिखी फ़ाइलें, baseline JPEG और JPEG Lossless, जो ज़्यादातर अस्पताली एक्सपोर्ट में होता है, ये सब खुल जाते हैं। JPEG 2000, JPEG-LS और वीडियो वाले फ़ॉर्मैट ऐसे कोडेक माँगते हैं जो कई मेगाबाइट की कंपाइल की हुई लाइब्रेरी होते हैं। जहाँ तस्वीर डीकोड नहीं हो पाती वहाँ भी हेडर पूरा का पूरा पढ़ा जा सकता है, और आम तौर पर आप जिसके लिए आए थे वह आधा हिस्सा वही होता है।